
MySQL Buffer Pool 怎么在重启后预热常用页
MySQL 重启后想尽快恢复常用数据页,可以启用 InnoDB Buffer Pool 状态保存与恢复:关闭时记录最近使用页的表空间 ID 和页 ID,启动时由后台线程根据这些定位信息重新读取数据页。它不会把整个 Buffer Pool 原样写到磁盘,也不会阻塞数据库完成启动。
我以前遇到过一类很典型的现象:服务重启本身很顺利,但刚恢复流量时,查询延迟和磁盘读取明显高于稳定期。最初我用脚本反复跑几条 SQL“暖库”,结果既难覆盖真实热点,也容易把一次性报表页带进缓存。后来改成 InnoDB 自带的状态保存与恢复,排查思路才变得清楚:先确认有没有可加载的页清单,再观察后台加载是否完成。
官方文档:https://dev.mysql.com/doc/refman/8.4/en/innodb-preload-buffer-pool.html
先判断是不是 Buffer Pool 冷启动
“重启后慢”不一定都由 Buffer Pool 引起。先把现象限定在以下范围:MySQL 已经正常接受连接,执行计划没有突然变化,锁等待和连接数也没有异常,但相同业务查询第一次读取较慢,随后逐步恢复。如果慢查询始终不恢复,或只集中在某一条 SQL,就应继续检查索引、统计信息、锁和存储延迟,而不是只调预热参数。
Buffer Pool 状态恢复解决的是重启后的暖机期。它根据停机前的最近使用页重建一部分缓存,让业务不必完全依赖 DML 首次访问来把页读回内存。官方文档说明加载在后台执行,因此“mysqld 已启动”与“热点页已加载完成”是两个不同状态。
保存的不是内存页,而是页定位信息
状态文件的体积通常远小于 Buffer Pool,因为它保存的是定位页面所需的表空间 ID 与页 ID,而不是页面内容本身。MySQL 8.4 默认把这些信息写入 InnoDB 数据目录下的 ib_buffer_pool 文件,文件名和位置可通过 innodb_buffer_pool_filename 调整。
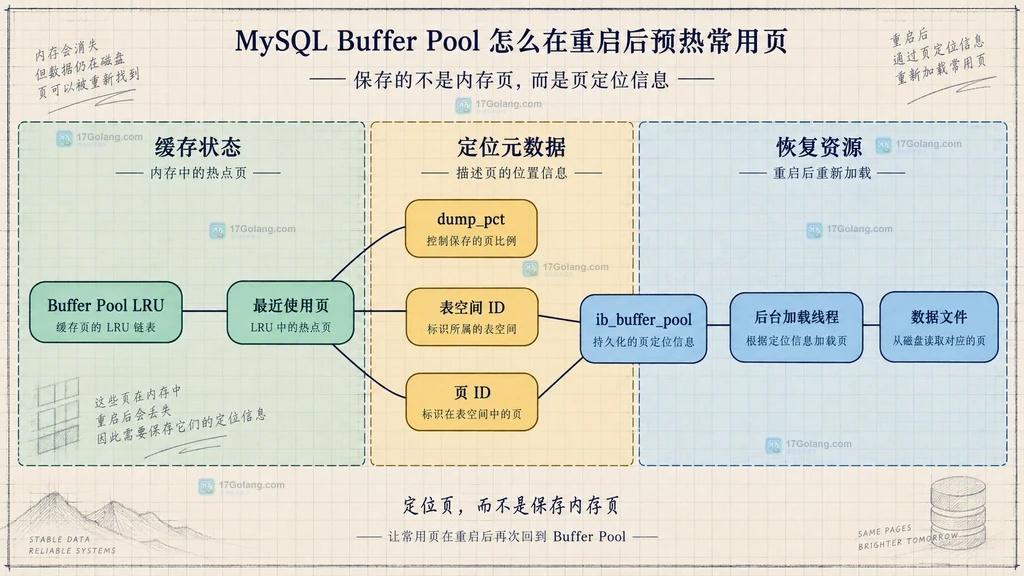
这一点也解释了为什么数据页在停机后发生正常更新并不会让机制失效:恢复时仍从表空间读取当前页面;如果记录指向的页面已经不存在,加载机制会跳过它。对压缩表,页面先以压缩形式加载,真正访问内容时再按正常路径解压。
先核对三个关键配置
MySQL 8.4 中,innodb_buffer_pool_dump_at_shutdown 与 innodb_buffer_pool_load_at_startup 默认启用,innodb_buffer_pool_dump_pct 默认是 25,也就是保存每个 Buffer Pool 最近使用页中的一部分。即便如此,我仍建议在目标实例上显式核对,而不是假设配置文件没有覆盖默认值。
-- 核对关闭时保存、启动时恢复和保存比例。
SHOW VARIABLES LIKE 'innodb_buffer_pool_dump_at_shutdown';
SHOW VARIABLES LIKE 'innodb_buffer_pool_load_at_startup';
SHOW VARIABLES LIKE 'innodb_buffer_pool_dump_pct';

-- 核对状态文件名,便于后续检查数据目录中的文件。
SHOW VARIABLES LIKE 'innodb_buffer_pool_filename';
如果要把策略固定在配置文件中,可以在 mysqld 使用的配置文件里写入:
[mysqld]
# 关闭时保存最近使用页的定位信息。
innodb_buffer_pool_dump_at_shutdown=ON

# 启动后由后台线程恢复已保存的常用页。
innodb_buffer_pool_load_at_startup=ON

# 保存最近使用页的 25%,先从默认比例开始观察。
innodb_buffer_pool_dump_pct=25
我更倾向于先保留 25%,观察重启后的 I/O 与恢复时长,再决定是否提高。比例越高,写入状态文件的定位项越多,启动后的后台读取量也越大;如果停机前刚跑过一次不典型的大报表,提高比例未必会得到更好的业务热点。
稳定负载后手动刷新状态更可控
除了关机和启动阶段,MySQL 还允许在线保存和恢复 Buffer Pool 状态。对我来说,这个能力最有价值的场景不是日常手工预热,而是在业务达到稳定吞吐后重新保存一次热点页清单,避免一次性维护任务污染停机前的 LRU 状态。
-- 在稳定业务负载后,立即保存当前 Buffer Pool 状态。
SET GLOBAL innodb_buffer_pool_dump_now=ON;

-- 等待保存完成后再安排维护或重启。
SHOW STATUS LIKE 'Innodb_buffer_pool_dump_status';

-- 需要在线重新加载已保存状态时再手动触发。
SET GLOBAL innodb_buffer_pool_load_now=ON;

-- 观察后台加载是否开始、进行中或已经完成。
SHOW STATUS LIKE 'Innodb_buffer_pool_load_status';
不要在 dump 还没完成时就假设文件已经可用。Innodb_buffer_pool_dump_status 会返回未开始、进行中或完成信息;加载对应查看 Innodb_buffer_pool_load_status。这些状态比“配置开关是 ON”更接近真实执行证据。
按证据判断预热有没有真的执行
我把检查拆成三层:配置层确认开关与比例,文件层确认 ib_buffer_pool 的位置和可访问性,进度层确认后台任务确实运行。这样遇到“开关明明是 ON,但重启后还是慢”时,不会一开始就把问题归咎于比例太小。
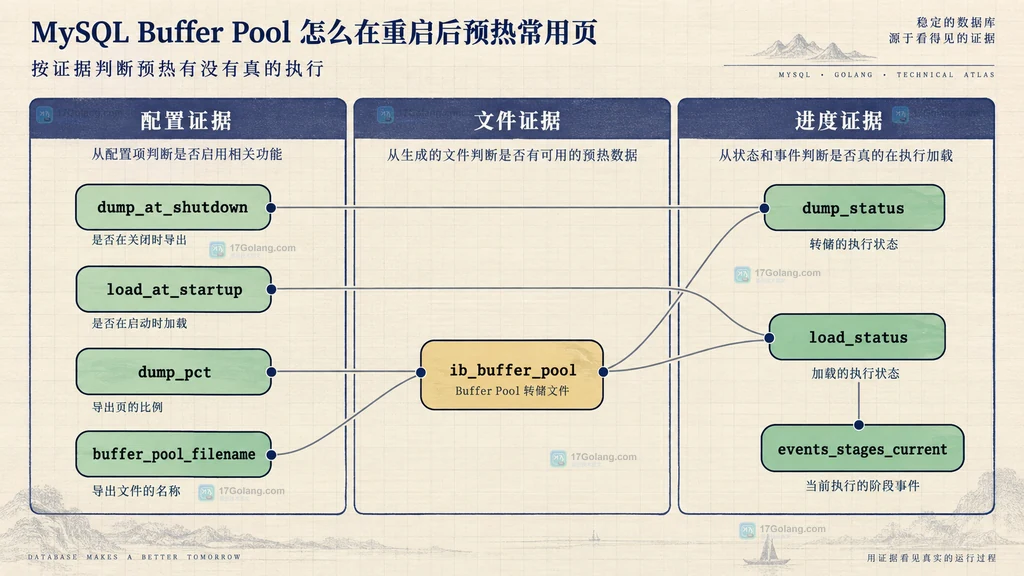
需要更细进度时,可以启用 Performance Schema 的 Buffer Pool Load stage 事件。它提供已完成页数和估算工作量;任务完成后,events_stages_current 可能返回空集,此时查看历史表。
-- 启用 Buffer Pool Load 的阶段事件采集。
UPDATE performance_schema.setup_instruments
SET ENABLED = 'YES'
WHERE NAME LIKE 'stage/innodb/buffer%';

-- 启用阶段事件消费者,保留当前与历史记录。
UPDATE performance_schema.setup_consumers
SET ENABLED = 'YES'
WHERE NAME LIKE '%stages%';

-- 查看正在执行的后台加载进度。
SELECT EVENT_NAME, WORK_COMPLETED, WORK_ESTIMATED
FROM performance_schema.events_stages_current;

-- 当前表为空时,到历史表确认最近一次是否完成。
SELECT EVENT_NAME, WORK_COMPLETED, WORK_ESTIMATED
FROM performance_schema.events_stages_history
WHERE EVENT_NAME = 'stage/innodb/buffer pool load';
预热没有达到预期时怎么反向排查
| 证据 | 可能结论 | 处理动作 |
|---|---|---|
| load_at_startup 为 OFF | 启动时不会自动恢复 | 修改目标实例实际读取的配置并在维护窗口重启 |
| dump_status 未完成 | 页清单尚未稳定写出 | 等待完成后再执行后续维护 |
| 状态文件不存在或不可读 | 文件位置、权限或停机保存有问题 | 核对数据目录、filename 和 mysqld 访问权限 |
| load_status 显示进行中 | 启动完成不等于预热完成 | 结合 I/O 负载等待后台任务推进 |
| 加载完成但热点命中仍低 | 停机前 LRU 不代表当前业务热点 | 在稳定负载后手动 dump,重新评估 dump_pct |
还有一个容易忽略的情况:维护脚本、全表扫描或大型报表会把短期页面带入 LRU。此时预热机制本身可能工作正常,只是保存的“最近使用页”并不是重启后最需要的业务页。与其一味提高比例,我更愿意在稳定业务窗口重新 dump。
最后检查清单
- 确认问题确实是重启后的冷缓存恢复,而不是锁、执行计划或存储故障。
- 核对 dump_at_shutdown、load_at_startup、dump_pct 和 buffer_pool_filename 的实际值。
- 确认 dump_status 已完成,并且状态文件位于 mysqld 可访问的位置。
- 重启后查看 load_status,必要时再启用 Performance Schema stage 进度。
- 加载完成后用业务延迟、磁盘读取和 Buffer Pool 命中趋势判断效果,不只看开关。
- 若热点偏离,先在稳定负载后重新 dump,再谨慎调整保存比例。
这套机制适合希望缩短重启暖机期、又不想维护一套 SQL 预热脚本的 InnoDB 实例。它不是把内存做成持久化快照,也不能替代容量规划和查询优化;它做的是保存一份轻量页清单,让 MySQL 更快找回停机前真正被频繁使用的页。
常见问题
加载 Buffer Pool 会阻塞 MySQL 启动吗?
不会等待所有页面加载完才提供服务。官方文档说明页面由后台线程加载,因此应继续观察 load_status,而不是只看 mysqld 是否已经启动。
ib_buffer_pool 是完整缓存文件吗?
不是。它保存定位页面所需的表空间 ID 与页 ID,真正的数据页仍从表空间读取。
dump_pct 越大越好吗?
不一定。更大的比例意味着更多恢复读取,也更容易包含短期工作负载带来的页面。应结合稳定业务窗口和重启后的实际指标调整。
 Go net.Dialer.ControlContext 怎么设置底层套接字选项
- 上一篇
- Go net.Dialer.ControlContext 怎么设置底层套接字选项
- 下一篇
- Go filepath.IsLocal 与 Clean 有什么区别
-
- 数据库 · MySQL | 3小时前 | MySQL · 性能排查 · mysql prepared statement reprepare Com_stmt_reprepare
- MySQL Prepared statement 为什么会自动重新预编译
- 387浏览 收藏
-
- 数据库 · MySQL | 5小时前 | MySQL · 字符集 · mysql collation Illegal mix of collations COERCIBILITY
- MySQL 字符串比较报 Illegal mix of collations 怎么定位
- 486浏览 收藏
-
- 数据库 · MySQL | 8小时前 | MySQL · mysql 备份恢复 mysqldump GTID_PURGED
- MySQL 导入备份时 GTID_PURGED 冲突怎么处理
- 455浏览 收藏
-
- 数据库 · MySQL | 10小时前 | MySQL ·
- MySQL 多条复制过滤规则按什么顺序生效
- 382浏览 收藏
-
- 数据库 · MySQL | 13小时前 | MySQL · InnoDB · 数据库运维 · mysql 死锁 错误日志 events_statements_history_long data_lock_waits Performance Schema
- MySQL 怎么从 Performance Schema 汇总近期死锁
- 372浏览 收藏
-
- 数据库 · MySQL | 20小时前 |
- MySQL CTE 什么时候会物化而不是合并
- 352浏览 收藏
-
- 数据库 · MySQL | 1天前 | 查询优化 · 统计信息 · mysql 直方图 重新采样 ANALYZE TABLE
- MySQL 直方图过期后怎么重新采样
- 441浏览 收藏
-
- 数据库 · MySQL | 1天前 |
- MySQL Skip Scan 什么时候会被优化器采用
- 413浏览 收藏
-
- 数据库 · MySQL | 1天前 | MySQL · 索引优化 · mysql explain 不可见索引 optimizer_switch use_invisible_indexes
- MySQL optimizer_switch 控制 use_invisible_indexes 的测试方案
- 283浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 333次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 391次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 386次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 353次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 176次使用
-
- MySQL JSON_TABLE 展开数组时如何保留缺失字段
- 2026-09-10 501浏览
-
- MySQL 分区表怎么处理跨分区唯一键:分区列约束与建表取舍
- 2026-08-30 501浏览
-
- MySQL权限管理设置全攻略
- 2026-03-29 501浏览
-
- MySQL分片实现方法及常见方案解析
- 2025-06-24 501浏览
-
- MySQL表空间碎片怎么清理?超详细优化教程
- 2025-06-13 501浏览


