
Python zipfile.Path 怎么像目录一样遍历压缩包
如果 ZIP 内部有多层目录,直接调用 ZipFile.namelist() 只能拿到一串字符串;想像操作目录一样逐层判断和读取,可以使用 zipfile.Path。它从 Python 3.8 开始提供类似 pathlib.Path 的遍历接口,核心写法是:用 ZipFile 打开归档,用 zipfile.Path 指向根目录,再用 iterdir() 和 / 访问子项。
zipfile.Path(archive)表示 ZIP 根目录,root / "data"表示内部子路径。iterdir()只枚举当前目录的直接子项,递归时要用is_dir()和is_file()分流。zipfile.Path方便浏览,但不负责清理不可信成员名;安全校验仍由调用方承担。
先把 ZIP 根目录变成可遍历的 Path
最小示例不需要先解压。ZipFile 负责保持归档打开,zipfile.Path 把归档根部包装成可组合的路径对象。下面的代码只读取 docs 目录下的文本文件,代码中的输出是为了说明判断关系,不代表某个本机归档的实际结果。
from zipfile import ZipFile, Path

with ZipFile("archive.zip") as archive:
    root = Path(archive)
    docs = root / "docs"

    # iterdir 只查看当前目录的直接子项,不会自动递归。
    for item in docs.iterdir():
        if item.is_file():
            print(item.name)
            # 文本文件使用显式编码,避免依赖运行环境默认编码。
            with item.open("r", encoding="utf-8") as stream:
                preview = stream.readline().rstrip()
                print(preview)
这里的 root / "docs" 拼接的是 ZIP 内部名称,不是当前操作系统的真实目录。item.open() 会通过归档对象打开成员,离开外层 with 后 ZIP 也会关闭,资源生命周期比较清楚。
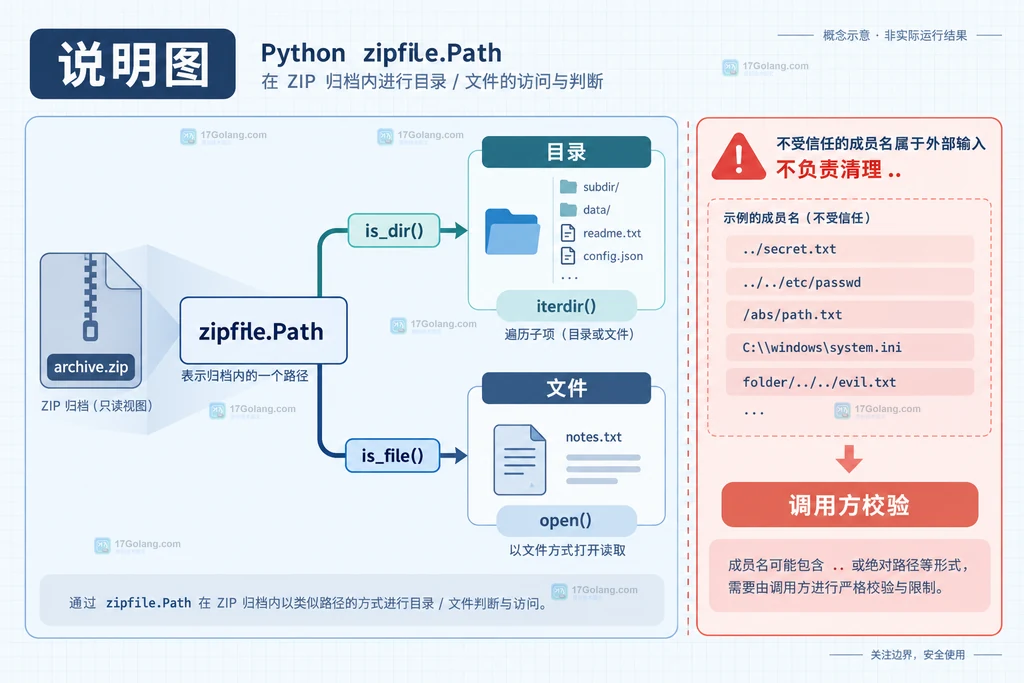
递归遍历时要把目录、文件和安全边界分开
递归函数的关键不是把所有条目都当成文件读取,而是先判断当前对象。目录继续调用 iterdir(),普通文件才进入读取分支。这样既能处理嵌套目录,也不会因为对目录调用 open() 而得到难以定位的异常。
from zipfile import ZipFile, Path

def walk_zip(node: Path, prefix: str = ""):
    """递归打印 ZIP 内部相对路径;只读,不把成员释放到磁盘。"""
    for child in node.iterdir():
        relative_name = f"{prefix}{child.name}"
        if child.is_dir():
            # 目录只负责继续向下走,避免把目录误传给 read_text。
            yield from walk_zip(child, relative_name + "/")
        elif child.is_file():
            # 文件才读取内容;大文件应改成分块读取或只读元信息。
            yield relative_name, child

with ZipFile("archive.zip") as archive:
    for name, file_path in walk_zip(Path(archive)):
        print(name)
        if file_path.suffix == ".txt":
            # 小型文本可直接读取;编码按归档约定调整。
            text = file_path.read_text(encoding="utf-8")
            print(text[:80])
suffix、name 和 stem 适合做轻量筛选;如果目标只是判断是否存在,可以先调用 exists(),不必立即读取全部内容。
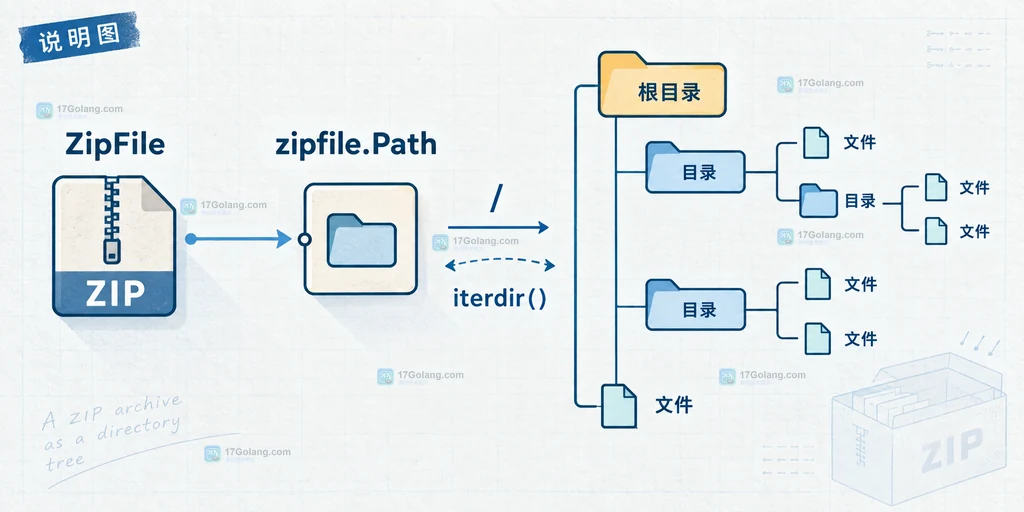
参数和边界要先记清楚
| 对象或方法 | 适合做什么 | 容易忽略的边界 |
|---|---|---|
Path(archive) | 指向 ZIP 根目录 | 不是本地文件系统目录,不能直接交给所有 pathlib API |
iterdir() | 枚举当前目录的直接子项 | 不会自动递归,空目录可能没有子项 |
open()/read_text() | 读取归档成员 | 文本编码要明确,大文件不宜一次读入内存 |
is_dir()/is_file() | 决定遍历或读取分支 | 先判断类型再操作,避免把目录当文件 |
还要特别注意安全责任:官方文档明确指出,zipfile.Path 不会像 extract() 或 extractall() 那样替调用方清理绝对路径和 ..。如果后续代码要把成员名映射到磁盘、拼接输出目录或执行导出,应先做路径规范化和目标目录约束;只在 ZIP 内浏览时,也不要把成员名直接当作可信路径。
常见问题
zipfile.Path 能替代 ZipFile.namelist() 吗?
两者用途不同。namelist() 适合一次拿到成员名列表,Path 更适合按目录层级筛选、判断类型和读取指定成员。
为什么 iterdir() 没有把所有子目录都列出来?
它只枚举当前目录的直接子项。要遍历整个归档,必须在 is_dir() 分支中递归调用,或改用扁平的成员列表处理。
读取中文文本时应该怎么处理编码?
使用 open("r", encoding="utf-8") 或 read_text(encoding="utf-8") 显式指定编码;如果归档来源不固定,应把编码策略作为输入约定,而不是盲目依赖默认值。
实际使用时可以把判断顺序固定为“打开归档、定位根 Path、枚举当前层、区分目录和文件、最后读取”。这样 zipfile.Path 的便利性不会掩盖 ZIP 内部路径与本地路径之间的差异。
 Go os.DirFS 为什么不保证阻止符号链接逃逸
- 上一篇
- Go os.DirFS 为什么不保证阻止符号链接逃逸
- 下一篇
- Go bits.Add64 怎么实现多字长整数加法
-
- 文章 · python教程 | 3小时前 | 内存优化 · Python教程 · Python 大数组 PickleBuffer pickle协议5
- Python PickleBuffer 怎么减少大数组复制
- 207浏览 收藏
-
- 文章 · python教程 | 5小时前 | 标准库 · Python教程 · Python Traversable importlib.resources zipimport
- Python importlib.resources.files 怎么访问压缩包内资源
- 143浏览 收藏
-
- 文章 · python教程 | 8小时前 | 标准库 · python · 进程管理 · Python subprocess.Popen pipesize
- Python subprocess.Popen pipesize 什么时候有效
- 187浏览 收藏
-
- 文章 · python教程 | 13小时前 | python · 异步编程 · Python 资源清理 异步生成器 contextlib aclosing
- Python contextlib.aclosing 怎么确保异步生成器退出
- 369浏览 收藏
-
- 文章 · python教程 | 15小时前 | python · Python decimal tomllib parse_float
- Python tomllib.loads 怎么自定义浮点数类型
- 158浏览 收藏
-
- 文章 · python教程 | 22小时前 |
- Python runtime_checkable Protocol 为什么只检查属性存在
- 410浏览 收藏
-
- 文章 · python教程 | 1天前 | 协程 · 超时控制 · python · asyncio · Python 异步超时 asyncio.timeout reschedule
- Python asyncio.timeout 怎么动态调整截止时间
- 403浏览 收藏
-
- 文章 · python教程 | 1天前 | python · Python setup.py pyproject.toml packaging
- Python packaging 从 setup.py 迁移 pyproject.toml 的清单
- 236浏览 收藏
-
- 文章 · python教程 | 1天前 | python ·
- Python multiprocessing shared_memory 管理共享缓冲区
- 218浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 331次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 390次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 384次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 352次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 176次使用
-
- go格式“占位符”输入输出 类似python的input
- 2023-01-19 346浏览
-
- Golang如何调用Python代码详解
- 2023-01-07 235浏览
-
- Go filepath.WalkDir 如何跳过隐藏目录:SkipDir、DirEntry 与遍历剪枝
- 2026-08-30 158浏览
-
- Go filepath.WalkDir 怎么跳过隐藏目录并继续遍历
- 2026-09-07 479浏览
-
- Go archive/zip 写入目录条目时怎么避免路径混乱
- 2026-09-09 493浏览


