
Go big.Int.SetBytes 为什么只按无符号数解释
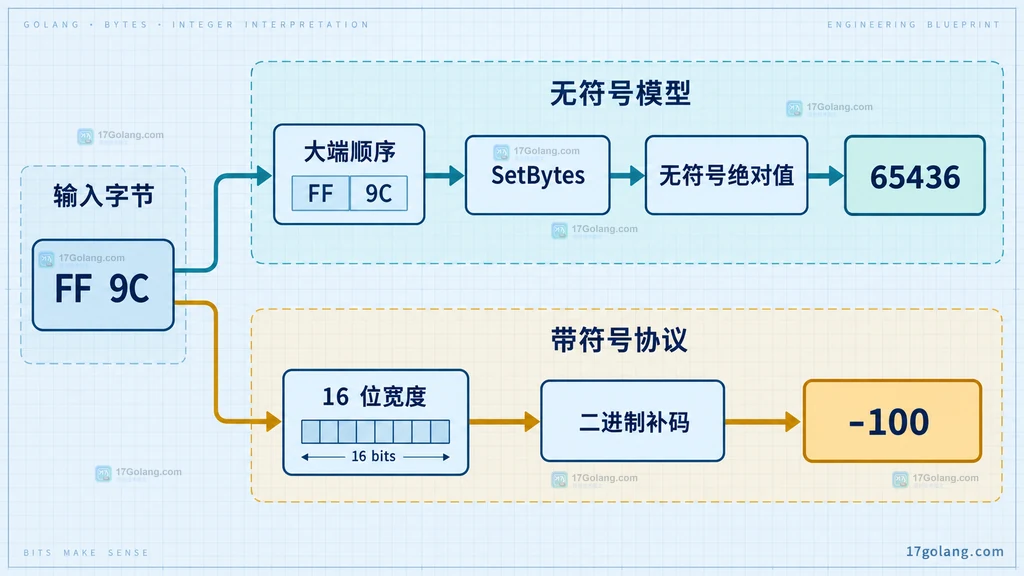
因为 big.Int.SetBytes 的输入契约不是“带符号整数的序列化格式”,而是“无符号大端整数的字节”。它把整段字节都当作绝对值,即使最高位是 1,也不会自动解释成负数。比如 FF 9C 会得到 65436,而不是 16 位二进制补码里的 -100。
标准库文档:https://pkg.go.dev/math/big#Int.SetBytes
真正的修复不应是看到最高位就随手调用 Neg,而是先确认上游协议采用无符号、独立符号字段,还是固定宽度二进制补码。编码规则不同,得到的数值就不同。
SetBytes固定按无符号大端整数解释输入。Bytes和FillBytes输出的也是绝对值,不携带负号。- 二进制补码必须知道字段宽度;最高位为 1 时,用无符号值减去
2^(8×字节数)。 - 生产解码器要限制长度、校验固定宽度,并为边界值准备测试向量。
FF 9C 为什么得到 65436
一次协议接入中,上游说明字段是“16 位有符号大端整数”,样例字节为 FF 9C。直接交给 SetBytes 后,日志却出现 65436:
package main

import (
    "fmt"
    "math/big"
)

func main() {
    raw := []byte{0xff, 0x9c}

    // SetBytes 按无符号大端值解释:0xFF9C = 65436。
    value := new(big.Int).SetBytes(raw)
    fmt.Println(value) // 65436
}
这个结果没有溢出,也不是 math/big 忽略了 Int 的符号能力。big.Int 本身当然能表示负数,但 SetBytes 只负责从“无符号绝对值”构造它。符号信息必须来自别处。
SetBytes 与 Bytes 传递的是绝对值
官方文档把 SetBytes 定义为“大端无符号整数”的解码;对应地,Bytes 返回 Int 绝对值的大端字节,FillBytes 也是把绝对值零扩展到固定缓冲区。也就是说,这组三个 API 天然适合模数、ID、计数器、哈希片段等非负数据,不承担带符号协议的编码约定。
func showMagnitude() {
    negative := big.NewInt(-100)

    // Bytes 只返回绝对值 100,因此输出中没有负号信息。
    magnitude := negative.Bytes()
    fmt.Printf("%x\n", magnitude) // 64

    // 再用 SetBytes 读回时只能得到正数 100。
    restored := new(big.Int).SetBytes(magnitude)
    fmt.Println(restored) // 100
}
这种设计避免了歧义:同一个字节 80,在无符号格式中是 128,在 8 位补码中是 -128,在 16 位补码中若写成 00 80 又是 128。没有协议宽度和符号规则,标准库不可能替调用方猜出唯一答案。
先确认协议,再选择解码方式
| 字段约定 | 推荐实现 | 符号来源 |
|---|---|---|
| 无符号大端整数 | new(big.Int).SetBytes(buf) | 不允许负数 |
| 符号字段 + 绝对值 | SetBytes 后按符号调用 Neg | 独立布尔值或枚举 |
| 固定宽度二进制补码 | 先 SetBytes,负值再减 2^N | 固定宽度最高位 |
| 带正负号文本 | SetString(text, base) | 文本中的 +/- |
如果协议把符号单独存储,逻辑很简单,但要避免制造“负零”这种上游语义差异:
func decodeSignMagnitude(magnitude []byte, negative bool) *big.Int {
    value := new(big.Int).SetBytes(magnitude)
    // big.Int 没有负零;数值为零时保持规范化的 0。
    if negative && value.Sign() != 0 {
        value.Neg(value)
    }
    return value
}
固定宽度补码的安全解码器
对长度为 n 字节的二进制补码,位宽是 8n。最高位为 0 时,无符号值就是最终值;最高位为 1 时,最终值等于无符号值减去 2^(8n)。生产实现还应限制字节数,避免攻击者提交超大整数消耗内存和 CPU:
package signedbig

import (
    "errors"
    "fmt"
    "math/big"
)

const maxIntegerBytes = 4096

func DecodeTwosComplementBE(buf []byte, expectedBytes int) (*big.Int, error) {
    if expectedBytes  maxIntegerBytes {
        return nil, fmt.Errorf("integer field too large: %d bytes", len(buf))
    }

    value := new(big.Int).SetBytes(buf)
    if buf[0]&0x80 == 0 {
        // 最高位为 0,补码与无符号值相同。
        return value, nil
    }

    // 最高位为 1:value - 2^(8*len(buf)) 得到负数。
    modulus := new(big.Int).Lsh(big.NewInt(1), uint(8*len(buf)))
    return value.Sub(value, modulus), nil
}
对 FF 9C,SetBytes 先得到 65436;两字节模数是 65536;相减正好得到 -100。这里不能把最高位清零后再取负,那会得到错误的符号-数值结果。
宽度、长度和权限边界
企业协议解析最容易出问题的不是算式,而是边界契约。解码器应由字段定义传入固定宽度,不能让请求自行声明一个无限大的长度;缓冲区在进入 math/big 前完成上限检查;编码类型应使用明确枚举,而不是根据内容猜测。
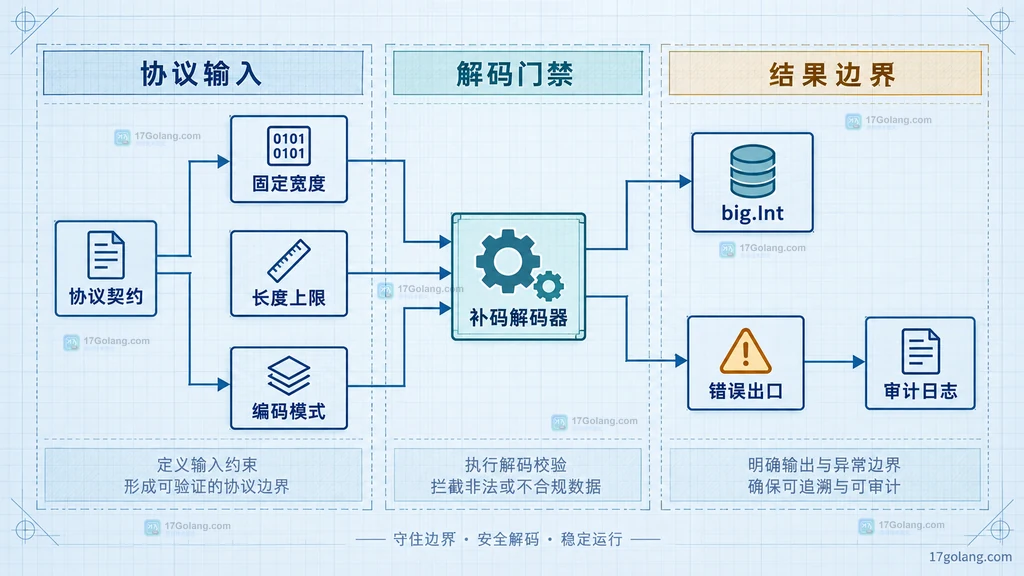
如果这些整数进入密码学路径,还要注意 math/big 官方文档对时序侧信道的提醒:普通 Int 运算不适合直接承担攻击者可控的密码学实现。协议解析可以使用它,但密码算法应优先使用标准库或经过审查的专用实现。
日志只记录判断证据
排查时不必把整段原始数据写入日志。记录字段名、编码模式、实际长度、期望长度、首字节和最终符号通常就够了;可能含密钥、账号或业务敏感值时,不记录完整整数。
func decodeAndAudit(buf []byte, width int, logf func(string, ...any)) (*big.Int, error) {
    value, err := DecodeTwosComplementBE(buf, width)
    if err != nil {
        // 只记录尺寸和错误,不泄露完整负载。
        logf("signed integer rejected: bytes=%d width=%d err=%v", len(buf), width, err)
        return nil, err
    }
    logf("signed integer accepted: bytes=%d width=%d sign=%d", len(buf), width, value.Sign())
    return value, nil
}
用测试向量锁住结果
发布前至少覆盖零、最大正数、最小负数、-1、普通负数、宽度错误和超长输入。测试向量应来自协议规范,而不是只根据当前实现反推:
func TestDecodeTwosComplementBE(t *testing.T) {
    tests := []struct {
        name string
        raw  []byte
        want string
    }{
        {"zero", []byte{0x00, 0x00}, "0"},
        {"positive-128", []byte{0x00, 0x80}, "128"},
        {"negative-100", []byte{0xff, 0x9c}, "-100"},
        {"negative-one", []byte{0xff, 0xff}, "-1"},
        {"min-int16", []byte{0x80, 0x00}, "-32768"},
    }

    for _, tt := range tests {
        t.Run(tt.name, func(t *testing.T) {
            // 所有样例都按协议固定为 2 字节大端补码。
            got, err := DecodeTwosComplementBE(tt.raw, 2)
            if err != nil {
                t.Fatal(err)
            }
            if got.String() != tt.want {
                t.Fatalf("got %s, want %s", got, tt.want)
            }
        })
    }
}
发布前检查清单
- 协议文档明确了大端或小端、无符号或补码、固定宽度或变长格式。
- 补码解码在进入
SetBytes前检查空值、长度和最大上限。 - 正数为避免误判,必要时保留前导
00;不要随意裁掉协议宽度。 - 测试覆盖符号边界,并且期望值来自协议样例。
- 日志不打印完整敏感整数;密码学运算不直接依赖普通
math/big路径。
常见问题
直接看最高位再 Neg 可以吗?
不可以用于二进制补码。FF 9C 的补码值是 -100,而把 65436 直接取负会得到 -65436。必须减去当前位宽对应的 2^N。
SetBytes 支持小端吗?
不支持,它固定读取大端。小端协议应先按字段规则转换为大端或自行累积数值,然后再处理符号。
负数调用 Bytes 后还能无损读回吗?
不能只靠 Bytes,因为它返回绝对值。要么另存符号,要么实现并固定一种带符号编码格式。
 Go html/template.Clone 怎么派生不同页面模板
- 上一篇
- Go html/template.Clone 怎么派生不同页面模板
- 下一篇
- Linux user namespace 的 uid_map 怎么配置
-
- Golang · Go问答 | 27分钟前 | 单元测试 · 浮点数 · Go问答 · Go float64 math.Round RoundToEven 浮点数取整 半数舍入
- Go math.Round 遇到半数时为什么远离零取整
- 422浏览 收藏
-
- Golang · Go问答 | 1小时前 | 数据结构 · 标准库 · 工程实践 · Go问答 · Go 浅拷贝 深拷贝 slices.Clone maps.Clone map复制
- Go maps.Clone 为什么仍是浅拷贝
- 131浏览 收藏
-
- Golang · Go问答 | 3小时前 | 标准库 · 错误处理 · IO · Go问答 · 版本迁移 · Go io.Reader io.EOF io.ReadAll ErrUnexpectedEOF ioutil.ReadAll
- Go io.ReadAll 为什么不会把 EOF 当错误返回
- 318浏览 收藏
-
- Golang · Go问答 | 3小时前 | 标准库 · panic · go · IO · Go io.Reader bytes.Buffer io.Writer io.CopyBuffer
- Go io.CopyBuffer 传入零长度缓冲区为什么会 panic
- 428浏览 收藏
-
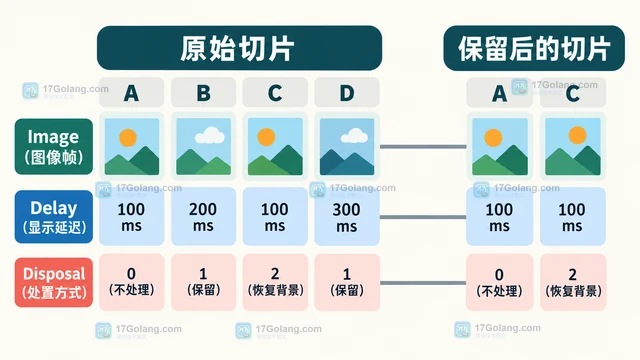
- Golang · Go问答 | 4小时前 | Go问答 · Go image/gif GIF Disposal
- Go gif.GIF.Disposal 长度与图像帧不一致怎么办
- 143浏览 收藏
-
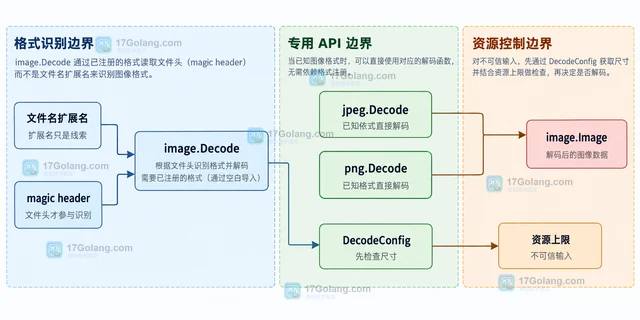
- Golang · Go问答 | 4小时前 | go · Go image.Decode image/png image/jpeg
- Go image.Decode 报 unknown format 为什么需要空白导入
- 189浏览 收藏
-
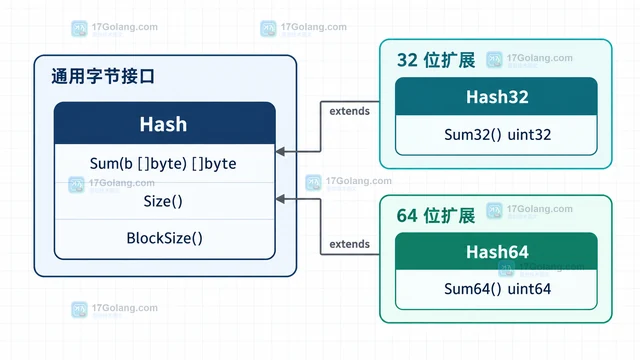
- Golang · Go问答 | 4小时前 | go · sum Go hash.Hash32 hash.Hash64 Sum64
- Go hash.Hash32 与 Hash64 的 Sum 方法为何仍返回字节切片
- 499浏览 收藏
-
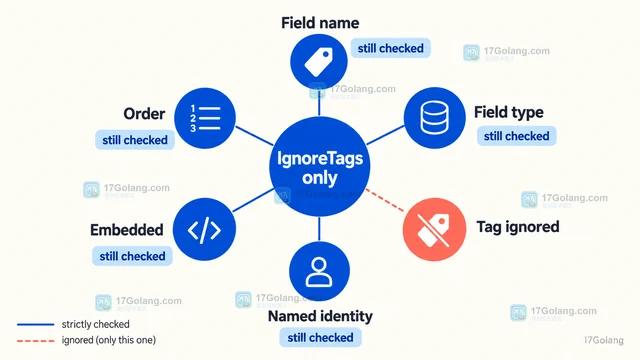
- Golang · Go问答 | 5小时前 | go ·
- Go types.Identical 与 IdenticalIgnoreTags 有什么区别
- 126浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 329次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 386次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 380次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 350次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 173次使用
-
- Go math/big.Int.FillBytes 如何导出固定长度整数:补零规则、溢出判断与协议字段校验
- 2026-08-30 241浏览
-
- Go 分数运算怎么避免中途转换成浮点数
- 2026-09-06 344浏览
-
- Go math/big 怎么精确计算高位数金额比例
- 2026-09-07 379浏览
-
- Go math/big 怎么计算超出 int64 的订单金额
- 2026-09-08 124浏览
-
- Go big.Float 比较结果不稳定时怎么设置精度和舍入
- 2026-09-08 295浏览


