
Go crc32.New 怎么增量计算大文件校验值
我第一次给备份包加 CRC-32 时,最顺手的写法是 os.ReadFile 再调用 crc32.ChecksumIEEE。小文件没问题,文件一大,整份内容同时驻留内存就显得很浪费。更合适的做法是用 crc32.New 创建一个可持续写入的 hash.Hash32,让文件数据分块进入同一个校验状态。
大文件的默认选择是crc32.New(table)配合io.Copy:文件按流读取,内存只保留复制缓冲和 CRC 状态,最后调用Sum32()得到校验值。
官方地址:https://pkg.go.dev/hash/crc32
本文比较四种常见写法:Checksum、New + io.Copy、New + 手动读取 和 Update。重点不是背 API,而是根据数据是否已经在内存、是否需要进度回调、是否要与既有协议对齐来选。
为什么大文件更适合 crc32.New
crc32.Checksum 的参数是完整的 []byte。如果数据本来就在内存里,这个接口非常直接;但如果数据来自数 GB 的文件,为了凑出一个 []byte 先调用 os.ReadFile,内存占用就会跟文件大小一起增长。
crc32.New 返回 hash.Hash32。这个对象同时实现 io.Writer:每次写入一块字节,它都会在已有状态上继续计算。文件可以分成任意大小的块,块的边界不会改变最终 CRC,只要字节顺序和使用的多项式一致。
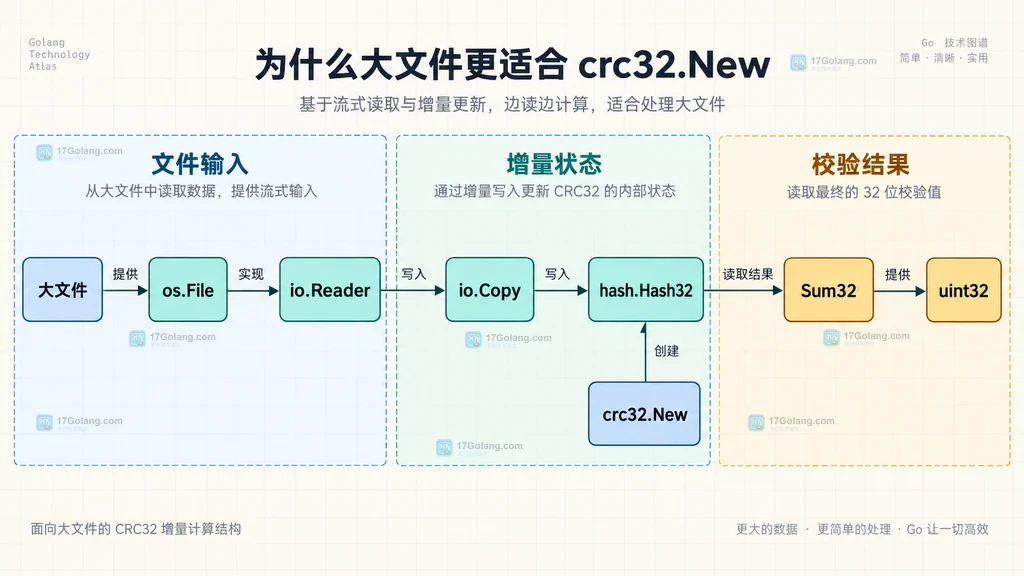
这个模型让我少操心两件事:不用自己管理 EOF,也不用把整个文件拼成一个切片。需要保留的是文件关闭错误边界、复制过程的读取错误,以及对端究竟使用哪张 CRC 表。
默认方案:crc32.New 配合 io.Copy
下面的函数以 CRC-32 IEEE 为例,同时返回校验值和实际读取的字节数。io.Copy 会持续复制到 EOF;正常读完时错误是 nil,文件读取途中失败才会返回错误。
package main

import (
    "fmt"
    "hash/crc32"
    "io"
    "os"
)

func fileCRC32(path string, table *crc32.Table) (uint32, int64, error) {
    file, err := os.Open(path)
    if err != nil {
        return 0, 0, err
    }
    defer file.Close() // 只读校验完成后释放文件描述符

    digest := crc32.New(table)
    size, err := io.Copy(digest, file) // 数据分块进入同一个 CRC 状态
    if err != nil {
        return 0, size, err
    }
    return digest.Sum32(), size, nil
}

func main() {
    sum, size, err := fileCRC32("archive.bin", crc32.IEEETable)
    if err != nil {
        fmt.Println("计算失败:", err)
        return
    }
    fmt.Printf("bytes=%d crc32=%08x\n", size, sum) // 固定输出 8 位十六进制
}
%08x 只是显示格式,不参与计算。CRC-32 是 32 位值,补足 8 个十六进制字符便于和清单、协议字段或其他工具的结果比较。比较之前还要确认字节序、大小写和是否包含前缀 0x 等文本约定。
对我来说,这个写法适合绝大多数“一次打开、顺序读完、得到一个 CRC”的任务。代码短,错误边界清楚,而且不需要人为选择读取块大小。
需要进度和复用缓冲区时手动读取
有些任务要展示进度、限速、统计每块耗时,或者把同一个缓冲区放进池中复用。这时手动循环更灵活。最容易忽略的细节是:Read 可能同时返回 n > 0 和一个非空错误,应该先处理已经读到的字节,再判断错误。
func fileCRC32WithProgress(
    file *os.File,
    table *crc32.Table,
    onProgress func(readBytes int64),
) (uint32, error) {
    digest := crc32.New(table)
    buf := make([]byte, 256*1024) // 可按业务负载调整并复用
    var total int64

    for {
        n, readErr := file.Read(buf)
        if n > 0 {
            _, _ = digest.Write(buf[:n]) // 标准库 Hash.Write 不返回错误
            total += int64(n)
            if onProgress != nil {
                onProgress(total)
            }
        }

        if readErr == io.EOF {
            break // 正常读完,保留本次已经写入的 n 个字节
        }
        if readErr != nil {
            return 0, readErr
        }
    }
    return digest.Sum32(), nil
}
手动循环的代价是代码更长,边界更多。若没有进度、节流或共享缓冲区需求,我通常仍选 io.Copy;若需要复用调用方提供的缓冲区,也可以使用 io.CopyBuffer,但应知道当源实现 WriterTo 或目标实现 ReaderFrom 时,提供的缓冲区可能不会被使用。
Checksum、New 和 Update 怎么选
这几个 API 算的都是 CRC-32,区别主要在输入形态和状态表达方式。把它们放到同一张图里,比只看函数名更容易作决定。
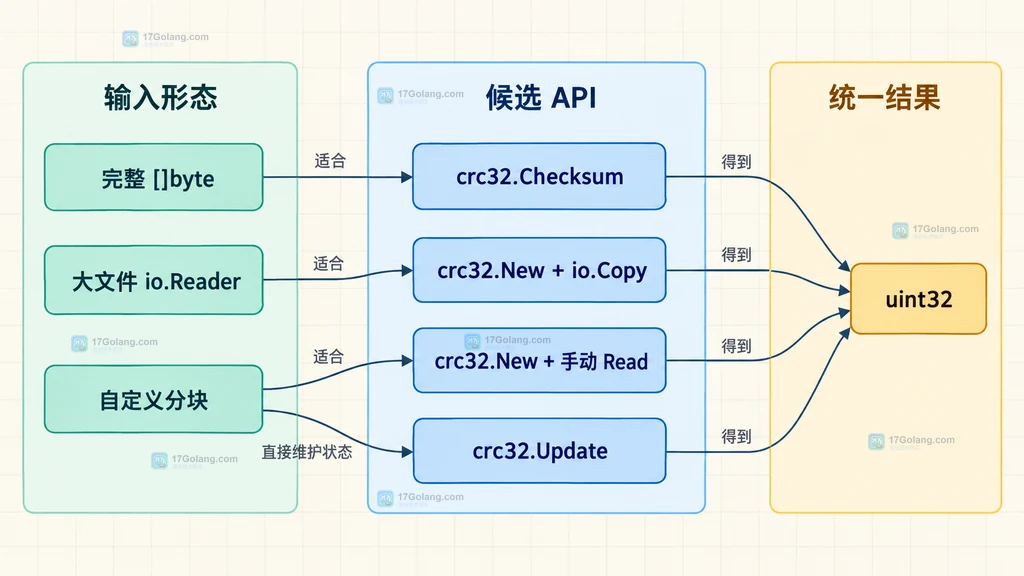
| 方案 | 输入条件 | 适合场景 | 主要注意点 |
|---|---|---|---|
crc32.Checksum | 完整 []byte | 小消息、内存中已有数据 | 不要为大文件额外整块读入内存 |
crc32.New + io.Copy | io.Reader | 大文件、网络流、顺序读取 | 检查复制错误并关闭源 |
crc32.New + 手动 Read | io.Reader 与自定义缓冲 | 进度、限速、指标、缓冲池 | 先处理 n > 0,再判断错误 |
crc32.Update | 已有 uint32 CRC 与新块 | 直接保存数值状态、分段协议处理 | 每段必须使用同一张 Table |
crc32.Update 也能增量计算:
table := crc32.MakeTable(crc32.Castagnoli)
var sum uint32

for _, chunk := range chunks {
    sum = crc32.Update(sum, table, chunk) // 在已有 CRC 数值上继续加入当前块
}
fmt.Printf("%08x\n", sum)
如果上游已经把数据拆成切片,而且系统只想保存一个 uint32 状态,Update 很直观;如果输入天然是 io.Reader,New 的 Writer 接口通常更容易接入现有 I/O 组合。
多项式不一致,比缓冲区大小更容易出错
CRC-32 不是一个唯一结果集合。标准库预定义了 IEEE、Castagnoli 和 Koopman 多项式,crc32.New 使用哪张 Table,结果就遵循哪种规则。IEEE 很常见;Castagnoli 用于包括 iSCSI 在内的场景,并有不同的错误检测特性。
如果已有系统写明使用 CRC-32C,通常对应 Castagnoli;如果写明 CRC-32 IEEE,就使用 crc32.IEEETable 或 crc32.NewIEEE()。不要看到都是 8 位十六进制就直接比较,先确认多项式、初始约定、输入范围和文本格式。
ieee := crc32.NewIEEE() // 等价于使用 crc32.IEEETable
crc32c := crc32.New(crc32.MakeTable(crc32.Castagnoli))

_, _ = ieee.Write([]byte("same bytes"))
_, _ = crc32c.Write([]byte("same bytes"))

fmt.Printf("IEEE=%08x CRC32C=%08x\n", ieee.Sum32(), crc32c.Sum32()) // 两种结果不可混用
还要明确 CRC-32 的用途:它适合发现传输或存储中的意外误码,不适合证明数据没有被恶意篡改。面对不可信来源,需要根据威胁模型使用 SHA-256、HMAC 或数字签名,而不是把 CRC-32 当成安全认证。
可复用函数应该返回哪些信息
实际项目里,我更愿意让函数同时返回 CRC、已读取字节数和错误。这样调用方可以核对文件大小,也能在 I/O 中断时知道处理到了哪里。若对关闭错误有严格要求,可以把 Close 放到命名返回值或调用方中单独处理;纯读取常见场景仍以读取错误为主要判断。
一份稳妥的调用清单是:
- 打开文件失败立即返回;
- 全程复用同一个
hash.Hash32和同一张Table; - 检查
io.Copy或手动Read的错误; - 使用
Sum32取得数值,用%08x输出固定宽度; - 与外部结果比较前确认多项式和输入范围;
- 不要用 CRC-32 替代密码学完整性验证。
常见问题
分块大小会改变 CRC-32 结果吗
不会。只要所有字节按相同顺序、使用同一张 Table 写入同一个状态,64 KiB、256 KiB 或 io.Copy 的内部缓冲都应得到相同结果。块大小影响的是 I/O 行为和资源使用,不是校验算法的逻辑输入。
调用 Sum32 后还能继续 Write 吗
可以。hash.Hash 的 Sum 不改变底层状态,Sum32 也用于读取当前 32 位结果。继续写入会在已有状态上追加数据;如果要重新计算另一份独立内容,应先 Reset 或创建新对象。
可以并发把多个文件块写进同一个 Hash32 吗
不要直接并发写同一个实例。CRC 依赖字节顺序,多块并发完成的先后可能破坏原始顺序,而且接口没有承诺可并发使用。最简单可靠的做法仍是按文件顺序串行写入。
总结
大文件 CRC-32 的核心不是“把文件切成多少块”,而是让所有块按顺序进入同一个校验状态。默认用 crc32.New 加 io.Copy;要进度、限速或缓冲复用时手动读取;数据本来就在内存里再用 Checksum;只维护数值状态时考虑 Update。最后别忘了,能否正确对比结果首先取决于双方使用的多项式和输入约定一致。
 OpenAI Structured Outputs 怎么约束嵌套 JSON 结构
- 上一篇
- OpenAI Structured Outputs 怎么约束嵌套 JSON 结构
- 下一篇
- Kubernetes 可复现故障场景为何强调恢复验证
-
- Golang · Go教程 | 9分钟前 | go · Go 图片合成 image/draw DrawMask 透明蒙版
- Go image/draw.DrawMask 怎么按透明蒙版合成图片
- 338浏览 收藏
-
- Golang · Go教程 | 29分钟前 | WEB开发 · 标准库 · Go教程 · Go html/template 模板复用 Template.Clone ExecuteTemplate
- Go html/template.Clone 怎么派生不同页面模板
- 361浏览 收藏
-
- Golang · Go教程 | 1小时前 | 标准库 · 模板 · web安全 · Go教程 · Go html/template 用户输入 HTML转义 html.EscapeString 上下文转义
- Go html.EscapeString 怎么安全显示用户文本
- 299浏览 收藏
-
- Golang · Go教程 | 1小时前 | go ·
- Go types.Eval 怎么计算源码位置处表达式类型
- 480浏览 收藏
-
- Golang · Go教程 | 2小时前 | go · 源码分析 · Go PositionFor token.FileSet 行列位置
- Go token.FileSet.PositionFor 怎么解析行列位置
- 466浏览 收藏
-
- Golang · Go教程 | 2小时前 | 标准库 · go · Go go/scanner Scanner.ErrorCount 词法错误
- Go scanner.Scanner.ErrorCount 怎么统计源码词法错误
- 355浏览 收藏
-
- Golang · Go教程 | 3小时前 | Go教程 · Go go/printer AST 缩进
- Go printer.Config.Fprint 怎么控制 AST 输出缩进
- 447浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- Go parser.ParseExprFrom 怎么解析带文件位置的表达式
- 133浏览 收藏
-
- Golang · Go教程 | 4小时前 |
- Go importer.ForCompiler 怎么读取指定编译器导出数据
- 246浏览 收藏
-
- Golang · Go教程 | 4小时前 | go ·
- Go format.Source 怎么格式化内存中的 Go 源码
- 123浏览 收藏
-
- Golang · Go教程 | 4小时前 | 标准库 · Go教程 · Go go/parser go/ast token.FileSet go/doc doc.NewFromFiles 包文档
- Go doc.NewFromFiles 怎么为多个源码文件生成包文档
- 422浏览 收藏
-
- Golang · Go教程 | 5小时前 | 标准库 · Go教程 · Go go/constant constant.ToInt 编译期常量 整数判断 constant.Value
- Go constant.ToInt 怎么判断编译期数值是否为整数
- 194浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 329次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 386次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 380次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 349次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 172次使用
-
- GScript 编写标准库示例详解
- 2022-12-30 369浏览
-
- 关于Golang标准库flag的全面讲解
- 2023-02-25 344浏览
-
- Golang标准库unsafe源码解读
- 2022-12-29 464浏览
-
- 快速掌握Go语言HTTP标准库的实现方法
- 2022-12-30 327浏览
-
- 解析golang 标准库template的代码生成方法
- 2022-12-24 349浏览


