
Go pem.Decode 怎么连续读取多个 PEM 区块
读取拼接在一起的多个 PEM 区块时,关键不是重复调用 pem.Decode,而是把它返回的 rest 作为下一轮输入。每次调用消费一个区块,block 保存当前结果,rest 保存尚未处理的字节;当 block == nil 时,说明剩余内容里没有可识别的 PEM 区块。
实用写法是“Decode 当前数据、处理 block、把 data 更新为 rest”,并在 nil 时立即停止。这样证书链、密钥和尾部备注都能被区分,不会重复解析同一段内容。
- 输入:一段可能包含多个 BEGIN/END 标记的字节流。
- 循环:每轮只把
rest交给下一次pem.Decode。 - 判断:
Type决定后续解析器,nil决定读取结束或输入异常。
先看懂 pem.Decode 返回的 block 和 rest
pem.Decode(data) 会寻找下一个 PEM 格式区块,返回的 *pem.Block 包含 Type、可选的 Headers 和已经 Base64 解码的 Bytes。第二个返回值不是“下一段区块”,而是从当前区块结束位置开始的剩余输入。
因此,输入中有两个证书时,第一次得到第一个 CERTIFICATE 和剩余字节,第二次必须把剩余字节传回去。若把原始 data 再传一次,就会再次得到第一个区块,造成重复处理。
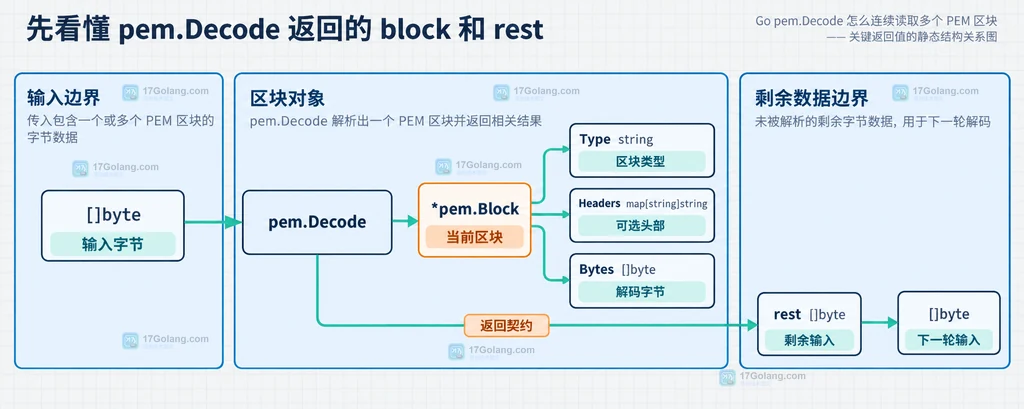
用 rest 连续读取多个 PEM 区块
把循环变量命名为 data 更直观:开始时它指向完整输入,成功解码后改成 rest。下面的代码只负责拆区块和记录类型,不把证书解析、私钥解析等业务混在读取层里。
package main

import (
    "bytes"
    "encoding/pem"
    "fmt"
)

func readPEMBlocks(input []byte) []*pem.Block {
    var blocks []*pem.Block
    data := input

    for len(bytes.TrimSpace(data)) > 0 {
        // 每轮只消费当前区块,rest 是下一轮的输入,避免重复读取。
        block, rest := pem.Decode(data)
        if block == nil {
            // 剩余内容不是完整 PEM 时停止,调用方可据此记录尾部位置。
            break
        }
        blocks = append(blocks, block)
        data = rest
    }
    return blocks
}

func main() {
    // 示例输入可包含证书链、密钥或其他 PEM 区块。
    input := []byte("...多个 PEM 区块...")
    for index, block := range readPEMBlocks(input) {
        // Type 用于决定后续解析器,Bytes 已经是解码后的内容。
        fmt.Printf("第 %d 个区块:%s,字节数:%d\\n", index+1, block.Type, len(block.Bytes))
    }
}
循环条件用 bytes.TrimSpace 只是为了跳过已经没有有效字符的尾部空白;真正决定是否读到区块的是 block == nil。如果业务要求“必须全部是 PEM”,还应在退出后检查剩余字节,而不是把 nil 静默当成成功。
nil、前缀和尾部文本怎么处理
PEM 区块必须从行首的 BEGIN 标记开始,并在行尾结束。合法输入前后可以有空白或业务备注,但备注不会变成 pem.Block。当剩余数据只有备注、截断标记或损坏的 Base64 时,pem.Decode 可能返回 nil,此时应记录“已读区块数”和剩余内容长度,方便定位输入问题。
不要在 block == nil 后继续把同一个 data 放回循环,否则既没有进展,也无法区分“没有更多区块”和“输入从中间损坏”。对配置文件或上传内容,通常建议把 nil 视为格式错误;对证书链后允许备注的场景,则可以明确允许尾部非 PEM,并把它作为未消费数据保留下来。
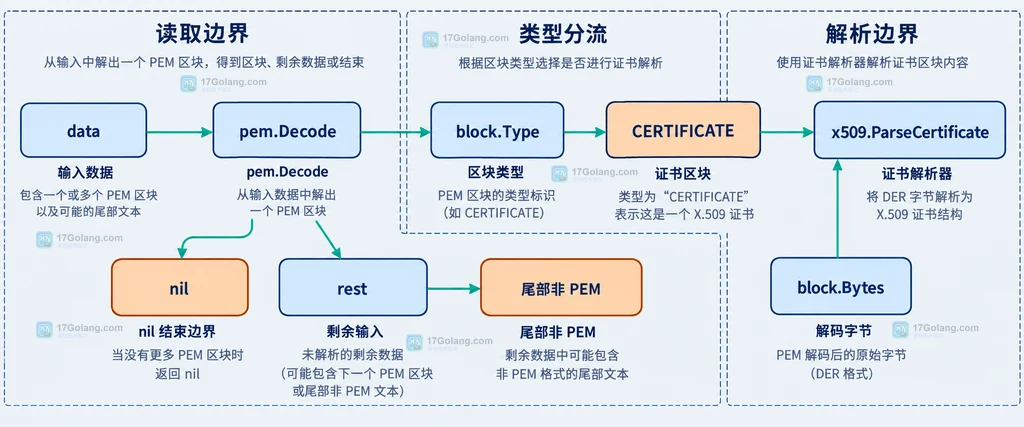
按 Type 分流,读取和解析分开
读取层只确认区块边界,不能因为拿到了 block 就认为证书或私钥内容一定有效。证书区块可以交给 x509.ParseCertificate(block.Bytes);私钥则按实际编码选择 PKCS#1、PKCS#8 或 EC 解析函数。未知类型应保留 block.Bytes 或直接报错,不要把所有区块都强行当成证书。
| 判断对象 | 用途 | 处理建议 |
|---|---|---|
block == nil | 没有可识别区块 | 停止并检查剩余数据是否允许 |
block.Type | 决定数据类型 | 分流到对应解析器 |
block.Bytes | 解码后的二进制 | 交给 x509 或业务协议解析 |
rest | 下一轮输入 | 覆盖循环变量,保证每轮前进 |
func parseCertificateBlocks(input []byte) ([]*x509.Certificate, error) {
    var certs []*x509.Certificate
    data := input
    for len(bytes.TrimSpace(data)) > 0 {
        // Decode 只拆边界,证书语义由 x509 解析器负责。
        block, rest := pem.Decode(data)
        if block == nil {
            return nil, fmt.Errorf("剩余内容不是完整 PEM,长度=%d", len(data))
        }
        data = rest
        if block.Type != "CERTIFICATE" {
            // 证书链函数不混入私钥或其他区块,避免类型误判。
            continue
        }
        cert, err := x509.ParseCertificate(block.Bytes)
        if err != nil {
            return nil, fmt.Errorf("解析证书失败:%w", err)
        }
        certs = append(certs, cert)
    }
    return certs, nil
}
这个分层让问题更容易定位:区块数量不对,先看 rest 是否被更新;类型不对,看 Type;证书内容损坏,再看 ParseCertificate 的错误。多区块读取本身不负责验证证书链,也不负责判断私钥是否能使用。
常见问题
为什么第二次 Decode 读到的还是第一个区块?
通常是循环里一直传入原始 data,没有执行 data = rest。每次成功解码后都要把剩余字节覆盖回循环变量。
pem.Decode 返回 nil 后还能继续读吗?
不建议继续传入同一段数据。nil 表示没有找到可识别的 PEM 区块;应根据业务选择允许尾部备注,或直接返回格式错误,并记录剩余内容长度。
官方接口说明可参考:https://pkg.go.dev/encoding/pem。它明确描述了 Decode 的区块与剩余输入返回值,以及 PEM 标记必须位于行边界的格式条件。
 Python contextlib.aclosing 怎么确保异步生成器退出
- 上一篇
- Python contextlib.aclosing 怎么确保异步生成器退出
- 下一篇
- Linux PSI 指标怎么判断 CPU 内存与 I/O 压力
-
- Golang · Go教程 | 16分钟前 |
- Go errors.AsType 怎么从错误链提取具体类型
- 127浏览 收藏
-
- Golang · Go教程 | 38分钟前 | 标准库 · 流式处理 · Go教程 · Go token 流式解析 encoding/xml xml.Decoder 大型XML
- Go xml.Decoder.Token 怎么流式处理大型 XML
- 326浏览 收藏
-
- Golang · Go教程 | 1小时前 | go · Go encoding/json json.Decoder InputOffset
- Go json.Decoder.InputOffset 怎么定位解析错误附近字节
- 298浏览 收藏
-
- Golang · Go教程 | 1小时前 | go · Go io.Writer encoding/hex hex.Dumper
- Go hex.Dumper 怎么流式输出可读十六进制内容
- 159浏览 收藏
-
- Golang · Go教程 | 2小时前 | 切片 · go · Go encoding/binary binary.AppendUvarint varint
- Go binary.AppendUvarint 怎么追加变长整数
- 156浏览 收藏
-
- Golang · Go教程 | 2小时前 | 标准库 · 性能优化 · Go教程 · base64 Go encoding/base64 切片复用 AppendEncode EncodedLen
- Go base64.Encoding.AppendEncode 怎么复用目标缓冲区
- 285浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- Go base32.Encoding.WithPadding 怎么生成无填充编码
- 473浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- Go ascii85.NewDecoder 怎么流式解码分段数据
- 398浏览 收藏
-
- Golang · Go教程 | 4小时前 | Go教程 · Go ReadFile 依赖版本 debug/buildinfo BuildInfo 二进制分析
- Go debug/buildinfo.ReadFile 怎么读取二进制依赖版本
- 446浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 325次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 384次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 376次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 343次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 167次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


