
Go crypto/rand 生成令牌并避免短随机数
Go 生成登录链接、幂等键或一次性访问令牌时,核心不是把字符串拼得更长,而是使用不可预测的随机源并先定下随机预算。Go 1.24 及以上可以直接用 crypto/rand.Text();需要兼容更早版本时,用 32 字节随机值编码为 URL-safe Base64。这样做比时间戳、math/rand 或截取短随机串更可靠。
官方地址:https://pkg.go.dev/crypto/rand
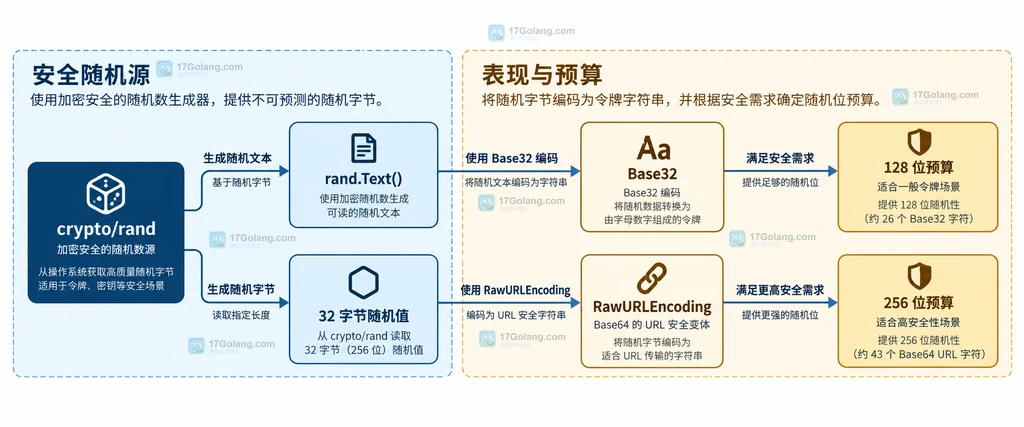
- 文本令牌至少按 128 位随机性设计,重要凭证可直接使用 256 位随机值。
- 编码只改变表现形式,不会替代随机预算;URL 场景优先选 RawURLEncoding。
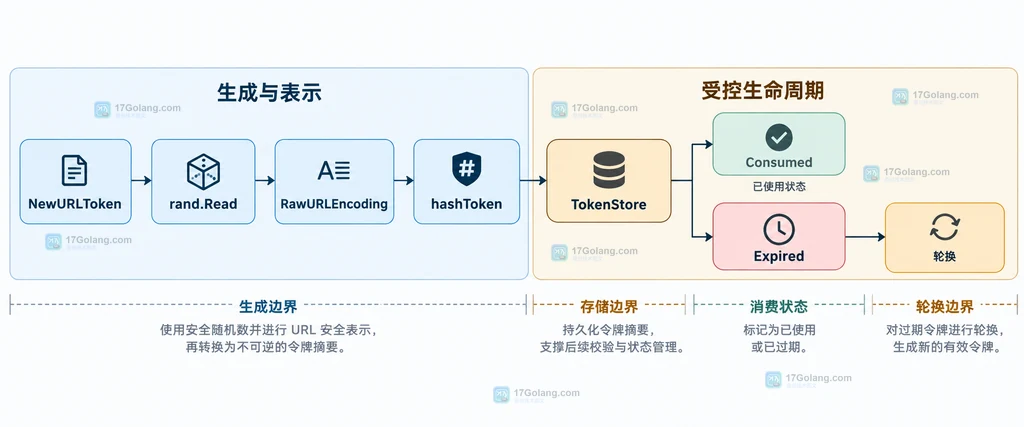
- 令牌只存摘要或受控存储,生成失败、重复键和过期轮换分别处理。
一、先确定令牌的随机预算
先问清楚令牌的用途:登录链接和短期邀请通常需要不可预测的文本;幂等键还要能在业务时间窗内稳定去重;长期凭证则应把轮换和撤销一起设计。字符数量不是随机强度,关键是有效随机位数。例如 16 个十六进制字符只有 64 位随机性,不能因为看起来“够长”就直接用于高价值凭证。
rand.Text() 的结果使用 RFC 4648 Base32 字符表,官方文档说明其随机性至少为 128 位,适合“需要一个秘密文本”的场景。若服务接口、数据库字段或安全策略希望固定预算,可以直接选择 32 字节,也就是 256 位随机值,再决定如何编码。
二、用 crypto/rand 生成 URL 安全令牌
下面的兼容写法将随机源和编码分开:rand.Read 负责填满字节切片,base64.RawURLEncoding 负责移除 URL 中不友好的字符和填充符。返回错误后立即停止,不要返回一个不完整的令牌。
package token

import (
	"crypto/rand"
	"encoding/base64"
)

// NewURLToken 生成 32 字节随机值,编码后适合放在 URL 查询参数中。
func NewURLToken() (string, error) {
	buf := make([]byte, 32)
	// crypto/rand.Read 会填满 buf;错误时不能继续使用半成品。
	if _, err := rand.Read(buf); err != nil {
		return "", err
	}
	// Raw 编码不带 = 填充,URL 中的 + 和 / 也会被替换为安全字符。
	return base64.RawURLEncoding.EncodeToString(buf), nil
}
如果项目已经统一到 Go 1.24 或更新版本,需要的是一般文本令牌而不是固定编码,可以用更短的封装:
package token

import "crypto/rand"

// NewTextToken 使用标准库维护的安全文本随机源。
func NewTextToken() string {
	// rand.Text 已保证至少 128 位随机性;这里不再截取结果。
	return rand.Text()
}
不要把 math/rand 的输出、当前时间、用户 ID 或自增序号直接拼进凭证。它们可以作为业务关联字段,却不能替代密码学随机源。
三、把错误、存储和轮换边界补齐
生成成功只代表拿到了候选值,不代表令牌生命周期已经安全。写入数据库时仍要对唯一键冲突做有限重试;读取时比较摘要或使用受保护的存储字段;一次性令牌要有明确的过期时间和消费标记。日志只记录请求关联 ID,不打印完整令牌。
// ConsumeToken 只展示边界判断,存储实现由业务层提供。
func ConsumeToken(token string, now time.Time) error {
	if token == "" {
		return errors.New("empty token")
	}
	// 查询时同时判断过期、已消费和用途,避免只验证字符串存在。
	record, err := store.FindToken(hashToken(token))
	if err != nil {
		return err
	}
	if record.ExpiredAt.Before(now) || record.Consumed {
		return ErrTokenUnavailable
	}
	// 成功消费要与状态更新放在同一事务或等价的原子操作中。
	return store.MarkConsumed(record.ID)
}
上例中的 hashToken 只表示“存摘要”的边界,实际哈希算法和密钥策略应按令牌用途选择。高价值会话还需要撤销、轮换、设备绑定或重新认证,不要把“随机”误当成完整的身份管理。
四、用指标验证方案而不是猜长度
压测时至少记录四组指标:每次生成的字节预算与最终字符串长度、随机源错误数、唯一键冲突数、过期和重复消费拒绝数。吞吐对比应在同一机器、同一 Go 版本和同一并发度下进行;不要把一次本地基准的数字写成所有部署环境都成立的结论。
如果业务需要固定长度,先固定随机字节数,再选择编码并测量结果长度;如果业务只要求可复制的安全文本,优先采用 rand.Text(),避免自行维护字符表。安全令牌的“短”通常来自随机预算不足、错误地截断结果或把编码长度当成随机位数。
相关问题
为什么不直接用时间戳生成令牌?
时间戳可预测且同一时间窗口内容易重复,只能作为记录字段,不能作为秘密随机值。
Base64 字符串越长就越安全吗?
不一定。Base64 是编码,安全性主要由输入随机字节数决定;先确定随机预算,再处理可传输格式。
 tapaim安卓画面异常怎么办?3.0.0低分辨率面板与光照修复说明
- 上一篇
- tapaim安卓画面异常怎么办?3.0.0低分辨率面板与光照修复说明
- 下一篇
- Java Stream Gatherer 与 Collector 的职责对比
-
- Golang · Go教程 | 51分钟前 |
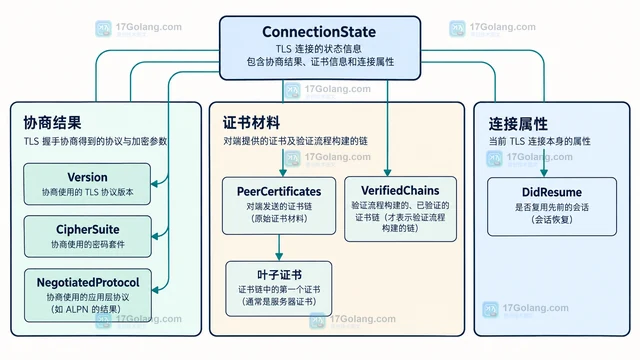
- Go tls.ConnectionState 读取协商协议与证书信息
- 327浏览 收藏
-
- Golang · Go教程 | 1小时前 | go · 目录 Go 符号链接 archive/tar Header.Typeflag
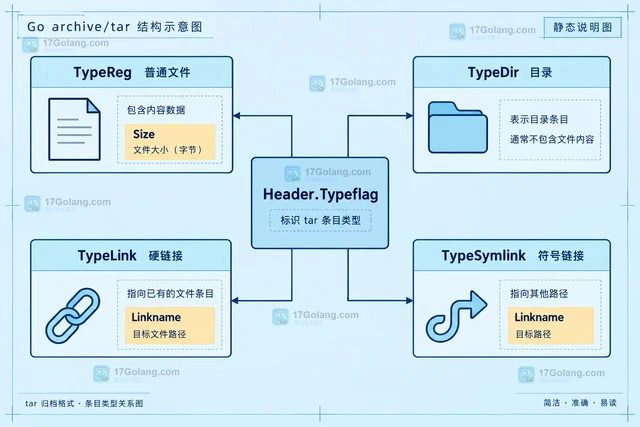
- Go archive/tar Header.Typeflag 区分目录与链接
- 199浏览 收藏
-
- Golang · Go教程 | 2小时前 | go · Go archive/tar tar.Writer FileInfoHeader
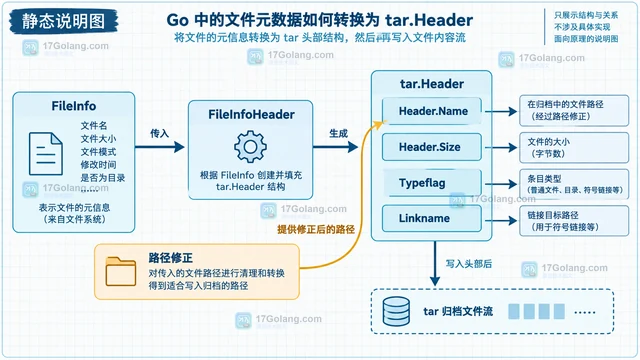
- Go archive/tar 流式写入文件元数据
- 366浏览 收藏
-
- Golang · Go教程 | 2小时前 | go ·
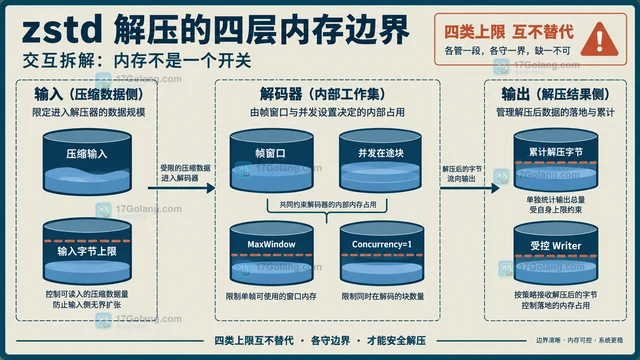
- Go compress/zstd 多帧解压的内存控制
- 269浏览 收藏
-
- Golang · Go教程 | 2小时前 | go ·
- Go fs.Sub 暴露子目录并保持路径安全
- 449浏览 收藏
-
- Golang · Go教程 | 3小时前 | go · html/template ·
- Go embed.FS 读取内嵌模板的路径组织
- 140浏览 收藏
-
- Golang · Go教程 | 4小时前 | go · 调试 ·
- Go build -overlay 临时替换源码的调试方法
- 314浏览 收藏
-
- Golang · Go教程 | 4小时前 | 依赖管理 · Go教程 · Go go.work 依赖版本 多模块工作区 go work sync
- Go work sync 维护多模块工作区依赖
- 480浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 318次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 374次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 371次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 337次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 162次使用
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- go语言中的defer关键字
- 2023-02-17 150浏览
-
- Golang中Interface接口的三个特性
- 2023-01-07 394浏览
-
- go语言中函数与方法介绍
- 2023-01-07 297浏览
-
- go语言数据类型之字符串string
- 2022-12-30 321浏览


