
Go url.JoinPath 处理双斜杠的路径规则
Go 的 url.JoinPath 会把 URL 路径中的连续斜杠折叠为一个,同时清理 . 和 .. 路径元素。它不会把 https:// 里的两个斜杠误删,因为函数先解析 URL,再只处理路径字段。若服务端把路径里的 // 当成有意义的空段,JoinPath 就不适合直接使用。
官方文档:https://pkg.go.dev/net/url#JoinPath
普通 URL 拼接的最小写法
url.JoinPath(base, elem...) 从 Go 1.19 开始可用。路径元素应当已经是转义形式;函数返回完整 URL 字符串和错误。
package main

import (
	"fmt"
	"net/url"
)

func main() {
	// base 末尾和元素开头都带斜杠,结果仍只有一个分隔符
	joined, err := url.JoinPath("https://api.example.com/v1//", "/users", "42")
	if err != nil {
		// base 不是合法 URL 时应显式处理错误
		panic(err)
	}

	fmt.Println(joined)
	// 结果:https://api.example.com/v1/users/42
}
这不是简单的字符串去重。scheme、host、query 和 fragment 仍由 net/url 的 URL 结构管理,路径清理只发生在 Path/RawPath 相关部分。
JoinPath 为什么会折叠双斜杠
标准库实现先取得 base 的 EscapedPath(),再把它和新元素交给 path.Join。而 path.Join 的结果会经过词法清理:连续斜杠合并、. 删除、内部 .. 与前一段一起消解。
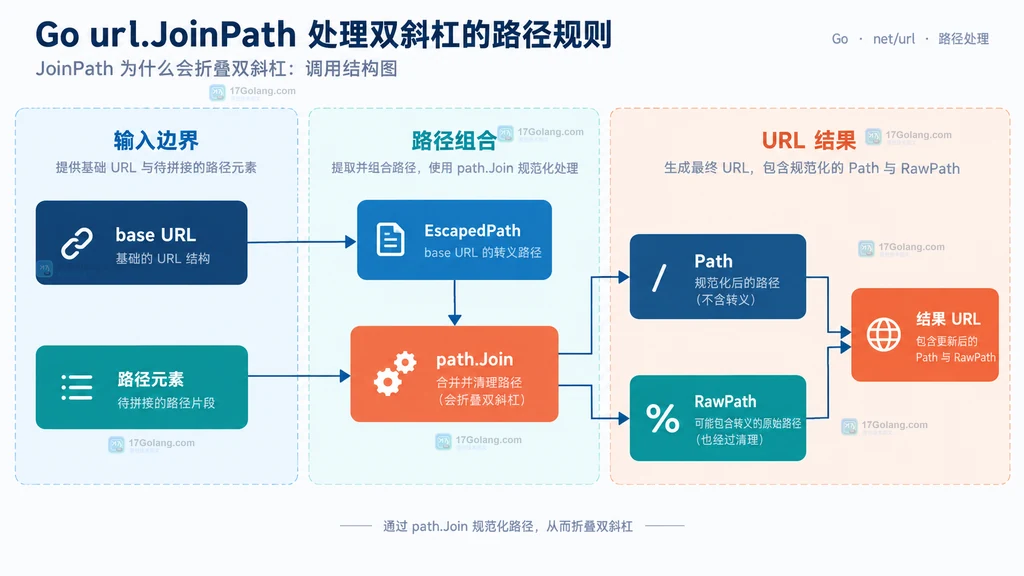
因此下面几组输入看起来不同,却会得到同一条规范化路径:
cases := [][]string{
	{"https://example.com/api//", "users"},
	{"https://example.com/api/", "/users"},
	{"https://example.com", "api", "./users"},
}

for _, parts := range cases {
	// 第一个元素是 base,其余元素作为路径片段
	got, err := url.JoinPath(parts[0], parts[1:]...)
	if err != nil {
		fmt.Println("拼接失败:", err)
		continue
	}
	fmt.Println(got)
}
这套模式适合“路径只是资源层级”的 API:调用方只关心 /api/users,不希望因为配置项多一个斜杠就生成不同地址。
尾斜杠、空元素和 base 路径
JoinPath 会忽略没有贡献的空路径元素,但会照顾最后一个元素的尾斜杠:如果最后一个元素以 / 结尾,清理后会保留至少一个尾斜杠。多个尾斜杠不会原样保留。
examples := []struct {
	base string
	elem []string
}{
	// 空元素不新增路径层级
	{"https://example.com/root", []string{"", "child"}},
	// 最后一个元素带斜杠,结果保留一个尾斜杠
	{"https://example.com/root", []string{"child/"}},
	// base 已有路径,新元素会接在该路径之后
	{"https://example.com/root/", []string{"sub", "item"}},
}

for _, item := range examples {
	joined, err := url.JoinPath(item.base, item.elem...)
	if err != nil {
		fmt.Println("无效地址:", err)
		continue
	}
	fmt.Println(joined)
}
是否需要尾斜杠由服务端路由规则决定。JoinPath 能保留一个尾斜杠,但不会保证 // 或更多斜杠的原始数量。
普通斜杠与转义斜杠不是一回事
路径元素必须已经按 URL 路径规则转义。若一段用户数据本身包含斜杠,并且你希望它仍是“一个段”,应先使用 url.PathEscape。例如 team/a 会被转义为包含 %2F 的单段数据,而不是两个层级。
rawID := "team/a"

// 把数据中的斜杠编码为 %2F,避免它被当成路径分隔符
escapedID := url.PathEscape(rawID)
joined, err := url.JoinPath("https://example.com/resources", escapedID)
if err != nil {
	panic(err)
}

fmt.Println(joined)
// 结果路径包含 team%2Fa,表示一个转义后的路径段
不过,PathEscape 不是路径权限校验器。像 .、.. 这样的点段还应在业务层显式拒绝;不能依赖 JoinPath 的清理结果来证明输入安全。
哪些输入需要格外小心
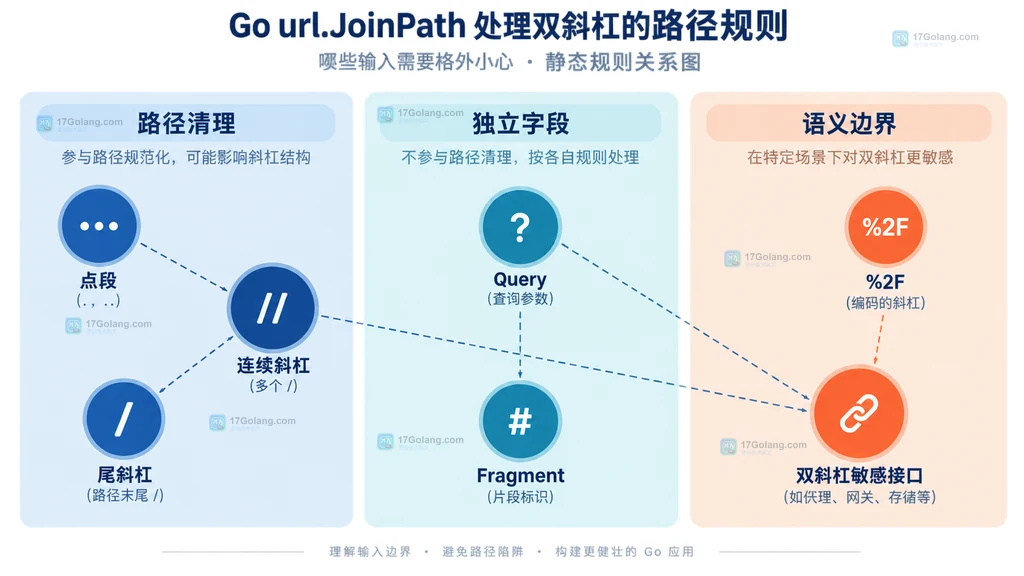
| 输入特征 | JoinPath 的处理 | 建议 |
|---|---|---|
路径中连续 // | 折叠为一个 / | 普通 REST 路径可直接使用 |
. 与 .. | 进行词法清理 | 外部输入仍需独立校验 |
| 数据中的斜杠 | 未转义时会成为分隔符 | 先对单个数据段调用 PathEscape |
最后一个元素以 / 结尾 | 保留一个尾斜杠 | 按服务端路由约定测试 |
| base 中的 query/fragment | 作为 URL 独立字段保留 | 不要把查询串塞进路径元素 |
服务端区分 /a/b 与 /a//b | 原始空段会丢失 | 不要使用 JoinPath 自动清理 |
一个常见反例:把完整相对 URL 当路径段
JoinPath 的 elem 是路径元素,不是带 query 的相对 URL。把 users?page=2 直接当元素,会把问号视为路径数据并进行转义,不会替你创建 RawQuery。正确做法是先拼 Path,再通过 URL 的 Query 方法设置查询参数。
u, err := url.Parse("https://example.com/api")
if err != nil {
	panic(err)
}

// JoinPath 只负责路径层级,不在 elem 中混入查询串
u = u.JoinPath("users")

// Query 参数放进 RawQuery 对应的独立字段
q := u.Query()
q.Set("page", "2")
u.RawQuery = q.Encode()

fmt.Println(u.String())
// 结果:https://example.com/api/users?page=2
同理,fragment 也应写入 u.Fragment,而不是拼在路径元素里。这种“字段各归字段”的模式,比先拼大字符串再补转义更容易检查。
什么时候不该用 JoinPath
如果远端协议明确把重复斜杠当成不同资源、签名算法要求原始 path 字节完全不变,或者反向代理必须转发未经规范化的路径,就不要让 JoinPath 介入。它的价值正是规范化路径,而不是保真复制。
- 普通 API 资源层级:推荐 JoinPath。
- 动态 ID 可能含斜杠:先 PathEscape,再 JoinPath。
- 外部输入可能是点段:先校验,不能只依赖清理。
- query 与 fragment:使用 URL 对应字段。
- 双斜杠具有业务意义或参与签名:保留原始路径方案并编写精确测试。
常见问题
url.JoinPath 会破坏 https:// 吗?
不会。它先解析 URL,只清理路径部分,scheme 与 host 不按普通字符串处理。
为什么 /api//users 变成 /api/users?
因为 JoinPath 使用路径清理规则,连续斜杠会被折叠为一个。这是函数的明确语义。
怎样把包含斜杠的 ID 当成一个路径段?
对该 ID 调用 url.PathEscape,再把转义结果传给 JoinPath;同时拒绝不符合业务约束的点段。
JoinPath 与字符串拼接哪个更好?
普通结构化 URL 优先 JoinPath,因为它能处理 base path、转义与清理规则。只有协议要求保留重复斜杠或原始路径字节时,才应选择专门的保真构造方式。
 永雏小菲语音盒公开页面怎么看?功能分区与使用帮助核对说明
- 上一篇
- 永雏小菲语音盒公开页面怎么看?功能分区与使用帮助核对说明
- 下一篇
- Docker Compose 服务名解析与自定义网络配置
-
- Golang · Go问答 | 42分钟前 |
- Go database/sql Rows 未关闭造成连接耗尽的诊断
- 354浏览 收藏
-
- Golang · Go问答 | 58分钟前 |
- Go database/sql 连接池 MaxIdleConns 的容量关系
- 478浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go URL 查询值乱码时的编码排查步骤
- 285浏览 收藏
-
- Golang · Go问答 | 2小时前 |
- Go Resolver PreferGo 与系统解析器的差异边界
- 452浏览 收藏
-
- Golang · Go问答 | 2小时前 |
- Go DNS 轮询返回多地址后的连接选择策略
- 295浏览 收藏
-
- Golang · Go问答 | 3小时前 | 网络编程 · DNS · Go问答 · DNS Go net.Resolver 解析超时 LookupIPAddr
- Go net.Resolver 自定义 DNS 解析超时的实现
- 481浏览 收藏
-
- Golang · Go问答 | 4小时前 | Go问答 · 兼容性 · tls Go MinVersion CipherSuites
- Go TLS 最低版本与密码套件迁移清单
- 130浏览 收藏
-
- Golang · Go问答 | 4小时前 |
- Go tls.Config 复用导致证书更新不生效的处理方式
- 144浏览 收藏
-
- Golang · Go问答 | 4小时前 | 网络编程 · Go问答 · tls Go ALPN NextProtos
- Go TLS 握手因 ALPN 不匹配失败的定位方案
- 397浏览 收藏
-
- Golang · Go问答 | 5小时前 | 连接池 · 性能排查 · Go问答 · net/http Go HTTP/2 MaxConcurrentStreams StrictMaxConcurrentRequests 请求排队
- Go HTTP/2 流并发限制导致请求排队的调参思路
- 188浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 258次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 302次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 281次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 259次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 67次使用
-
- Go 语言入门之net/url 包
- 2022-12-24 403浏览
-
- Go url.JoinPath 拼接 URL 为什么会改路径:斜杠、转义和 RawPath 边界
- 2026-07-23 354浏览
-
- Go URL 查询参数怎么区分空值、缺失值和重复值
- 2026-09-07 296浏览
-
- Go net/url 解析重复查询参数时怎么保留全部值
- 2026-09-08 115浏览
-
- Go url.ParseQuery 遇到非法百分号时怎么保留有效参数
- 2026-09-09 243浏览


