
Go csv.InputOffset 为什么不是当前字段的字节位置
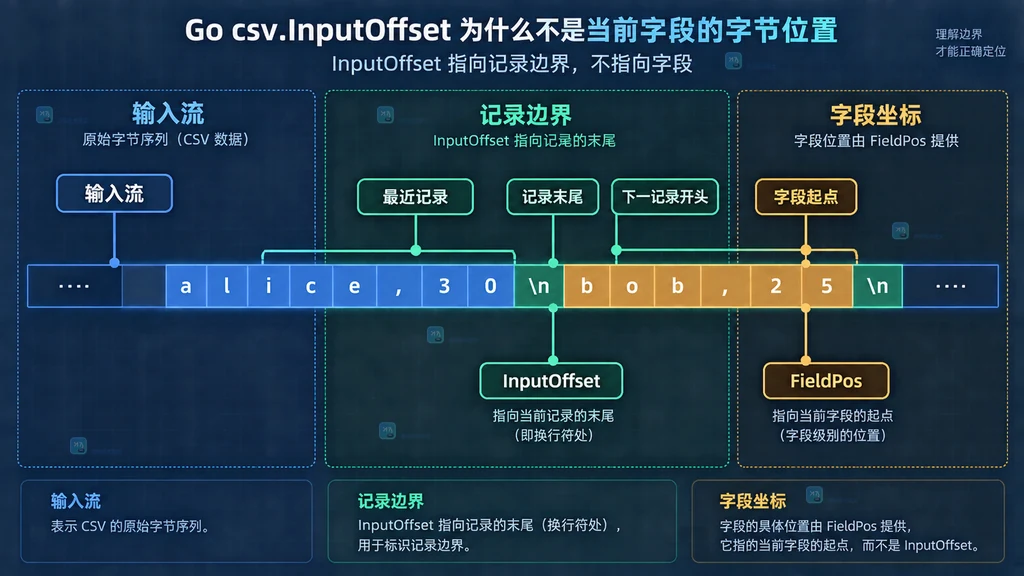
csv.Reader.InputOffset 不是“当前字段偏移量”。它返回输入流当前读取位置:最近一次读取记录的结束位置,同时也是下一条记录的开始位置。这个设计适合记录级进度和断点续读;要定位最近记录中的某个字段,应使用 FieldPos。
我第一次用它时也把 offset 当成字段位置,结果每次都落在整条记录后面。理解成“已消费到哪里”就顺了:InputOffset 描述 Reader 的记录边界,不描述解析器当前正在看哪个字段。
InputOffset 指向记录边界,不指向字段
官方定义很明确:这个字节偏移量位于最近读取行的末尾和下一行的开头。CSV 里的带引号字段可以包含换行,因此这里更准确的概念是“记录边界”,不能简单等同于屏幕上的物理行号。
reader := csv.NewReader(src)

record, err := reader.Read()
if err != nil {
    return err // 只有完整读取成功后才把位置当成可提交边界
}

nextRecordOffset := reader.InputOffset() // 指向 record 结束后、下一条记录开始前
fmt.Printf("本条字段数=%d,下条记录偏移=%d\n", len(record), nextRecordOffset)
即使当前记录有五个字段,InputOffset 也只返回一个记录级位置。它不会告诉你第三个字段从哪里开始,更不会随着你访问 record[2] 而改变。
它真正适合做进度检查点
大文件导入中,记录边界比字段位置更实用。每成功处理一条记录,可以保存 InputOffset,失败恢复时从这个边界重新创建 Reader。真正需要注意的是提交顺序:先完成业务写入,再保存偏移;否则进度领先于数据提交,重启后可能跳过未落库的记录。
for {
    record, err := reader.Read()
    if errors.Is(err, io.EOF) {
        break // 全部记录处理完成
    }
    if err != nil {
        return err // 解析失败时不推进检查点
    }

    if err := store(record); err != nil {
        return err // 业务保存失败,保留上一个已提交位置
    }

    checkpoint := reader.InputOffset() // store 成功后再记录下一条的起点
    if err := saveCheckpoint(checkpoint); err != nil {
        return err // 检查点持久化失败时明确上报
    }
}
如果 store 和 saveCheckpoint 分属不同存储系统,还要接受“至少一次”处理的现实:检查点保存失败时,恢复后可能重放上一条记录。业务写入最好具备幂等键,而不是假设 offset 本身能提供分布式事务。
恢复时从记录边界重建 Reader
源文件支持 io.Seeker 时,可以把成功提交的偏移保存下来,再从该位置恢复。偏移必须来自完整成功记录之后,不能拿解析到一半的位置冒充记录边界。
func resumeCSV(file *os.File, offset int64) (*csv.Reader, error) {
    if _, err := file.Seek(offset, io.SeekStart); err != nil {
        return nil, fmt.Errorf("定位 CSV 检查点失败:%w", err) // 恢复前确认 Seek 成功
    }

    reader := csv.NewReader(file)
    reader.FieldsPerRecord = 5 // 重建 Reader 后恢复任务所需的解析约束
    return reader, nil
}
如果数据来自不可 Seek 的网络流,就不能只靠 offset 回退源头;需要上游支持 Range、对象存储分段读取,或把输入先落到可定位的介质。InputOffset 能提供坐标,但不会自动让输入源具备随机访问能力。
三个位置 API 各自解决什么问题
| 需求 | 使用项 | 得到什么 |
|---|---|---|
| 保存读取进度、从下一条恢复 | InputOffset | 输入流的记录边界字节偏移 |
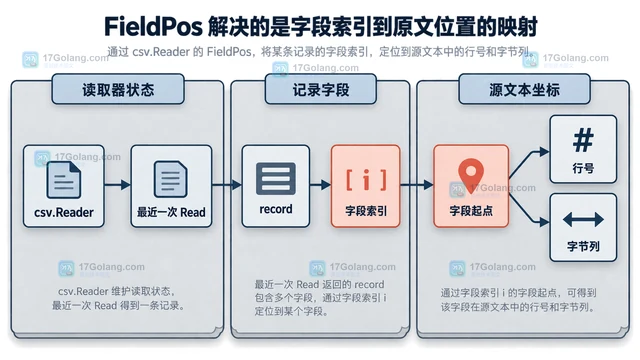
| 定位最近记录中的坏字段 | FieldPos | 字段起始行和字节列 |
| 定位引号等 CSV 语法错误 | ParseError | 记录起始行、错误行和字节列 |
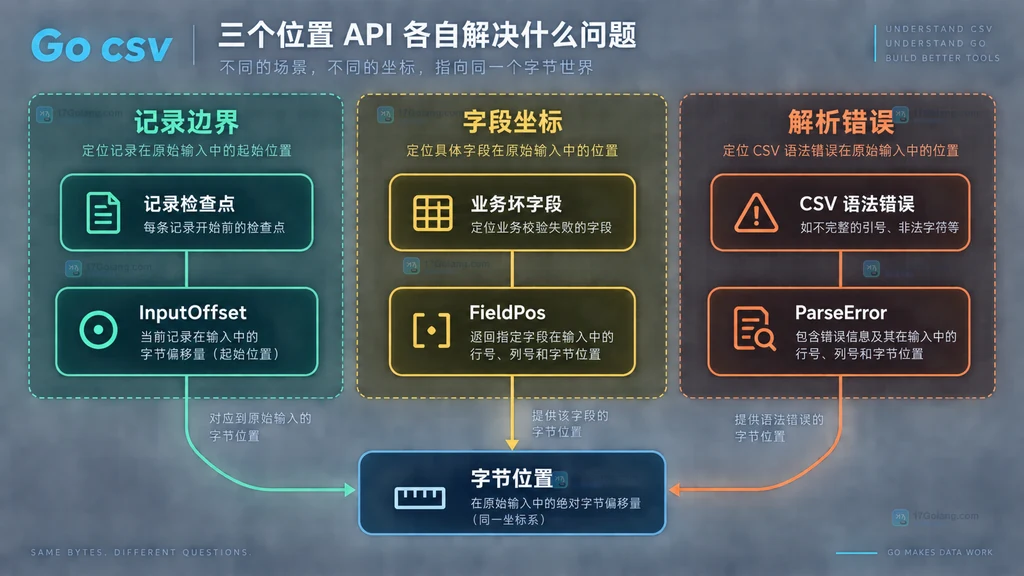
我现在会先问自己:要找的是“下一条记录从哪里开始”,还是“这一条里的某个字段从哪里开始”。前者用 InputOffset,后者用 FieldPos。如果 Read 本身因为 CSV 语法失败,则检查 *csv.ParseError。
相关问题
InputOffset 的单位是字符还是字节?
是输入流字节偏移。不要把它当成 Unicode 字符数量,也不要直接映射成编辑器显示列。
调用 InputOffset 会移动 Reader 吗?
不会。它读取 Reader 当前维护的位置,不会替你执行 Seek,也不会消费下一条记录。
为什么保存 offset 后仍可能重复处理一条?
通常是业务写入和检查点保存无法原子提交。写入成功、检查点失败时,恢复会从旧位置重放;使用业务幂等键或同一事务内保存数据与进度可以控制重复。
InputOffset 看起来不像当前字段位置,是因为它本来就不是为字段定位设计的。把它放回记录级检查点这个场景,再用 FieldPos 和 ParseError 补齐字段与语法坐标,三类位置就不会混淆。
 Go csv.Reader FieldPos 怎么定位坏字段
- 上一篇
- Go csv.Reader FieldPos 怎么定位坏字段
- 下一篇
- tuozi工具箱有哪些创作辅助工具?图片批量处理与思维导图入口说明
-
- Golang · Go问答 | 11分钟前 |
- Go csv.FieldsPerRecord 设为零为什么仍可能报错
- 301浏览 收藏
-
- Golang · Go问答 | 34分钟前 | go · utf-8 ·
- Go csv.FieldPos 为什么使用字节列而不是字符列
- 389浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go csv.ReuseRecord 开启后为什么上一行内容会变化
- 240浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go sql.Null[T] Valid 为 false 时 Value 为什么仍有零值
- 497浏览 收藏
-
- Golang · Go问答 | 2小时前 |
- Go sql.NamedArg 为什么会被驱动拒绝
- 233浏览 收藏
-
- Golang · Go问答 | 2小时前 | go · database/sql ·
- Go sql.Rows Next 返回 false 为什么不等于正常结束
- 171浏览 收藏
-
- Golang · Go问答 | 2小时前 | go · database/sql ·
- Go sql.Conn Raw 回调结束后为什么不能保留 driverConn
- 269浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- Go tls KeyLogWriter 为什么不应在生产环境长期启用
- 248浏览 收藏
-
- Golang · Go问答 | 3小时前 |
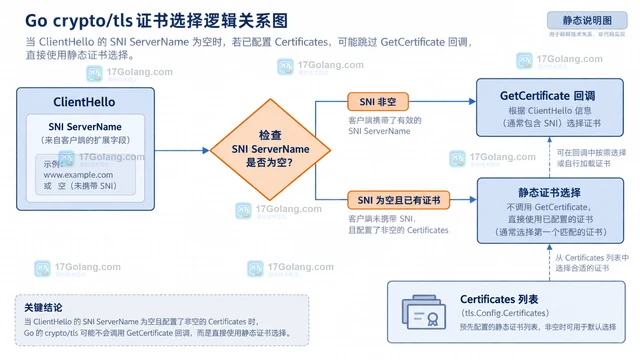
- Go tls.GetCertificate 为什么收不到空 ServerName 请求
- 501浏览 收藏
-
- Golang · Go问答 | 11小时前 | golang · TLS · Go tls.VerifyConnection TLS会话恢复 DidResume
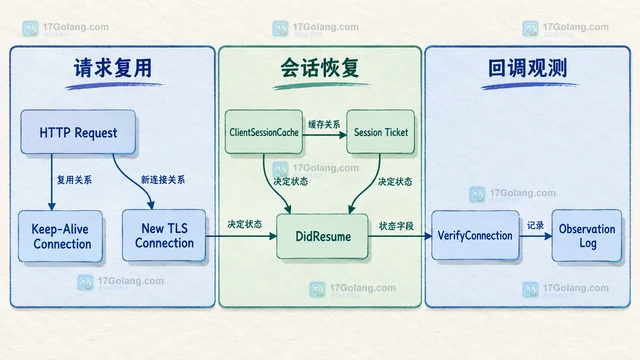
- Go tls.VerifyConnection 为什么在恢复会话时仍会执行
- 200浏览 收藏
-
- Golang · Go问答 | 12小时前 |
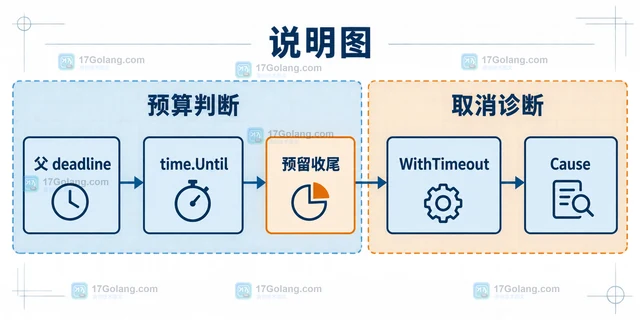
- Go context 子任务为什么会提前出现 deadline exceeded
- 298浏览 收藏
-
- Golang · Go问答 | 12小时前 | go · Context · 并发控制 · Go context Deadline WithoutCancel
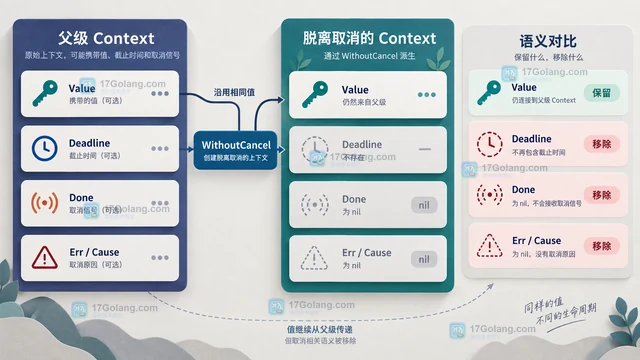
- Go context.WithoutCancel 为什么 Deadline 返回不存在
- 361浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 239次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 286次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 253次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 235次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 45次使用
-
- 用Nginx反向代理部署go写的网站。
- 2023-01-17 502浏览
-
- GoLand调式动态执行代码
- 2023-01-13 502浏览
-
- Go tls.GetCertificate 为什么收不到空 ServerName 请求
- 2026-09-27 501浏览
-
- Go sql.Tx提交成功前读取结果导致事务边界混乱的修复方法
- 2026-09-20 501浏览
-
- Go select 用 time.After 做超时有什么资源代价
- 2026-09-10 501浏览


