
Go flate Reset 后为什么还会读到上一段状态
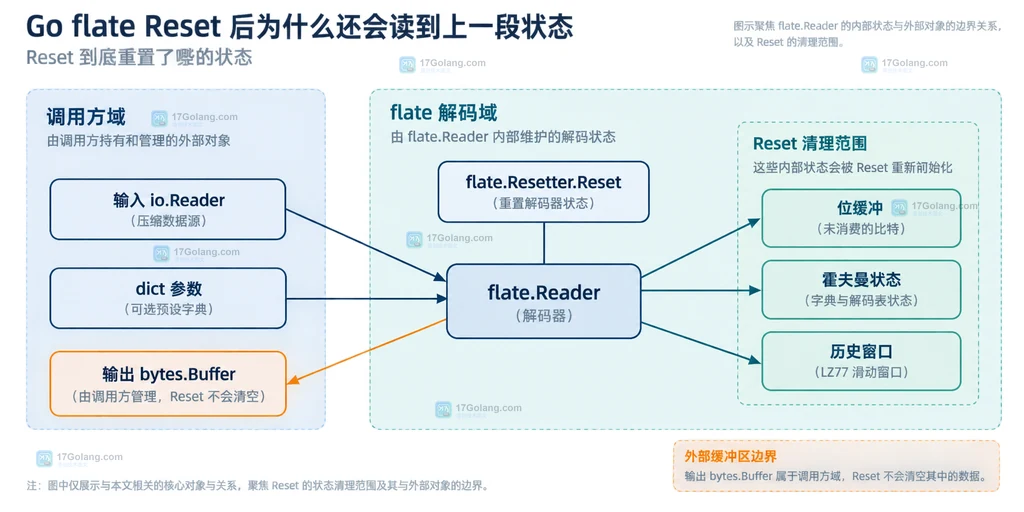
我在把多段 DEFLATE 数据放进复用池时遇到过一个很容易误判的现象:第二段调用 Reset 后,输出末尾像是上一段内容。先给结论:flate.Reset 会丢弃解压器自己的位缓冲、霍夫曼状态和历史窗口,并把它切换到新的 io.Reader;它不会替你清空 bytes.Buffer、移动输入 reader 的游标,也不会擦掉已经写入输出缓冲的字节。
- 旧内容仍在结果里,第一检查对象通常是输出缓冲,而不是 flate 内部状态。
- 每个压缩段都要准备独立的输入视图,并在 Reset 前后明确 reader、目标和字典。
- 读到
io.EOF才表示当前 DEFLATE 流结束;截断数据应按错误处理,不能静默进入下一段。
Reset 到底重置了哪些状态
flate.NewReader 返回的读对象同时实现 flate.Resetter。调用 Reset(r, dict) 后,解码器会按照“刚用这个 reader 初始化”的状态工作,并重新设置可选字典。它复用了已经分配的内存,所以适合高频解压,但“复用内存”不等于“复用上一段数据”。
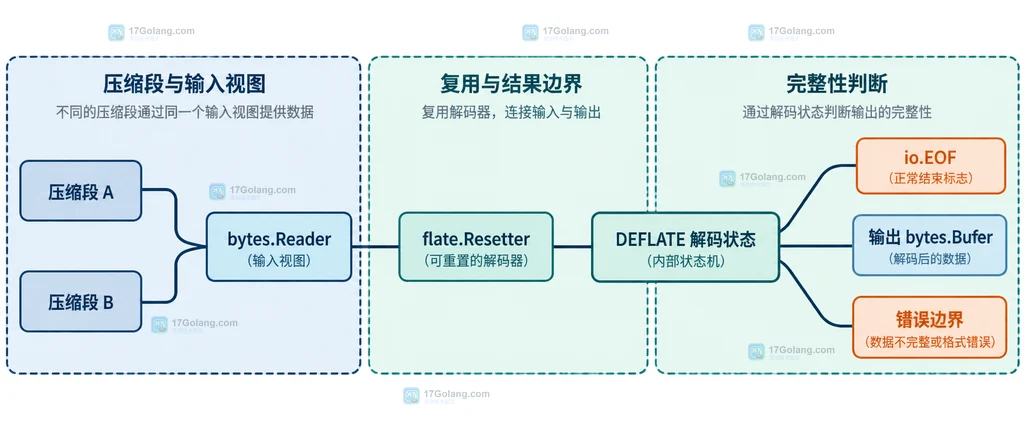
真正容易被忽略的是调用边界:r 只是新的数据来源,Reset 不知道你是否还在复用一个可写的 bytes.Buffer,也不知道你把上一次输出追加到了哪里。下面这张结构图把解压器内部边界和调用方缓冲边界分开,排查时先看外层。
一个不会混淆输入和输出的复用写法
复用时我会把“压缩数据的生成”和“解压数据的收集”分成两个明确的缓冲区。每轮开始先清空输出,压缩器写完并关闭当前段,再让解压器 Reset 到这段的输入。示例中的注释只解释关键边界,没有把运行结果冒充截图。
package main

import (
    "bytes"
    "compress/flate"
    "fmt"
    "io"
    "log"
)

func main() {
    messages := []string{"第一段数据", "第二段数据"}
    var compressed bytes.Buffer
    var output bytes.Buffer

    // 复用一个压缩器;每次 Reset 只更换压缩输出目标。
    zw, err := flate.NewWriter(&compressed, flate.DefaultCompression)
    if err != nil {
        log.Fatal(err)
    }
    // 解压器先绑定一个空 reader,后续通过 Resetter.Reset 换段。
    zr := flate.NewReader(bytes.NewReader(nil))
    defer zr.Close()

    for _, message := range messages {
        compressed.Reset()
        output.Reset()

        // Close 会写出当前 DEFLATE 段的结束信息,不能只调用 Write。
        zw.Reset(&compressed)
        if _, err := zw.Write([]byte(message)); err != nil {
            log.Fatal(err)
        }
        if err := zw.Close(); err != nil {
            log.Fatal(err)
        }

        // Reset 不会清空 output;本轮已经显式 Reset,避免旧结果继续存在。
        if err := zr.(flate.Resetter).Reset(bytes.NewReader(compressed.Bytes()), nil); err != nil {
            log.Fatal(err)
        }
        if _, err := io.Copy(&output, zr); err != nil {
            log.Fatal(err)
        }
        // 读到 EOF 后,output 只包含当前段;此处打印用于观察本轮结果。
        fmt.Printf("%s\n", output.String())
    }
}
这里有一个细节:示例把 compressed.Bytes() 交给 bytes.NewReader,所以每轮的输入游标从零开始。若直接复用同一个 *bytes.Reader,就必须在 Reset 前调用它的 Reset;若输入来自网络,则不能把“换了解压器”误认为“换了协议帧”。帧边界仍然要由上层协议准确切出。
读到上一段内容时,按四个边界定位
| 现象 | 优先检查 | 处理方式 |
|---|---|---|
| 结果前后都有旧文本 | 输出 bytes.Buffer 或复用切片 | 每段开始清空目标,或只读取本段新增长度 |
| 第二段开头就不对 | 输入 reader 游标、帧切分 | 使用新的 bytes.Reader,或显式调用输入对象的 Reset |
| 返回 corrupt input / unexpected EOF | 压缩段未 Close、数据被截断 | 写端完成 Close,读端把非 EOF 错误原样返回 |
| 换字典后内容异常 | Reset 的 dict 参数 | 压缩端与解压端使用同一字典;无字典时传 nil |
尤其不要在每次 Reset 后只读一次 Read 就认为当前段完成。一次 Read 可能只返回部分数据,应该持续读取直到 io.EOF,或者交给 io.Copy。官方实现会在最终 DEFLATE block 后返回 EOF;底层 reader 在不实现 io.ByteReader 时还可能被内部缓冲多读一些,因此协议层更应该先完成明确的帧切分。
上线前固定这份复用清单
- 一段压缩数据对应一个明确的输入 reader,不把上一段未消费的字节直接拼进下一段。
- 输出目标在段边界清空,或者为每段创建新的
bytes.Buffer。 - 写端总是检查
Close,读端持续到io.EOF,其他错误直接返回。 - 预置字典参与协议约定;Reset 时不要为了“清状态”随意把非 nil 字典改成 nil。
- 解压器不是并发安全对象;池化时每个并发任务独占实例,归还前确认本段已读完。
我的判断是:如果 Reset 后看到上一段内容,先不要给 flate 加锁或重建对象。先把输入、解码器和输出画成三个变量,逐个打印本轮长度与错误,通常几分钟就能找到是外部缓冲追加还是输入边界错位。只有确认对象被并发使用,才需要进一步检查池化生命周期。
常见问题
调用 flate.Reset 后还需要重新创建解压器吗?
不需要。它的目的就是复用已经分配的读对象;只有不需要复用、生命周期很短或并发隔离更重要时,重新创建才更简单。
Reset 会自动清空 bytes.Buffer 吗?
不会。bytes.Buffer 属于调用方对象,必须由调用方调用 Reset,或为本段使用新的 buffer。
为什么不能只看一次 Read 的返回值?
Reader 允许部分读取。要判断一段 DEFLATE 数据完整结束,应持续读到 io.EOF;遇到 io.ErrUnexpectedEOF 或其他错误则说明输入不完整或底层读取失败。
 cgroup v2 memory.high 与 memory.max 有什么区别
- 上一篇
- cgroup v2 memory.high 与 memory.max 有什么区别
- 下一篇
- Promise.withResolvers 适合封装哪些外部回调
-
- Golang · Go问答 | 23分钟前 |
- Go flate Flush 后接收端为什么仍拿不到完整数据
- 278浏览 收藏
-
- Golang · Go问答 | 52分钟前 |
- Go flate HuffmanOnly 为什么文件可能比原数据更大
- 262浏览 收藏
-
- Golang · Go问答 | 1小时前 | 故障排查 · Go问答 · Go compress/flate DEFLATE 预置字典 NewReaderDict
- Go flate 预置字典不一致为什么只在读取时失败
- 320浏览 收藏
-
- Golang · Go问答 | 1小时前 | go · bytes Go切片 bytes.Clone
- Go bytes.Clone 后修改原切片为什么不再影响副本
- 209浏览 收藏
-
- Golang · Go问答 | 2小时前 | 标准库 · Go问答 · Go Seek bytes.Reader io.Seeker
- Go bytes.Reader Seek 为什么允许定位到末尾之后
- 347浏览 收藏
-
- Golang · Go问答 | 2小时前 |
- Go bytes.Buffer Next 为什么会改变后续 Len
- 139浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- Go bytes.CutPrefix 返回 false 时切片为什么仍可复用
- 303浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- Go bufio.Writer Flush 为什么只返回第一次写入错误
- 143浏览 收藏
-
- Golang · Go问答 | 6小时前 | go · copy archive/zip CreateHeader FileHeader CreateRaw
- Go archive/zip Copy 为什么不能修改文件头字段
- 334浏览 收藏
-
- Golang · Go问答 | 7小时前 | go · archive/zip Reader.Open ZIP路径
- Go archive/zip Open 为什么找不到带反斜杠的文件名
- 374浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 229次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 275次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 244次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 224次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 23次使用
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- go语言中的defer关键字
- 2023-02-17 150浏览
-
- Golang中Interface接口的三个特性
- 2023-01-07 394浏览
-
- go语言中函数与方法介绍
- 2023-01-07 297浏览
-
- go语言数据类型之字符串string
- 2022-12-30 321浏览


