
Linux curl分段下载大文件并校验完整性的实现
Linux 上处理几个 GB 甚至更大的文件时,可以把文件按字节区间拆成多个片段,用 curl --range 分别保存,再按顺序合并。真正决定结果是否可靠的不是“命令执行完了”,而是每段都返回了预期范围、合并后的字节数正确,并且最终 SHA-256 摘要与发布方提供的值一致。
官方文档:https://curl.se/docs/manpage.html
推荐把“分段下载、片段检查、顺序合并、摘要校验”做成一个有失败出口的脚本。只要服务端忽略 Range 返回 200,就立即停止,不能把完整响应误当成某一段。
先确认 curl 分段下载的前提
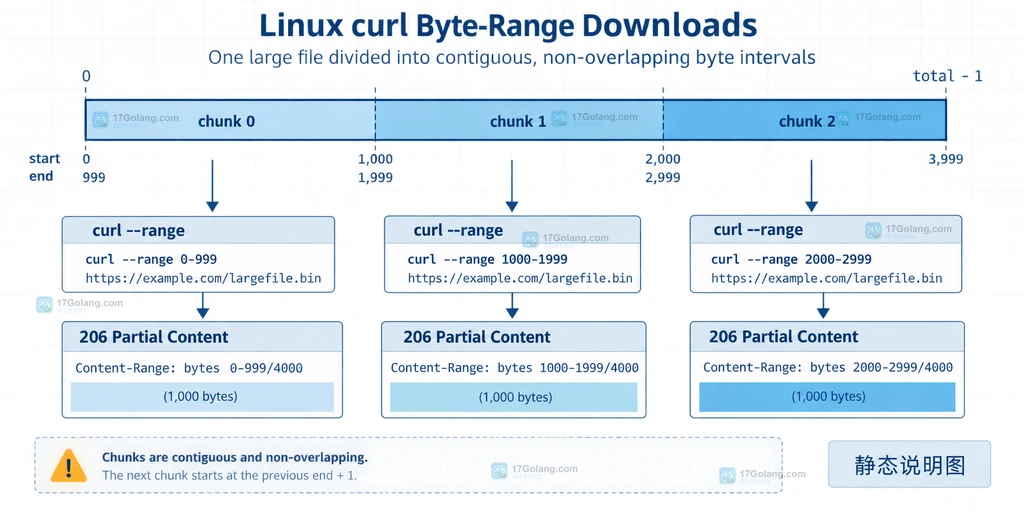
--range start-end 表示请求指定的字节范围,例如 0-1048575 是前 1 MiB。curl 官方手册也提醒,部分 HTTP 服务端不支持 Range,收到请求后会直接返回完整文件;这时响应通常是 200,而不是 206 Partial Content。--continue-at 是从已有文件偏移处续传,和 --range 不能在一次传输中混用,二者不要混成一个恢复逻辑。
因此,脚本至少需要三个已知量:下载地址、文件总长度 total、分片大小 chunk。总长度应来自可信的发布清单或已确认的响应头,不要用一次失败下载得到的本地大小反推。
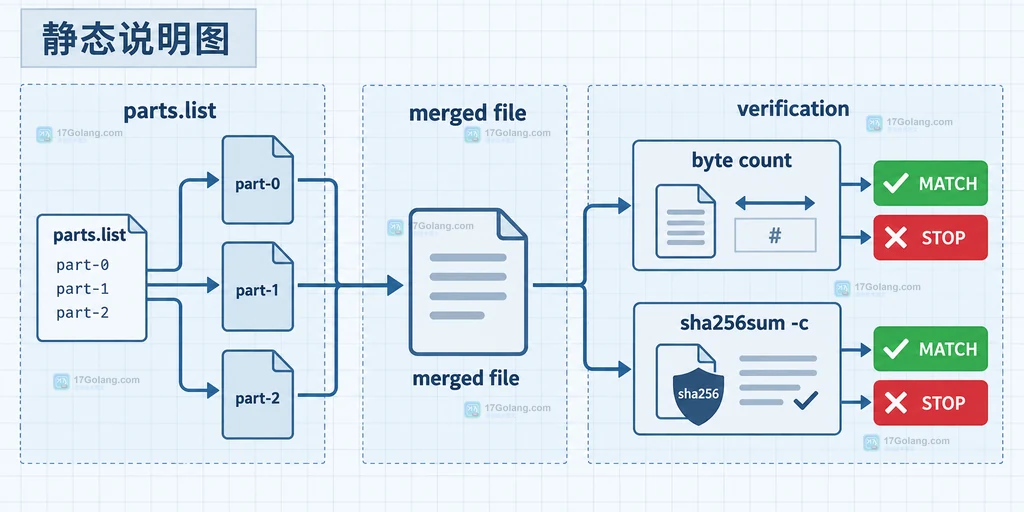
固定边界并检查每个片段
下面的脚本采用顺序下载,便于排查。每一段的结束位置是 start + chunk - 1,最后一段再限制为 total - 1。保存片段前检查 HTTP 状态,保存后检查实际字节数,两个条件任何一个不满足都退出。
#!/usr/bin/env bash
# 这段脚本按固定字节区间下载,并拒绝服务端忽略 Range 的响应。
set -euo pipefail

url="https://mirror.example.org/releases/demo.tar.zst"
total=838860800                 # 这里填写已确认的总字节数,不用本地文件大小猜测
chunk=$((64 * 1024 * 1024))     # 每段 64 MiB,按网络和磁盘情况调整
work="demo.parts"
output="demo.tar.zst"
mkdir -p "$work"
: > "$work/parts.list"          # 清空旧清单,避免混入上一次失败的片段

for ((start=0; start= total )) && end=$((total - 1))
  part="$work/part-${start}-${end}"
  header="$part.headers"

  # --fail 遇到HTTP错误退出;--range只请求当前闭区间。
  curl --fail --show-error --location \
    --range "${start}-${end}" \
    --dump-header "$header" \
    --output "$part" "$url"

  # Range成功应得到206;否则说明服务端可能返回了整文件,立即停止。
  status=$(awk '/^HTTP\// { code=$2 } END { print code }' "$header")
  [[ "$status" == "206" ]] || { echo "Range未生效: HTTP $status" >&2; exit 1; }

  expected=$((end - start + 1))
  actual=$(wc -c &2; exit 1; }
  printf '%s\n' "$part" >> "$work/parts.list"
done
按清单合并并做两层确认
下载成功不代表最终文件正确。合并时只读取当前清单中的片段,并用追加模式保持顺序;随后先比较字节数,再比较摘要。字节数能较快发现漏段或重复段,摘要则能发现内容被替换、截断但长度碰巧相同等问题。
# 只按下载阶段写入的顺序合并,避免通配符排序改变片段次序。
rm -f "$output"
while IFS= read -r part; do
  cat "$part" >> "$output"
done &2
  exit 1
}

# checksum.txt 的格式必须是“摘要 空格 文件名”,供 sha256sum -c 读取。
sha256sum "$output" > "$work/local.sha256"
sha256sum -c checksum.txt
echo "下载、合并和SHA-256校验完成: $output"
如果发布方只给出一串摘要,也可以先生成本地结果,再用 sha256sum 的输出比较;不要把摘要写进未经确认的 checksum.txt 后再对自己生成的文件做“自证”。摘要文件应来自发布方、镜像目录或签名清单。
失败时按证据定位,不要盲目重试
看到 200 时,先确认服务端是否支持 Range、重定向后的地址是否改变,以及代理是否移除了 Range 请求。看到片段长度不符时,检查是否遇到压缩传输、服务端动态内容或边界计算错误;不要直接把响应追加到最终文件。若只有某一段失败,可以删除该段及其响应头后重新下载,但要再次检查状态、长度和清单顺序。
如果最终摘要失败,优先对比片段清单和总字节数,再逐段重新计算摘要,定位是漏段、重复段还是源文件本身已经更新。下载过程中源文件发生变化时,即使每段都是 206,拼出来的文件也可能没有任何一个稳定版本的摘要;此时应固定版本 URL 或使用带版本标识的发布清单。
速查清单与常见疑问
- Range 生效:每段响应为 206,且实际字节数等于
end-start+1。 - 边界无重叠:第一段从 0 开始,最后一段结束于
total-1。 - 合并可复现:使用固定清单,不依赖目录通配符顺序。
- 校验可信:摘要来自发布方,不能用本地刚生成的摘要代替。
curl 不支持 Range 怎么办?这通常不是 curl 参数写错,而是服务端没有启用字节范围,或中间代理改变了响应。改用普通下载或更换支持 Range 的镜像,并保留完整性校验。
为什么不直接用 -C -?--continue-at适合单文件断点续传;需要并行、重试单段或保存每段证据时,显式的 Range 清单更容易控制边界和恢复。
 Go t.Cleanup登记资源释放动作的测试结构
- 上一篇
- Go t.Cleanup登记资源释放动作的测试结构
- 下一篇
- Go embed路径使用反斜杠导致跨平台读取失败的排查
-
- 文章 · linux | 2小时前 |
- Linux rsync保留权限与删除多余文件的迁移清单
- 403浏览 收藏
-
- 文章 · linux | 3小时前 | Linux ·
- Linux find按文件大小和修改时间清理缓存的安全流程
- 293浏览 收藏
-
- 文章 · linux | 4小时前 | Linux · Linux 日志轮转 logrotate postrotate
- Linux logrotate配合postrotate通知服务重开日志的配置
- 220浏览 收藏
-
- 文章 · linux | 5小时前 | Linux · 运维排查 · Linux systemd journalctl 日志过滤
- Linux journalctl按服务与时间窗口过滤日志的命令组合
- 495浏览 收藏
-
- 文章 · linux | 7小时前 | linux运维 · Linux systemd 启动顺序 network.target network-online.target
- Linux systemd依赖网络就绪状态的启动顺序配置
- 496浏览 收藏
-
- 文章 · linux | 8小时前 | Linux · Linux 环境变量 systemd EnvironmentFile
- Linux systemd用EnvironmentFile处理带空格值的配置方法
- 204浏览 收藏
-
- 文章 · linux | 13小时前 | Linux · Linux tar strip-components GNU tar
- Linux tar用 strip-components 控制解包目录层级的实现方法
- 104浏览 收藏
-
- 文章 · linux | 14小时前 | Linux 文件句柄 ulimit /proc/PID/limits Max open files
- Linux /proc/PID/limits核对服务实际文件句柄上限的实现方法
- 253浏览 收藏
-
- 文章 · linux | 15小时前 |
- Linux mount namespace选择 shared、private 与 slave 传播属性的实现方法
- 204浏览 收藏
-
- 文章 · linux | 17小时前 | Linux · 策略路由 ip rule Linux ip route fibmatch
- Linux ip route读取策略路由表的命中路径的实现方法
- 451浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 136次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 202次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 147次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 127次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 115次使用
-
- 详解golang执行Linuxshell命令完整场景下的使用方法
- 2023-01-07 426浏览
-
- go程序部署到linux上运行的实现方法
- 2023-01-02 387浏览
-
- Linux系统下Go语言开发环境搭建
- 2023-01-07 242浏览
-
- 使用golang获取linux上文件的访问/创建/修改时间
- 2022-12-31 238浏览
-
- 在Linux系统中安装Go语言的详细教程
- 2022-12-29 402浏览


