
Python打包元数据标准化后的构建流水线调整方法
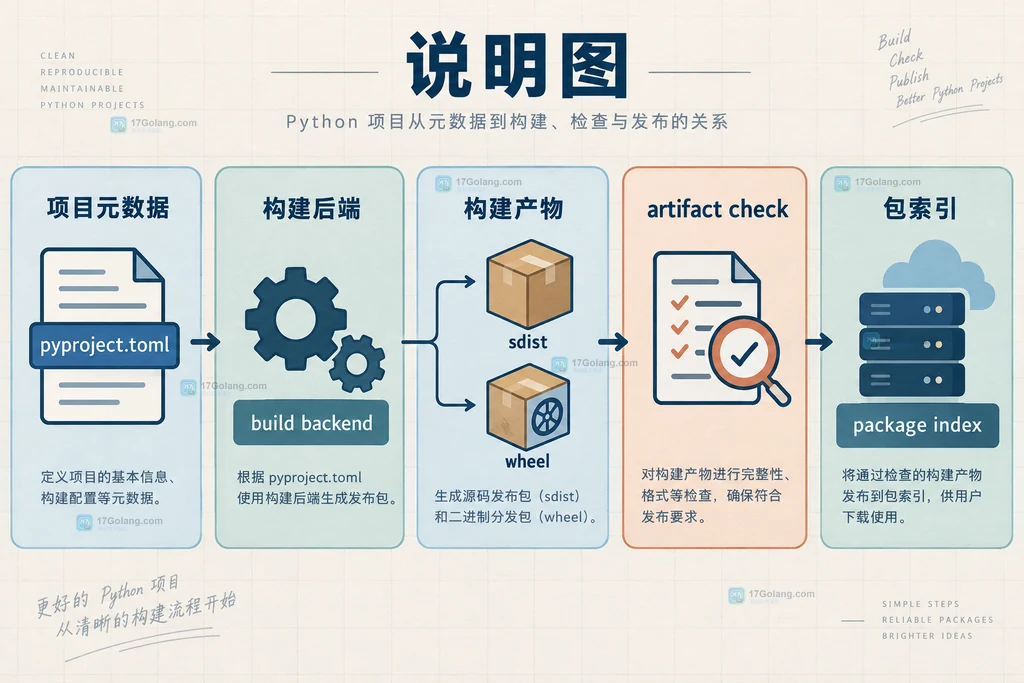
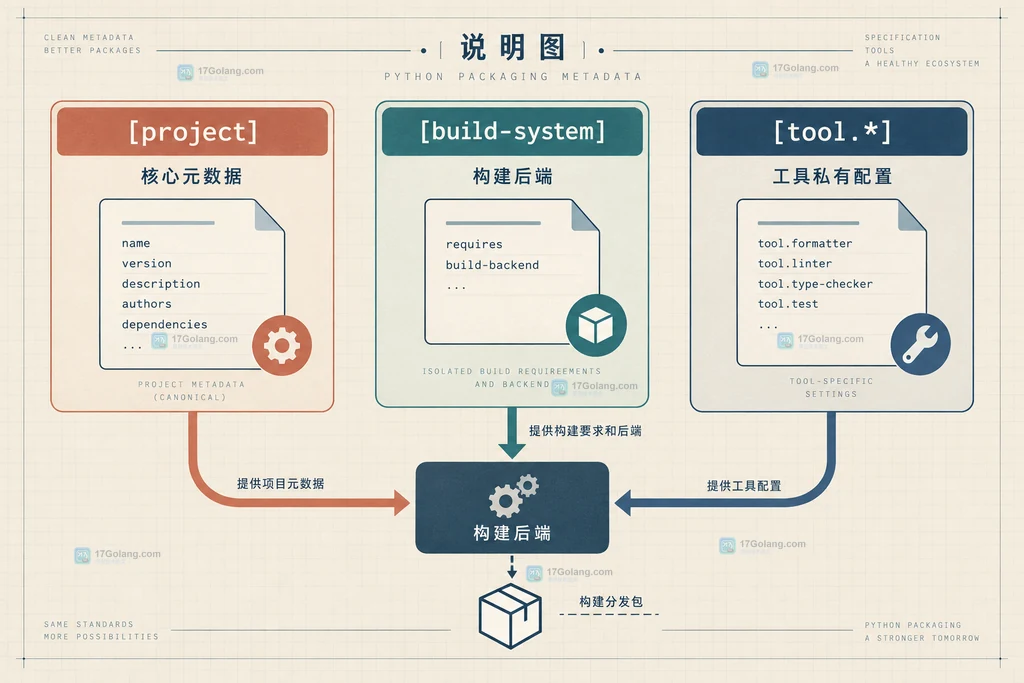
Python 打包配置正在从“每个工具一套写法”转向更清晰的分层:pyproject.toml 里的 [project] 负责项目元数据,[build-system] 负责构建后端,[tool] 保留工具私有配置。调整流水线时,重点不是把所有配置机械搬家,而是先让元数据、构建和发布各自只有一个责任边界。
官方资料入口:https://packaging.python.org/ 规范原文:https://peps.python.org/pep-0621/
[project]是跨后端共享核心元数据的入口,静态字段优先,动态字段必须显式声明。[build-system]只描述构建所需依赖和后端;[tool.*]才放工具专属选项。- CI 应把构建、产物检查、上传拆开,发布对象是
dist/下的 sdist 和 wheel,而不是源码目录。
先把三类配置分开,迁移才不会反复返工
旧项目通常同时存在 setup.py、setup.cfg、pyproject.toml 和 CI 脚本。第一步先做一张映射表:包名、版本、依赖、Python 版本范围、入口点属于项目元数据;构建后端名称和构建依赖属于构建系统;lint、测试覆盖率或格式化工具的开关属于 [tool.*]。
PEP 621 规定,[project] 中直接写出的静态值是规范值,后端不能悄悄改写;只有列在 dynamic 中的字段才交给后端补充。因此,不要为了保留旧脚本的“自动读版本”习惯,把所有字段都声明成动态。
用 pyproject.toml 固定构建后端与核心元数据
一个采用 setuptools 后端的迁移起点如下。注释只说明字段职责,依赖版本应结合项目支持范围锁定:
[build-system]
# 构建隔离环境先安装这些依赖,再调用后端生成产物
requires = ["setuptools>=77.0.3"]
build-backend = "setuptools.build_meta"

[project]
# 这些字段是发布给索引和安装工具读取的核心元数据
name = "sample-library"
version = "2.4.0"
description = "A small example library"
readme = "README.md"
requires-python = ">=3.9"
dependencies = ["httpx>=0.27"]

[tool.pytest.ini_options]
# 工具私有配置放在自己的命名空间,避免污染 [project]
addopts = "-q"
版本如果仍由 SCM 或后端计算,应改成 dynamic = ["version"],并确认该后端确实提供版本;否则构建时会出现“元数据缺失”,而不是由上传工具修复。许可证、入口点和可选依赖也要逐项迁移,不要把旧配置文件继续作为第二个事实源。
调整流水线:构建、检查、上传各做一件事
标准化元数据后,CI 可以拆成三个稳定阶段。先在隔离环境构建,再只检查 dist/ 中的文件名、版本和元数据,最后交给上传工具:
# 构建 sdist 和 wheel;命令只负责生成发布产物
python -m build

# 检查产物目录,上传阶段不要重新从源码猜版本
python -m twine check dist/*

# 通过仓库凭据上传已经检查过的产物
python -m twine upload dist/*
Python Packaging User Guide 将 build 作为生成 sdist 和 wheel 的标准工具,并把 twine 放在上传阶段。这样做的好处是:后端可以替换,产物检查规则不变;仓库从 TestPyPI 切换到 PyPI 时,也只改发布凭据和目标配置。
迁移验收清单与容易踩的边界
| 检查项 | 应确认的结果 | 常见误区 |
|---|---|---|
| 构建后端 | [build-system] 的 requires 与 build-backend 成对存在 | 只写后端名,忘记隔离环境依赖 |
| 核心元数据 | [project] 至少有稳定的 name,版本来源明确 | setup.py 和 pyproject.toml 同时维护两份版本 |
| 发布产物 | 同时检查 sdist 与 wheel 的版本、依赖和 Python 范围 | 只上传 wheel,导致部分环境退回源码构建 |
| 工具配置 | pytest、ruff 等位于各自的 [tool.*] | 把工具私有键塞进 [project] 造成后端报错 |
常见问题
迁移到 pyproject.toml 后还要删除 setup.py 吗?
不必立即删除。若项目仍需要程序化配置或扩展模块,可以保留它;但同一个元数据字段应只保留一个权威来源,避免构建后端读取结果不一致。
为什么写了 version 还提示版本缺失?
检查后端是否把该字段声明为动态、版本插件是否在 build-system.requires 中可用,以及 CI 是否在正确的源码根目录执行构建。
发布前一定要同时生成 sdist 和 wheel 吗?
对需要兼容不同平台或安装环境的库,通常应同时提供两者;纯 Python 包的 wheel 较简单,含原生扩展时还要按 Python、系统和架构准备对应 wheel。
 Go crypto/rand生成短期令牌并避免编码损失的方案
- 上一篇
- Go crypto/rand生成短期令牌并避免编码损失的方案
- 下一篇
- Go range复制大结构体导致循环变慢的改写方式
-
- 科技周边 · 业界新闻 | 35分钟前 |
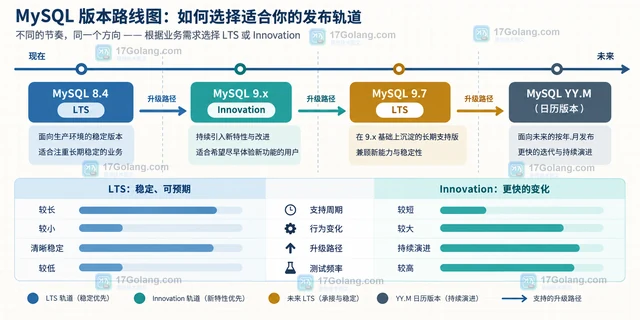
- MySQL LTS与创新版本迁移窗口的评估清单
- 265浏览 收藏
-
- 科技周边 · 业界新闻 | 2小时前 | go · 业界新闻 · encoding/json · 版本迁移 · 兼容性 · encoding/json Go工具链 jsonv2 Go 1.27 JSON兼容性
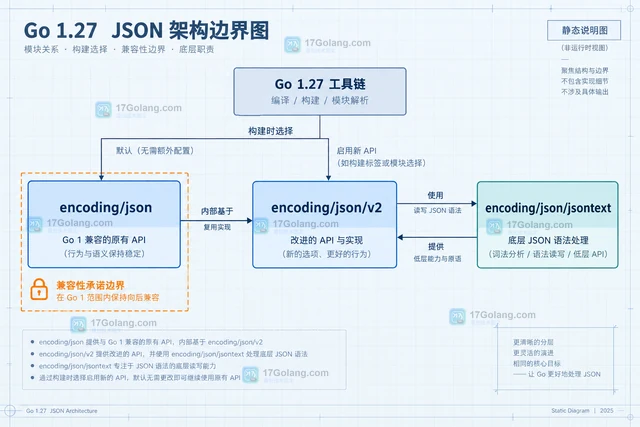
- Go工具链JSON实验开关对编码兼容性的影响范围
- 293浏览 收藏
-
- 科技周边 · 业界新闻 | 4小时前 | 架构设计 · 业界新闻 · WebAssembly WASI WIT 服务边界 组件模型
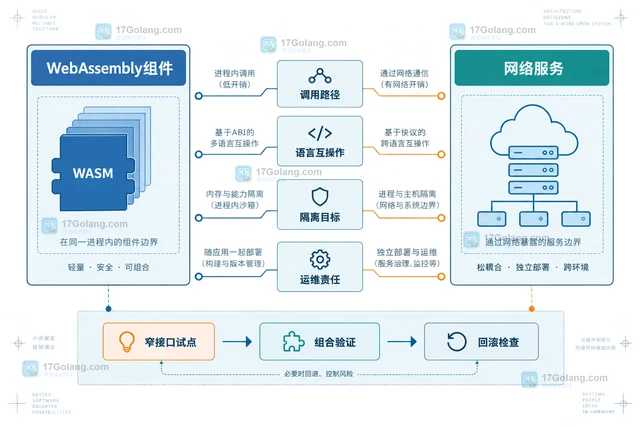
- WebAssembly组件模型在服务边界选择中的判断表
- 272浏览 收藏
-
- 科技周边 · 业界新闻 | 5小时前 | CI · 供应链安全 ·
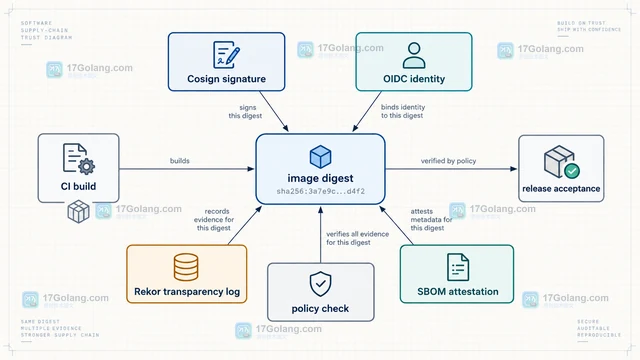
- CNCF供应链签名在CI产物验收中的接入方案
- 105浏览 收藏
-
- 科技周边 · 业界新闻 | 6小时前 |
- Kubernetes Gateway API按Header拆分路由的配置方法
- 391浏览 收藏
-
- 科技周边 · 业界新闻 | 7小时前 | 日志 · 可观测性 · OpenTelemetry trace trace_id 日志关联 span_id
- OpenTelemetry日志与Trace关联字段的落地清单
- 375浏览 收藏
-
- 科技周边 · 业界新闻 | 9小时前 |
- 分布式系统迁移到统一遥测协议时如何设计双写和回退窗口
- 147浏览 收藏
-
- 科技周边 · 业界新闻 | 11小时前 | 容器 · 容器镜像多架构 manifest list OCI image index 运行节点架构 digest校验
- 容器镜像多架构发布如何校验 manifest list 与运行节点匹配
- 334浏览 收藏
-
- 科技周边 · 业界新闻 | 12小时前 | 云原生 OpenFeature feature flag Provider Evaluation Context
- 云原生应用采用 OpenFeature 时如何隔离旗标评估与业务代码
- 418浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 136次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 201次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 146次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 127次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 115次使用
-
- go格式“占位符”输入输出 类似python的input
- 2023-01-19 346浏览
-
- Golang如何调用Python代码详解
- 2023-01-07 235浏览
-
- HTTP 的 response 中的响应体和头部是分开发送的吗?
- 2023-01-28 387浏览
-
- B站等视频网站的弹幕用的是 websocket 还是轮询?
- 2023-02-16 447浏览
-
- Linux 下有什么命令行工具以时序显示 CPU 占用率?
- 2023-01-13 360浏览


