
Go encoding/csv理解 LazyQuotes 的容错范围的参数对比
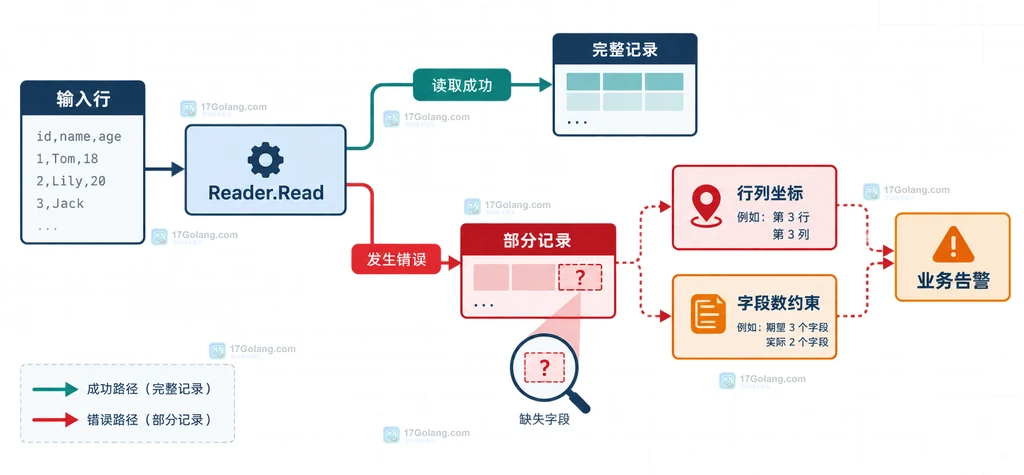
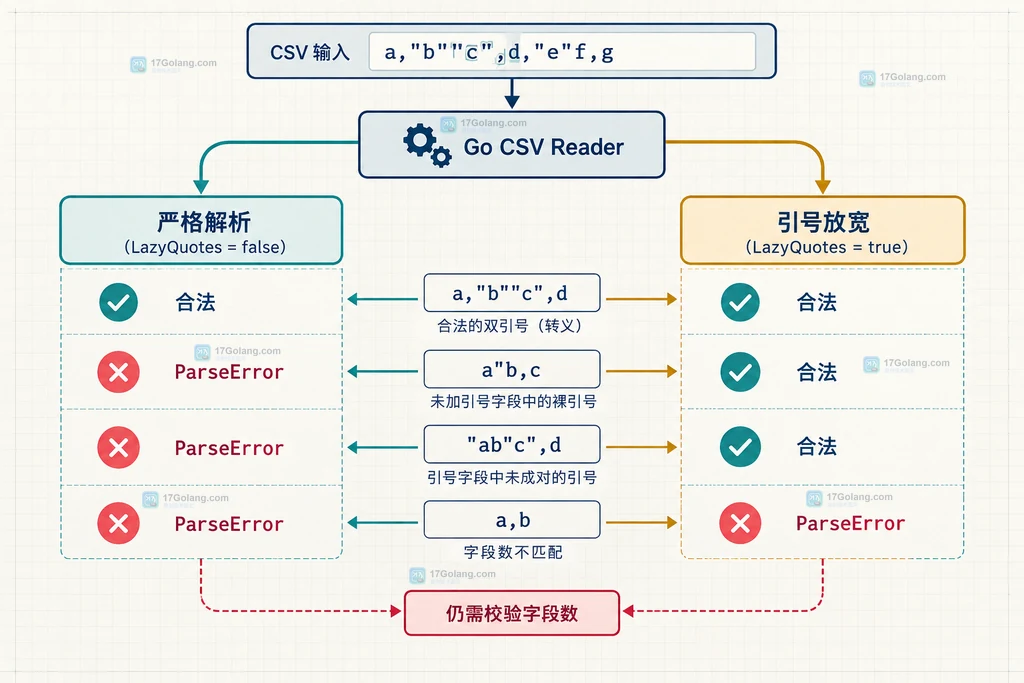
导入供应商 CSV 时,最容易误判的一点是:LazyQuotes 不是“忽略所有引号错误”。它只让 encoding/csv.Reader 放宽两类引号检查:裸字段里出现引号,以及带引号字段里出现没有成对转义的引号。字段数量不一致、分隔符错误和业务字段内容异常,仍然要单独处理。
官方地址:https://pkg.go.dev/encoding/csv
LazyQuotes=true适合接收历史脏文件,但会降低格式错误的可见性。Read可能同时返回部分记录和解析错误,不能只看记录是否非空。- 生产导入应保留
FieldsPerRecord、ParseError和行列位置,容错与追踪要一起设计。
先区分 RFC 4180 规则与 LazyQuotes 的放宽范围
默认的 Reader 按 RFC 4180 风格读取 CSV:字段可以不加引号,也可以用双引号包住;字段内部的双引号要写成两个双引号。比如 "a ""quoted"" value" 是合法的转义写法。问题通常来自历史导出程序,它把一句包含引号的文本直接写进了未加引号的字段。
LazyQuotes 打开后,Reader 对这些引号不再立即拒绝,但它没有替你判断这条数据是否可信。它也不会改变逗号的语义、自动补齐缺失列,更不会把任意半截 CSV 变成完整记录。这里的“容错”应该理解成延迟格式决策,而不是无条件清洗。
用同一份输入对比关闭与开启参数
下面的示例故意放入一个未加引号的裸字段引号和一个字段数量错误,观察两个参数的职责边界。示例只展示读取策略,输出中的错误信息应以当前 Go 版本实际返回为准。
package main

import (
    "encoding/csv"
    "fmt"
    "io"
    "strings"
)

func readCSV(lazy bool) {
    // 第一行含有裸引号;第二行少一个字段,用来区分两类问题。
    input := "id,note,score\n1,He said \"ok\",90\n2,only-two-fields\n"
    reader := csv.NewReader(strings.NewReader(input))
    reader.LazyQuotes = lazy
    reader.FieldsPerRecord = 3 // 固定列数,避免容错掩盖数据缺列。

    for {
        record, err := reader.Read()
        if err == io.EOF {
            break
        }
        fmt.Printf("lazy=%v record=%q err=%v\n", lazy, record, err)
        if err != nil {
            // Read 可能返回部分记录;这里记录错误后决定是否继续导入。
            continue
        }
    }
}

func main() {
    readCSV(false)
    readCSV(true)
}
对比时要看两件事。关闭参数时,裸字段中的引号通常触发 ErrBareQuote;开启后,这类行可能被读出,但少列记录仍会触发 ErrFieldCount。因此,看到 LazyQuotes=true 下循环继续,并不代表所有记录都已经通过校验。
更稳妥的做法是把容错范围写进导入策略:来自人工维护的旧文件可以允许继续读并进入隔离区;来自财务结算或接口交换的文件则保持严格模式,直接拒绝并回传行号。
把容错参数放进可追踪的读取策略
Reader 的错误不是只有一个字符串。ParseError 带有开始行、出错行和字节列号;Read 也可能返回错误发生前已经解析出的部分字段。把这些信息写入日志,比简单地打印“CSV 格式错误”更适合定位供应商文件。
package main

import (
    "encoding/csv"
    "errors"
    "fmt"
    "io"
    "strings"
)

func importRows(input string) {
    // 容错只负责读取;错误记录进入复核,不直接当成可信业务数据。
    r := csv.NewReader(strings.NewReader(input))
    r.LazyQuotes = true
    r.FieldsPerRecord = 3

    for {
        row, err := r.Read()
        if err == io.EOF {
            return
        }
        if err != nil {
            var parseErr *csv.ParseError
            if errors.As(err, &parseErr) {
                // 行列是追踪坐标;列号按字节计,不是 Unicode 字符数。
                fmt.Printf("quarantine line=%d column=%d row=%q err=%v\n", parseErr.Line, parseErr.Column, row, parseErr.Err)
            } else {
                fmt.Printf("quarantine row=%q err=%v\n", row, err)
            }
            continue
        }
        fmt.Printf("accept id=%s note=%s score=%s\n", row[0], row[1], row[2])
    }
}
这里故意不把错误行直接写入业务表:即使 LazyQuotes 让它读出来,部分记录也可能缺字段或包含无法确认的边界。若业务必须“尽量导入”,可以把原始行、错误类型和位置放进隔离表,待人工或二次清洗后再入主表。
按数据来源决定是否启用 LazyQuotes
| 输入来源 | 建议 | 原因 |
|---|---|---|
| 人工导出的历史表格 | 可开启并隔离异常行 | 优先保证读取进度,但必须保留错误坐标 |
| 系统间接口文件 | 默认关闭 | 格式契约应尽早失败,避免脏列进入后续计算 |
| 结算、库存、对账文件 | 关闭并固定列数 | 容错可能让金额或主键错位,风险高于少导入一批 |
我的判断是:LazyQuotes 适合作为“兼容旧输入”的边界开关,不适合作为数据质量开关。开启前先回答三个问题:错误行是否能隔离?是否能拿到原始文件和行列位置?业务是否允许人工补录?三个答案有一个是否定的,就应优先修复上游导出格式。
相关问题
LazyQuotes 会忽略字段数量错误吗?
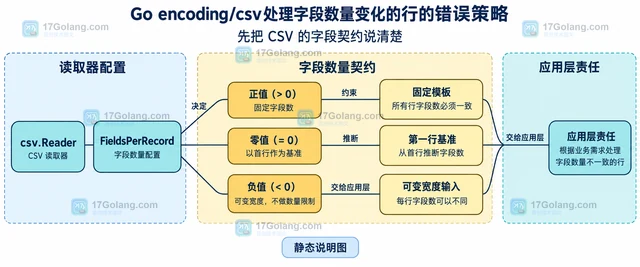
不会。字段数量由 FieldsPerRecord 控制;正数表示固定列数,零会以第一条记录的列数作为基准,负数才是不检查列数。
Read 返回 record 和 error 时应该丢弃 record 吗?
不要直接当成成功记录。先根据错误类型判断,通常将部分记录和原始行一起放入隔离区,只有业务明确允许的格式错误才进入清洗流程。
LazyQuotes 能修复 CSV 中的逗号错位吗?
不能。它只影响引号解析;逗号、列数和字段业务含义仍需由 Reader 配置与业务校验共同保证。
 Docker volume为有状态容器规划备份入口的实现方法
- 上一篇
- Docker volume为有状态容器规划备份入口的实现方法
- 下一篇
- LibTV无限画布适合什么任务?输入、参数与输出说明
-
- Golang · Go问答 | 37分钟前 |
- Go encoding/xml用 Token 读取混合内容的解析方法
- 376浏览 收藏
-
- Golang · Go问答 | 54分钟前 |
- Go encoding/gob为结构体新增字段保留兼容性的迁移方案
- 110浏览 收藏
-
- Golang · Go问答 | 1小时前 | go ·
- Go encoding/gob在长连接中复用 Gob 编解码器的边界
- 371浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go encoding/gob让接口字段带上可解码类型的注册方法
- 181浏览 收藏
-
- Golang · Go问答 | 1小时前 | go ·
- Go encoding/csv用 InputOffset 定位原始错误的排查方法
- 398浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go encoding/csv处理字段数量变化的行的错误策略
- 291浏览 收藏
-
- Golang · Go问答 | 2小时前 | go · Go 目标目录 archive/tar 解包
- Go archive/tar解包时限制目标目录的安全方案
- 115浏览 收藏
-
- Golang · Go问答 | 3天前 | go · TypeSymlink Go archive/tar链接条目 Tar硬链接 Tar符号链接 Header.Linkname TypeLink
- Go archive/tar识别 Tar 硬链接与符号链接的排查指南
- 459浏览 收藏
-
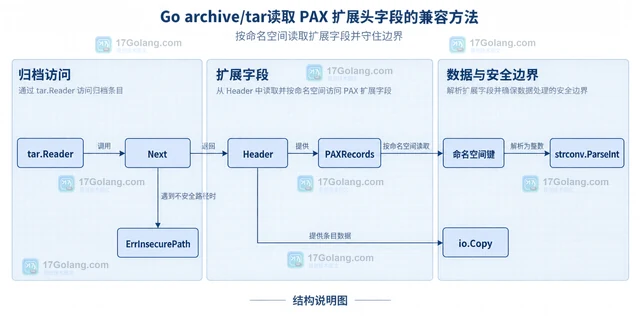
- Golang · Go问答 | 3天前 |
- Go archive/tar读取 PAX 扩展头字段的兼容方法
- 487浏览 收藏
-
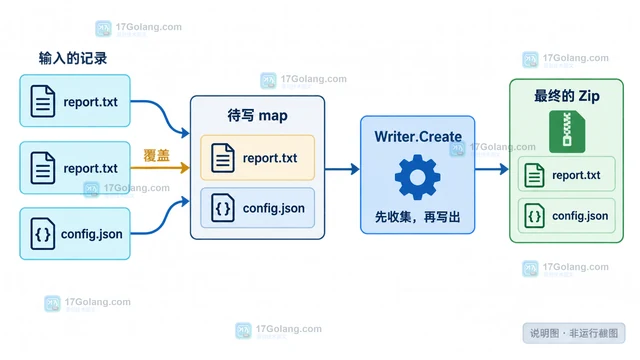
- Golang · Go问答 | 3天前 | go · Go archive/zip Go Zip重复条目 Go Writer.Create Go压缩包去重 Go Zip覆盖策略
- Go archive/zip写入 Zip 时处理重复条目的实现方法
- 435浏览 收藏
-
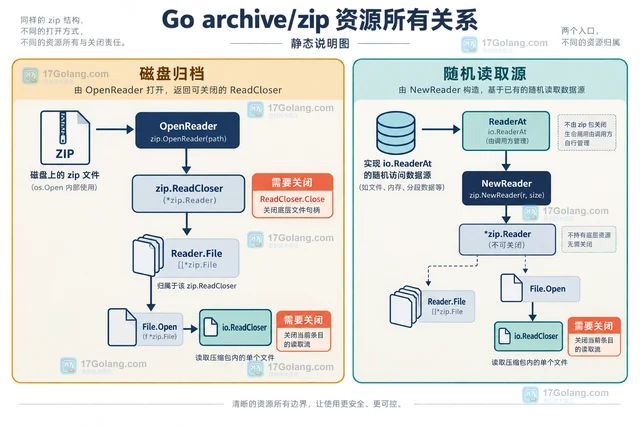
- Golang · Go问答 | 3天前 | 文件读取 · Go问答 · Go archive/zip File.Open OpenReader Zip读取
- Go archive/zip读取 Zip 文件并及时关闭的资源方案
- 175浏览 收藏
-
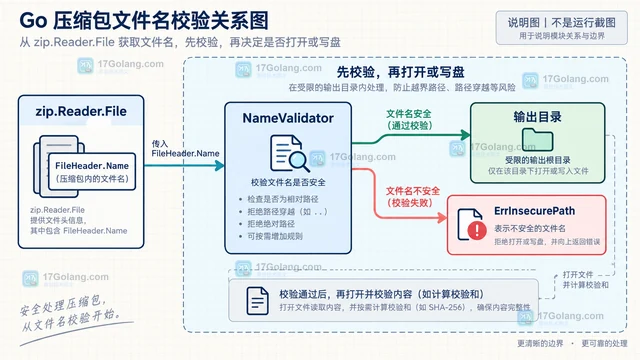
- Golang · Go问答 | 3天前 | go · Go archive/zip文件名校验 Go ZIP路径安全 Go压缩包目录穿越防护 Go ErrInsecurePath Go解压文件名检查
- Go archive/zip校验压缩包内文件名的安全边界
- 187浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 121次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 196次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 139次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 113次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 95次使用
-
- go语言标准库fmt包的一键入门
- 2023-01-24 335浏览
-
- golang如何操作csv文件详解
- 2023-01-19 361浏览
-
- 深入解析golang中的标准库flag
- 2023-01-21 372浏览
-
- Go 大文件 CSV 导出怎么做稳:从全量查询到流式写出架构
- 2026-07-08 251浏览
-
- Go 批量 CSV 导入怎么控内存:流式读取、资源预算和失败行回传实战
- 2026-07-20 407浏览


