
Python csv为不同分隔符注册 Dialect的实现方法
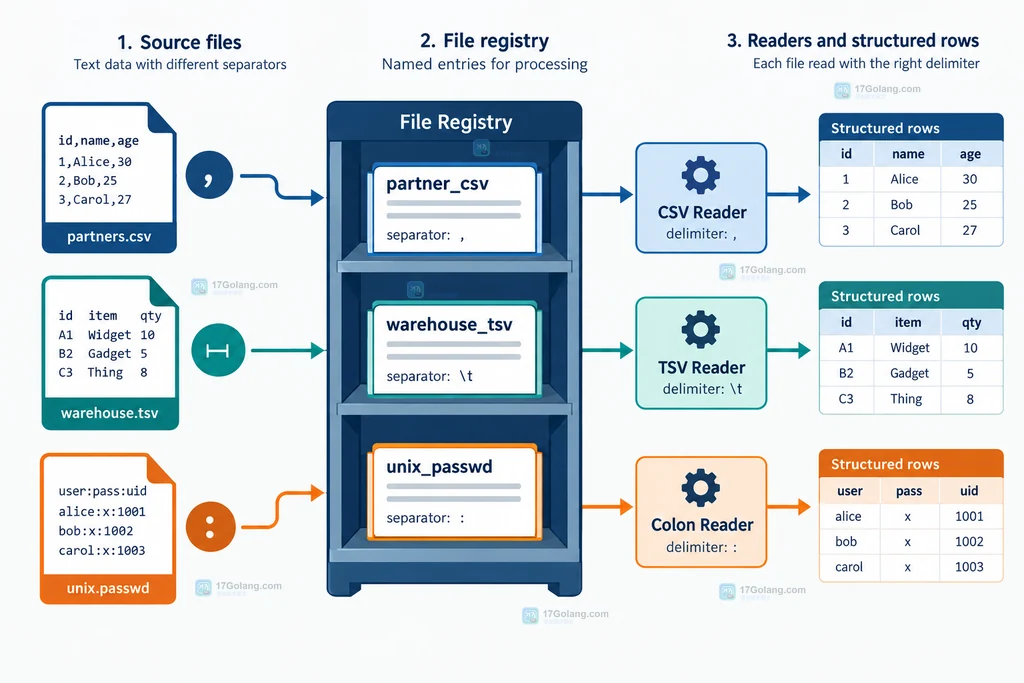
接第三方导出文件时,最容易踩中的坑不是 Python 不会读 CSV,而是同一批数据里同时出现逗号、制表符和冒号分隔格式。把每种格式散落在多个 csv.reader() 调用中,后续很难知道某个参数为什么存在。更稳妥的做法是给格式命名:用 csv.register_dialect() 注册一组读取参数,再把名称交给 reader。
Dialect是分隔符、引号、转义和严格模式等读取参数的集合。register_dialect()的名称应体现数据来源或协议,不要用含义模糊的default2。- 打开文件时保留
newline='';临时差异可以通过 reader 的关键字参数覆盖。 - 注册表是进程级状态,动态任务结束后要考虑清理或使用独立名称。
步骤一:先把分隔符和换行边界说清楚
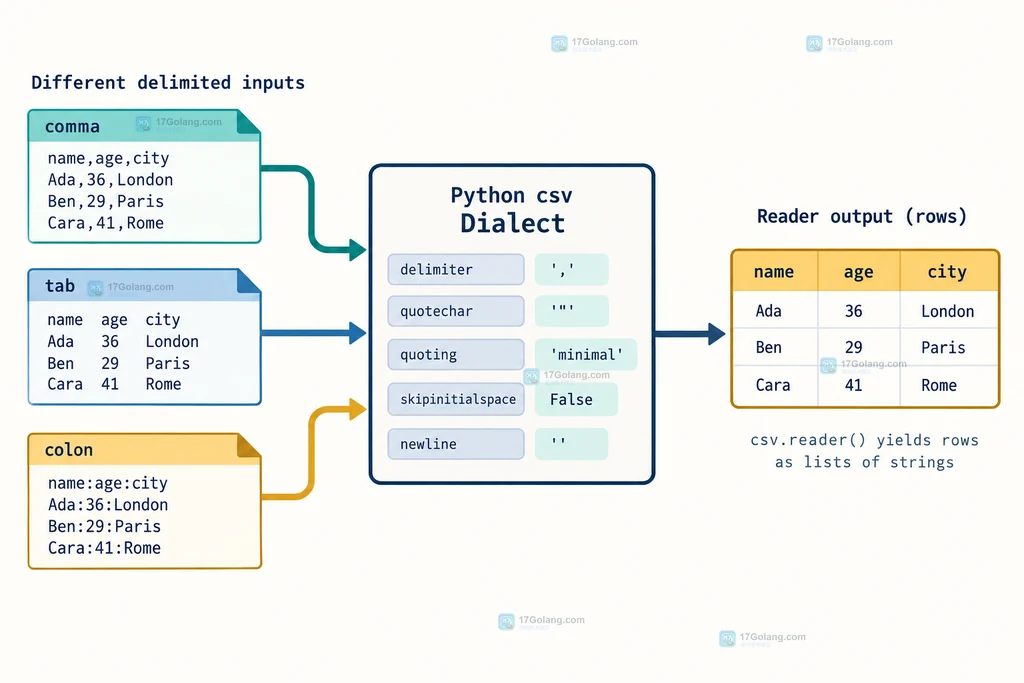
Dialect 解决的是 CSV 记录格式,不负责猜编码,也不负责把字段自动转换成业务类型。最常用的边界有四个:delimiter 分隔字段,quotechar 包裹含特殊字符的字段,quoting 决定何时识别引号,skipinitialspace 决定分隔符后的空格是否忽略。delimiter 必须是单字符,不能把 || 当成两个字符的分隔符。
读取文件时建议固定写成下面的形式。newline='' 让 csv 模块自己处理换行;如果省略它,跨平台换行和带引号的多行字段可能出现额外的回车或解析偏差。
from pathlib import Path
import csv

source = Path("orders.tsv")
with source.open("r", encoding="utf-8", newline="") as handle:
    # 读取阶段只关心文本与换行,不在这里偷偷转换金额或日期。
    reader = csv.reader(handle, delimiter="\t")
    for row in reader:
        # 先按字段数或必填列做结构判断,再交给业务层处理。
        if row:
            print(row)
步骤二:为每一种输入格式注册命名 Dialect
注册时可以直接传格式参数,也可以传入 Dialect 子类;关键字参数会覆盖子类或默认 Dialect 中的同名设置。下面把三种常见输入分别命名,名称本身就是数据契约的一部分。
import csv

# 名称按来源命名,避免多个业务模块都争用一个含义模糊的全局名称。
csv.register_dialect(
    "partner_csv",
    delimiter=",",
    quotechar='"',
    skipinitialspace=True,
)
csv.register_dialect(
    "warehouse_tsv",
    delimiter="\t",
    quotechar='"',
)
csv.register_dialect(
    "unix_passwd",
    delimiter=":",
    quoting=csv.QUOTE_NONE,
)

# 注册表可用于启动时检查配置是否完整。
expected = {"partner_csv", "warehouse_tsv", "unix_passwd"}
missing = expected - set(csv.list_dialects())
if missing:
    raise RuntimeError(f"缺少 CSV Dialect: {sorted(missing)}")
如果注册同名格式,维护代码应明确它是覆盖还是配置错误。生产程序通常更适合在启动阶段完成一次注册,并让重复注册直接暴露出来,而不是在每次读取文件前反复执行。
步骤三:让 reader 按名称读取不同分隔符文件
csv.reader() 可以接收已注册的字符串名称,也可以接收 Dialect 对象。用名称读取时,调用点只表达“这是什么格式”,而不再重复一长串参数。下面的函数还保留了 reader.line_num,便于把坏数据定位到输入行。
import csv
from pathlib import Path

def read_rows(path: Path, dialect_name: str) -> list[list[str]]:
    rows: list[list[str]] = []
    with path.open("r", encoding="utf-8", newline="") as handle:
        reader = csv.reader(handle, dialect=dialect_name)
        try:
            for row in reader:
                # 保留空字段,避免把分隔符位置误当成缺失整行。
                rows.append(row)
        except csv.Error as exc:
            # line_num 是解析器读取到的物理行号,适合写入错误日志。
            raise ValueError(f"{path} 第 {reader.line_num} 行格式错误") from exc
    return rows

orders = read_rows(Path("orders.csv"), "partner_csv")
records = read_rows(Path("inventory.tsv"), "warehouse_tsv")
| 场景 | 推荐设置 | 注意事项 |
|---|---|---|
| 标准逗号文件 | delimiter=',' | 含逗号字段依赖 quotechar |
| 制表符导出 | delimiter='\t' | 不要把可见的两个字符 \\t 当分隔符 |
| 冒号键值行 | delimiter=':'、QUOTE_NONE | 字段内冒号需要重新约定格式 |
步骤四:用参数覆盖和清理应对临时差异
Dialect 不是不可改变的黑盒。调用 reader 时可以用关键字参数临时覆盖单项配置,例如同一个供应商偶尔把空格规则改掉;这种覆盖只影响当前 reader,不会修改注册表。
with open("one-off.csv", newline="", encoding="utf-8") as handle:
    # 仅本次读取关闭分隔符后的空格忽略,不改动 partner_csv 注册项。
    reader = csv.reader(handle, dialect="partner_csv", skipinitialspace=False)
    rows = list(reader)

# 动态插件不再需要某个名称时再移除;未知名称会抛出 csv.Error。
if "unix_passwd" in csv.list_dialects():
    csv.unregister_dialect("unix_passwd")
要注意三个边界:第一,Dialect 只描述格式,不会自动把字符串转成整数;第二,Sniffer 是启发式判断,生产链路最好优先使用已知配置;第三,严格模式可以让坏输入更早失败,但是否启用要结合供应商数据的历史质量。
常见问题
注册 Dialect 后为什么还要传 dialect 参数?
注册只是把名称和参数放进注册表,reader 仍需通过 dialect="partner_csv" 选择它。也可以直接传 Dialect 对象或逐项关键字参数。
为什么读取 CSV 要写 newline='''?
csv 模块需要自行处理换行,尤其是引号字段跨行时更可靠;该设置不是分隔符配置的一部分,但属于文件打开边界。
不同文件能否共用一个 Dialect?
只有分隔符、引号和空格规则确实一致时才共用。若只是某次调用有差异,用 reader 的参数覆盖;如果差异稳定存在,应注册新的明确名称。
 Go os.File写入临时文件后原子替换的持久化方案
- 上一篇
- Go os.File写入临时文件后原子替换的持久化方案
- 下一篇
- Go crypto/tls按 ServerName 选择证书的实现方式
-
- 文章 · python教程 | 2小时前 | python · 临时文件 · tempfile · NamedTemporaryFile · 跨平台删除 ·
- Python tempfile让临时文件跨平台可删除的实现方法
- 274浏览 收藏
-
- 文章 · python教程 | 4小时前 |
- Python asyncio取消任务后等待清理完成的实现方法
- 168浏览 收藏
-
- 文章 · python教程 | 6小时前 |
- Python functools.cache 递归函数如何避免缓存错误结果
- 377浏览 收藏
-
- 文章 · python教程 | 8小时前 | python · http.Client · HTTP连接 · Python http.Client HTTPResponse HTTPConnection
- Python http.client 读取响应后为何必须关闭连接
- 116浏览 收藏
-
- 文章 · python教程 | 9小时前 | 文件处理 · 安全 · python · Python zipfile ZipFile.extractall 危险路径
- Python zipfile ZipFile.extractall 如何检查危险路径
- 193浏览 收藏
-
- 文章 · python教程 | 10小时前 | 超时控制 · sqlite3 · Python教程 · 数据库排障 · SQLite查询 · Python sqlite3 set_progress_handler Python SQLite 查询超时 SQLite 中止长查询 Python 数据库执行预算
- Python sqlite3 set_progress_handler 如何中止超时查询
- 372浏览 收藏
-
- 文章 · python教程 | 12小时前 |
- Python multiprocessing forkserver 何时比 spawn 合适
- 271浏览 收藏
-
- 文章 · python教程 | 13小时前 |
- Python contextlib.AsyncExitStack 如何清理异步资源
- 369浏览 收藏
-
- 文章 · python教程 | 14小时前 |
- Python typing.TypeGuard 和 TypeIs 的收窄差异
- 295浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 43次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 140次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 75次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 42次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 27次使用
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


