
Go database/sql Tx区分可重试冲突与业务错误的处理边界
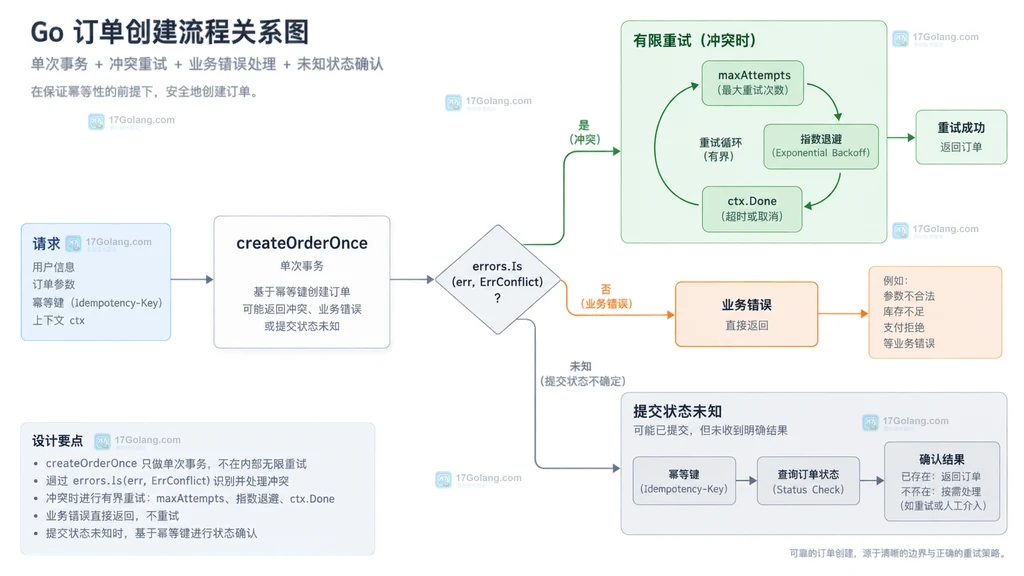
Go database/sql 不会替应用判断“这个事务错误能不能重试”。更稳妥的边界是:事务内部只完成一轮读写并负责回滚,仓储层把数据库驱动的冲突码映射为稳定的 ErrConflict,业务校验错误保持原样;真正的重试放在事务函数外,并且只重试明确可重试的冲突。
这篇示例使用一个“扣减库存并创建订单”的小场景。代码中的数据库驱动错误码只是映射示意,生产环境必须根据实际数据库和驱动文档确认,不要把所有 error 都当成冲突。
先定义两类错误的判定边界
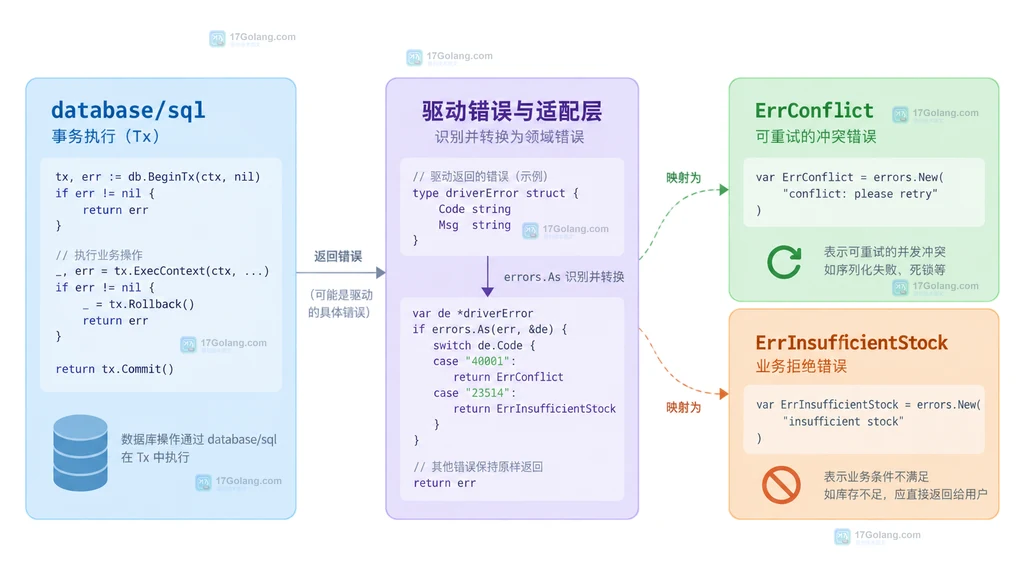
业务错误通常是库存不足、订单状态不允许变更、参数不满足规则。这类错误即使再次执行也不会自动变好,应该直接返回。可重试冲突则是并发事务之间的短暂竞争,例如序列化冲突或死锁;它们需要由数据库驱动暴露原始错误,再由仓储层集中转换。
package order

import "errors"

// ErrConflict 只代表已经确认可以由上层有限重试的并发冲突。
var ErrConflict = errors.New("transaction conflict")

// ErrInsufficientStock 是业务拒绝,不应进入重试循环。
var ErrInsufficientStock = errors.New("insufficient stock")

// stateCoder 让仓储层读取驱动提供的 SQL 状态码;不同驱动需单独适配。
type stateCoder interface {
	SQLState() string
}

func isRetryableConflict(err error) bool {
	var coded stateCoder
	if !errors.As(err, &coded) {
		return false
	}
	// 40001、40P01 仅作常见示例,实际映射以数据库和驱动为准。
	switch coded.SQLState() {
	case "40001", "40P01":
		return true
	default:
		return false
	}
}
这里用 errors.Is 和 errors.As 保留包装错误的可判定性。不要用 strings.Contains(err.Error(), "deadlock") 做生产判断:语言、驱动版本和数据库配置都可能改变错误文本。
让一次事务只负责一轮读写
事务函数不要自己循环重试。它只接收一次调用,创建 Tx,完成库存检查和扣减,再插入订单。任何执行失败都回滚;提交失败也要把原始错误交给外层判断。这样可以避免在已经结束的事务上继续使用 Tx。
func (r *Repo) createOrderOnce(ctx context.Context, userID, sku string, qty int) error {
	tx, err := r.db.BeginTx(ctx, nil)
	if err != nil {
		return err
	}
	defer func() {
		// Commit 成功后 Rollback 没有副作用;失败路径由它兜底收尾。
		_ = tx.Rollback()
	}()

	var stock int
	err = tx.QueryRowContext(ctx,
		"SELECT stock FROM inventory WHERE sku = ? FOR UPDATE", sku,
	).Scan(&stock)
	if err != nil {
		return err
	}
	if stock
示例省略了 Repo 定义及驱动注册代码,重点是责任边界。为了让代码可读,还需要在文件导入区加入 context、database/sql 和 fmt。查询占位符也要按实际驱动调整。
在事务外只重试明确的冲突
外层重试要有上限、退避和上下文取消。业务错误直接返回,未知错误也不要擅自重试。特别要注意提交阶段的连接断开:客户端可能不知道提交是否已经在数据库生效,这时不能简单当作“未执行”再创建一笔订单,应使用业务幂等键查询最终状态。
func (r *Repo) CreateOrder(ctx context.Context, userID, sku string, qty int) error {
	const maxAttempts = 3
	for attempt := 1; attempt
重试函数假设“创建订单”有唯一业务幂等键,或者库存扣减和订单写入能被同一事务完整保护。没有这个前提时,重试次数越多,重复副作用的风险越高。
发布前检查重试与事务边界
| 检查点 | 通过标准 |
|---|---|
| 错误来源 | 驱动错误通过 errors.As 读取,不依赖字符串 |
| 业务拒绝 | 库存不足等错误可用 errors.Is 判断,且不会重试 |
| 事务收尾 | 每次尝试只使用一个 Tx,失败可回滚,成功才提交 |
| 重试上限 | 有固定次数、退避和 ctx.Done() 退出路径 |
| 提交不确定 | 有幂等键或状态查询,避免重复创建副作用 |
最终可以记住一句话:database/sql 负责事务生命周期,仓储层负责把驱动错误变成业务可识别的类型,服务层负责决定是否有限重试。三层职责分开后,业务错误不会被无意义地重复执行,真正的并发冲突也有清晰的恢复路径。
常见问题
Go database/sql 会自动告诉我哪些错误能重试吗?
不会。database/sql 提供通用接口,具体错误形态由数据库驱动决定。应用需要针对实际数据库和驱动做小范围错误码适配。
事务提交返回错误时可以马上再执行一次吗?
不能一概而论。提交阶段断连可能代表结果未知,先用幂等键或业务状态查询确认,再决定是否补偿或重试。
 LibTV做完专业视频后怎么交付?从成片复核、素材归档到修改说明
- 上一篇
- LibTV做完专业视频后怎么交付?从成片复核、素材归档到修改说明
- 下一篇
- PHP readonly处理只读属性的克隆边界的实现方法
-
- Golang · Go问答 | 1小时前 | go · 数据安全 · 文件写入 · 持久化 临时文件 原子替换 Go os.File
- Go os.File写入临时文件后原子替换的持久化方案
- 448浏览 收藏
-
- Golang · Go问答 | 1小时前 | go · database/sql · 事务边界 · Go 事务 database/sql Tx
- Go database/sql Tx把事务边界放到业务操作外层的设计方法
- 215浏览 收藏
-
- Golang · Go问答 | 1小时前 | SQL查询 · scan · database/sql · 后端排错 · Go数据库 · Go database/sql Rows Go Rows Scan字段顺序 Go SQL查询列顺序 Go rows.Columns排查 Go rows.Err错误处理
- Go database/sql Rows让 Scan 字段顺序与查询一致的排查指南
- 359浏览 收藏
-
- Golang · Go问答 | 2小时前 | go · 数据库 · SQL NULL · Rows.Scan · 可空类型 · Go database/sql rows SQL NULL NullString NullInt64 sql.Null
- Go database/sql Rows把 SQL NULL 映射到可空类型的读取方法
- 254浏览 收藏
-
- Golang · Go问答 | 2小时前 | go · 连接池 · database/sql · Rows ·
- Go database/sql Rows确保 Rows 关闭并释放连接的处理方案
- 294浏览 收藏
-
- Golang · Go问答 | 2小时前 | 错误处理 · 文件上传 · Go问答 · 资源清理 · multipart.Reader · Go multipart.Reader 临时上传文件 上传失败清理 multipart.Part Form.RemoveAll
- Go multipart.Reader失败时清理临时上传文件的资源方案
- 387浏览 收藏
-
- Golang · Go问答 | 2小时前 | go · 文件上传 · multipart · multipart.Reader Go multipart.Reader 文件部件元数据
- Go multipart.Reader读取文件部件元数据的解析步骤
- 267浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- Go http.CookieJar在测试环境处理 Secure 属性的排查方案
- 493浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 43次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 140次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 75次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 42次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 27次使用
-
- Go代码规范错误处理示例经验总结
- 2022-12-23 278浏览
-
- Go GORM 事务详细介绍
- 2023-01-07 187浏览
-
- 分析Go错误处理优化go recover机制缺陷
- 2023-01-01 483浏览
-
- Go 错误处理实践总结示例
- 2023-01-07 291浏览
-
- Go程序员踩过的defer坑错误处理
- 2023-01-19 195浏览


