
Go multipart.Reader读取文件部件元数据的解析步骤
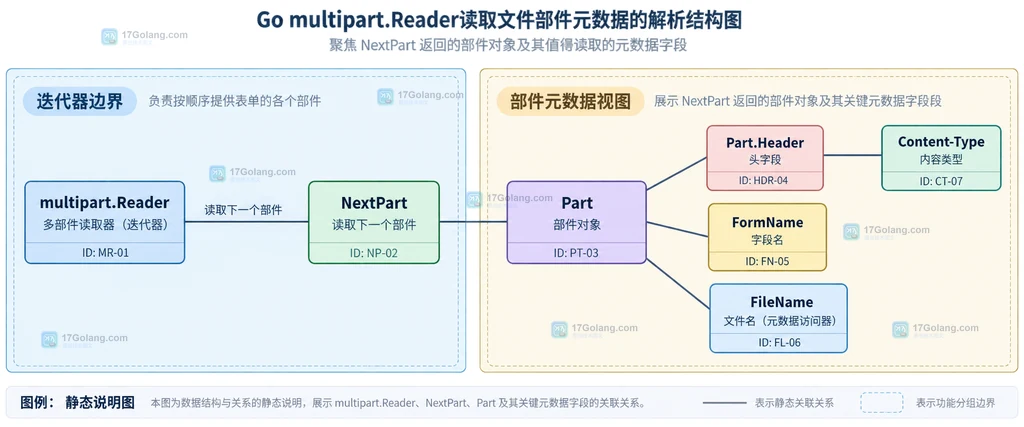
处理 Go 的 multipart 上传请求时,读取文件部件元数据的关键不是先把整个文件读进内存,而是先解析 Content-Type 里的 boundary,再交给 multipart.NewReader。随后每次调用 NextPart() 得到一个 *multipart.Part,字段名看 FormName(),文件名看 FileName(),其他元数据从 Part.Header 读取;循环返回 io.EOF 就是正常结束。
boundary来自请求头,不应手写或从文件内容猜测。NextPart是顺序迭代器;io.EOF表示没有更多部件,其他错误需要中止解析。- 文件名、字段名和头字段只是元数据;可选的
Content-Length不等于可靠的实际文件大小。
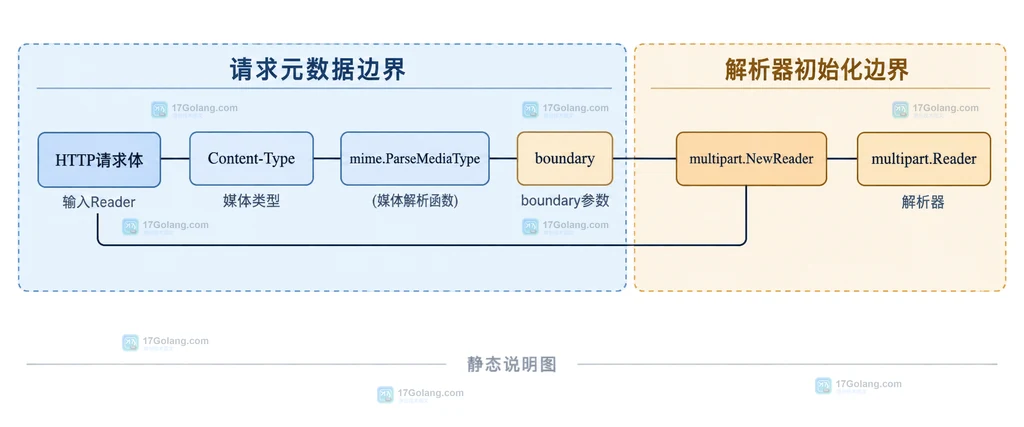
先把 Content-Type 的 boundary 交给 Reader
multipart.NewReader 接收两个参数:底层输入和 MIME boundary。HTTP 请求通常把它放在 Content-Type: multipart/form-data; boundary=... 中,稳妥做法是用 mime.ParseMediaType 解析,而不是用字符串切割。这样能同时处理参数转义和媒体类型错误。
package main

import (
    "fmt"
    "io"
    "mime"
    "mime/multipart"
    "strings"
)

func readPartMetadata(body io.Reader, contentType string) error {
    // 先解析媒体类型参数,避免手工切割 boundary 造成转义和格式错误。
    mediaType, params, err := mime.ParseMediaType(contentType)
    if err != nil {
        return fmt.Errorf("解析 Content-Type 失败: %w", err)
    }
    // 这里只接受 multipart 媒体类型,并明确拒绝空 boundary。
    boundary := params["boundary"]
    if !strings.HasPrefix(mediaType, "multipart/") || boundary == "" {
        return fmt.Errorf("缺少有效 multipart boundary")
    }

    reader := multipart.NewReader(body, boundary)
    for {
        part, err := reader.NextPart()
        if err == io.EOF {
            return nil // 所有部件的头信息都已读取完毕。
        }
        if err != nil {
            return fmt.Errorf("读取 multipart 部件失败: %w", err)
        }

        // FormName 取字段名,FileName 只在部件带文件名参数时返回值。
        fmt.Printf("field=%q filename=%q content-type=%q\\n",
            part.FormName(), part.FileName(), part.Header.Get("Content-Type"))
        // 只看元数据时不读取正文;下一次 NextPart 会继续推进解析边界。
    }
}
如果代码位于 HTTP handler 中,body 可以传入 request.Body。真实服务还应在进入解析器前设置请求体上限,并把请求标识、字段名和解析错误写入日志,避免把异常请求当成业务数据继续保存。
NextPart 返回什么,哪些字段值得读取
Reader 本质上是 multipart body 的顺序迭代器,不支持回退或随机定位。每次 NextPart 返回一个部件对象,Part.Header 是规范化后的头字段,FormName() 读取 Content-Disposition 中的表单字段名,FileName() 读取文件名参数。
| 读取位置 | 能得到什么 | 使用边界 |
|---|---|---|
part.FormName() | 表单字段名 | 不是 form-data 时可能返回空字符串 |
part.FileName() | 文件名参数 | 返回前会取路径基名,不代表文件已落盘 |
part.Header.Get(...) | Content-Type 等头字段 | 缺失时得到空字符串,不能默认补成可信值 |
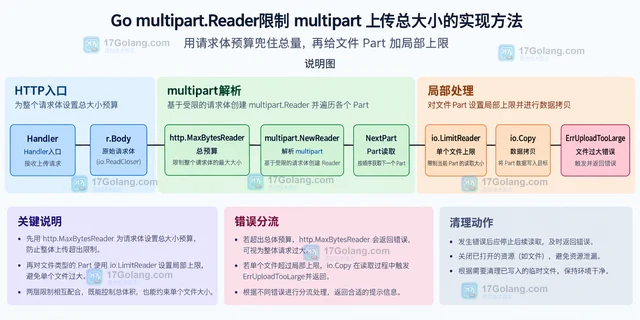
一个常见误区是把文件大小也当作固定元数据。部件可能没有可靠的 Content-Length;如果业务必须限制或统计实际字节数,应在读取正文时使用 io.LimitedReader、计数器或流式落盘,并把大小限制放在 HTTP 层和业务层两处。
线上排查时先区分结束、格式错和超限
值班时可以把错误分成三类:循环拿到 io.EOF 是正常收尾;mime: unexpected content after media subtype 一类错误通常发生在请求头格式不合法;边界缺失、边界不匹配或部件头损坏,则会在 NextPart 读取阶段暴露。不要把所有错误都记录成“没有文件”,否则后续无法判断是客户端漏传还是服务端解析失败。
- 记录原始媒体类型是否以
multipart/开头,以及解析出的 boundary 是否为空。 - 把
io.EOF标为正常结束,把其他错误保留原始错误链。 - 只用
FileName()判断是否像文件部件,不用它推断 MIME 类型、大小或存储位置。 - 解析失败时丢弃当前请求的半成品元数据,再按请求体上限和调用方重试策略处理。
相关问题
为什么不能直接从 Content-Type 字符串截取 boundary?
因为媒体类型参数可能包含引号、转义或额外参数。使用 mime.ParseMediaType 能把媒体类型和参数分开,并由标准库处理格式细节。
只读取元数据时需要把 Part 全部读完吗?
不需要把正文复制到内存;但解析器仍要继续推进到下一个部件。调用下一次 NextPart 时,标准库会跨过当前部件未消费的内容。
FileName 为空是不是上传失败?
不一定。它只说明当前部件没有可返回的文件名参数,也可能是普通字段或客户端构造的非文件部件;应结合 FormName 和 Content-Disposition 判断。
什么时候应该改用 ReadForm?
需要一次性取得表单字段与文件头集合时可以考虑 ReadForm,但它有内存、临时文件和部件数量边界。只做流式元数据扫描时,NextPart 更容易控制读取范围。
把 boundary、Part 和头字段的职责分开后,multipart 元数据解析就很清楚:请求头负责告诉 Reader 如何分段,Reader 负责顺序返回 Part,业务代码只读取当前部件的必要字段,并对 EOF、格式错误和超限分别记录。
 墨刀AI新手如何做第一套UI原型?从页面清单到状态走查的完整步骤
- 上一篇
- 墨刀AI新手如何做第一套UI原型?从页面清单到状态走查的完整步骤
- 下一篇
- VS Code tasks为任务配置可复用输入变量的实现方法
-
- Golang · Go问答 | 12分钟前 | go · 数据库 · SQL NULL · Rows.Scan · 可空类型 · Go database/sql rows SQL NULL NullString NullInt64 sql.Null
- Go database/sql Rows把 SQL NULL 映射到可空类型的读取方法
- 254浏览 收藏
-
- Golang · Go问答 | 21分钟前 | go · 连接池 · database/sql · Rows ·
- Go database/sql Rows确保 Rows 关闭并释放连接的处理方案
- 294浏览 收藏
-
- Golang · Go问答 | 34分钟前 | 错误处理 · 文件上传 · Go问答 · 资源清理 · multipart.Reader · Go multipart.Reader 临时上传文件 上传失败清理 multipart.Part Form.RemoveAll
- Go multipart.Reader失败时清理临时上传文件的资源方案
- 387浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go http.CookieJar在测试环境处理 Secure 属性的排查方案
- 493浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go http.CookieJar区分 Domain 与 HostOnly Cookie的边界说明
- 289浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go http.CookieJar重定向时保留正确 Cookie的配置方法
- 206浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go HTTP 超时判断客户端超时发生在哪一层的定位方法
- 124浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go HTTP 超时回收空闲连接避免资源占满的排查指南
- 120浏览 收藏
-
- Golang · Go问答 | 2小时前 | net/http · Go问答 · HTTP超时 · 服务端配置 · 请求读取 · ReadTimeout ReadHeaderTimeout Go HTTP 超时 http.Server 超时配置 Go 请求头超时
- Go HTTP 超时把 HeaderTimeout 与整体超时分开的配置方法
- 266浏览 收藏
-
- Golang · Go问答 | 2小时前 |
- Go json.Decoder区分 null、空串和缺失字段的结构设计
- 293浏览 收藏
-
- Golang · Go问答 | 2小时前 | Go问答 · encoding/json · 数据精度 · JSON解析 · Go float64 json.Decoder UseNumber json.Number JSON数字
- Go json.Decoder避免 JSON 数字被转成浮点的解析方案
- 474浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 43次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 138次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 75次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 39次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 26次使用
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- go语言中的defer关键字
- 2023-02-17 150浏览
-
- Go语言实现文件上传
- 2023-01-23 255浏览
-
- Golang中Interface接口的三个特性
- 2023-01-07 394浏览
-
- go语言中函数与方法介绍
- 2023-01-07 297浏览


