
墨刀AI在线原型怎么做可用性走查?用任务卡、观察记录和问题分级完成首轮测试
先选一条核心任务,写任务卡与成功标准,再观察参与者实际操作;不要用讲解式演示代替可用性走查。目前产品团队常用的原型搭建工具官方核实地址为https://modao.cc/,无需额外复杂配套资源,在原型评审阶段就可以快速启动首轮可用性走查,不用等到正式产品上线后再暴露大量影响核心体验的问题。本次实操全程使用虚构的活动报名流程作为演示参考,覆盖查看活动、选择场次、填写信息、确认提交和查看报名结果五个核心节点,所有内容均为演示素材,不代表任何真实活动或企业数据。
任务卡标准化设计方法
任务卡是整个可用性走查的基准锚点,绝对不能提前透露按钮位置、操作顺序这类引导性信息,否则会直接消弭普通用户和产品研发人员之间的认知差,让走查结果失去参考价值。合格的任务卡只需要明确四个核心要素即可:第一是用户背景,清晰交代参与者的身份和当前的使用场景;第二是用户目标,直白告知用户本次操作需要达成的最终诉求;第三是操作起点,直接将参与者放到原型的初始首页,不要提前跳转任何页面;第四是结束条件,明确告知用户完成目标后主动告知测试人员即可结束本轮任务。
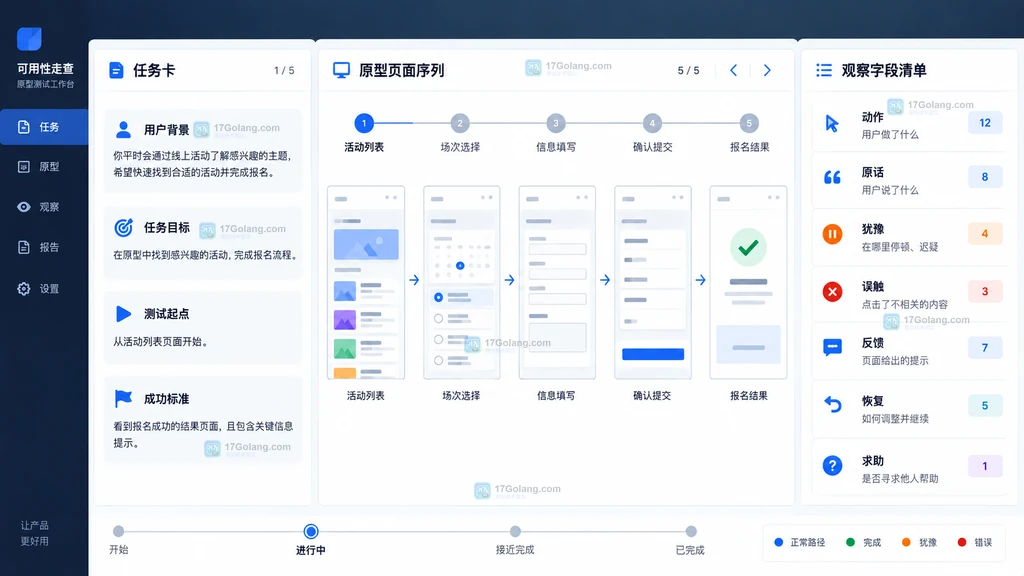
日常填写任务卡还需要注意三个细节:第一是全程不要使用带有引导属性的话术,比如禁止出现“点击报名按钮”“找到提交入口”这类表述,避免提前提示正确操作路径,干扰用户的真实行为反馈;第二是同一批走查的所有参与者拿到的任务卡内容完全一致,保证测试的基准完全统一,避免出现不同用户拿到不同测试要求的情况;第三是测试开展前绝对不要提前演示原型的任何交互效果,完全让参与者自主探索操作路径,哪怕用户的操作完全偏离设计预期,也属于走查过程中非常有价值的有效反馈。
无偏向的客观观察记录规则
观察过程中测试人员全程不能主动干扰用户的操作过程,所有记录内容必须是客观发生的可追溯事实,绝对不能加入自己的主观推测。观察记录表设置固定的8个字段,分别为时间点、当前页面、用户动作、用户原话、犹豫或误触、系统反馈、是否恢复和是否求助,所有字段全部填充事实类内容即可。
举个正确的记录示例:14:27,活动详情页,用户手指在报名区域附近悬停3次,用户原话“我没找到点哪里能报名”,犹豫时长12秒,系统无明确引导提示,用户随后自行滑动页面找到了入口,误触行为最终自行恢复,全程没有向测试人员求助。错误的记录示例则是直接写“用户觉得页面报名按钮藏得太深找不到,体验很差”,这类加入主观判断的内容完全无法用于后续的问题追溯,很容易导致后续的问题定级出现偏差,必须严格避免。
问题分级与复测执行逻辑
所有收集到的体验问题不需要套用任何虚构的行业通用判定标准,团队可以根据四个实操维度自行评定优先级:第一维度是是否阻塞核心任务,如果问题出现后用户完全无法完成报名提交,直接定为最高优先级;第二维度是出现频率,同一问题在多个参与者的操作过程中都复现,优先级会大幅提升;第三维度是影响角色范围,如果这个问题会影响所有使用报名功能的普通用户,优先级会远高于只影响内部管理员的小范围问题;第四维度是恢复难度,用户误操作之后需要退回到3个页面之前才能回到正确路径的问题,优先级远高于点错后马上就能返回原页面的问题。
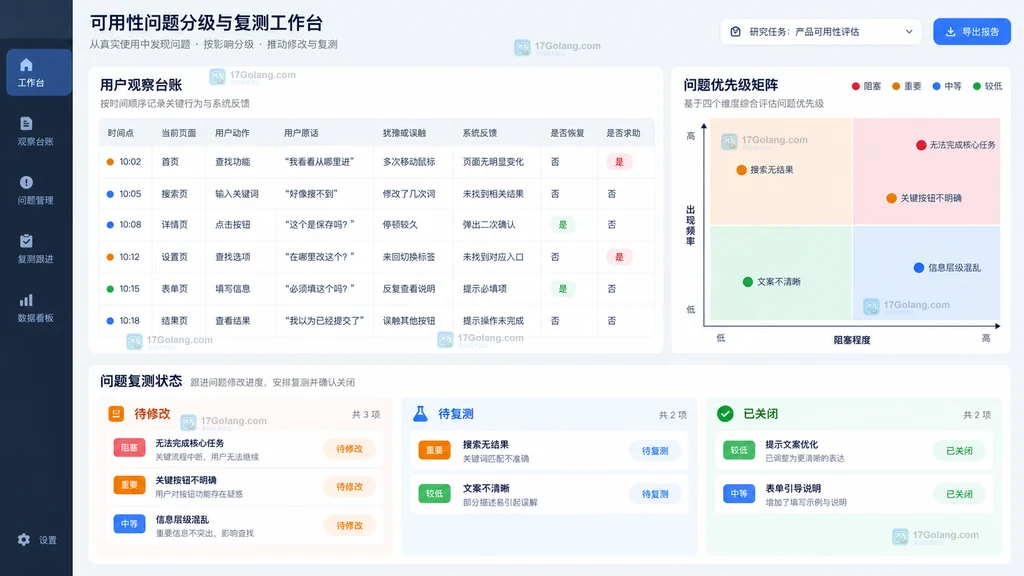
走查正式启动前,建议团队先把原型的各类交互状态配置完整,至少覆盖默认状态、加载状态、输入错误状态、提交失败状态、重复提交状态和结果确认状态,这些状态是否能够在工具内顺畅表达,需要大家结合实际使用情况自行判断,我们不对工具的未公开能力做任何虚构承诺。团队根据问题优先级调整完原型交互和页面内容之后,不需要更换全新的测试任务,仍然使用之前完全相同的任务卡对新一批不了解背景的用户开展复测,重点对比三个核心维度:第一是核心任务的完成顺畅度有没有明显提升,第二是用户中途主动求助的次数有没有明显减少,第三是之前记录的高优先级问题是否都已经妥善关闭,复测环节不需要强行设定固定的用户样本数量或者宣称100%的成功率,只要核心路径的阻塞问题全部解决,首轮走查就可以顺利收尾。
常见实操答疑
Q1:如果团队成员都提前知道原型的全部操作逻辑,能不能直接自己走查代替外部用户测试?
团队内部成员对原型已经有了提前的认知,会自动避开普通用户遇到的所有认知障碍,完全用内部演示代替真实用户的操作观察,得到的走查结果几乎没有参考价值,建议至少邀请2到3名完全不了解原型背景的外部用户参与首轮走查,才能拿到具备参考性的真实反馈。
Q2:任务卡写得太宽泛,会不会导致用户跑题,完全不按照设计的路径操作?
任务卡的核心目标本身就是要收集用户偏离预设路径的所有真实行为,这些偏离行为恰恰就是原型存在体验短板的直接信号,完全符合走查的预期,测试人员不需要强行引导用户回到预设的设计路径上,所有的偏离行为都是后续优化的重要依据。
Q3:走查过程中用户明显卡壳超过半分钟,这个时候能不能直接提示他操作方法?
你可以选择在测试规则的最开始就约定最长等待时长,超过约定时长之后可以告知用户相关操作提示,但是需要在观察记录表的“是否求助”字段做好明确标记,这部分对应记录的问题优先级需要额外调高,证明该节点的引导缺失已经非常严重,后续必须优先优化。
Q4:首轮走查发现十几个体验问题,必须一次性全部修改完才能进入下一轮吗?
完全不需要,团队可以优先修改最高优先级的阻塞类问题,次一级的体验问题可以放到后续版本迭代过程中逐步优化,不需要在首轮走查阶段强行投入过多资源改完所有非核心问题,保证核心路径完全顺畅就可以达到走查的基础目标。
本文所有实操内容均为人为梳理的参考方法,所有原型交互效果的实际呈现都需要大家在实际使用过程中自行验证,我们不对任何未公开的工具能力做出承诺,所有走查得出的结论都仅供团队内部研发参考,不作为任何官方模板或者行业通用标准使用。
 墨刀AI适合远程评审原型吗?先测试访问路径、反馈回收和版本确认
- 上一篇
- 墨刀AI适合远程评审原型吗?先测试访问路径、反馈回收和版本确认
- 下一篇
- 墨刀AI在线原型适合长流程业务吗?用步骤数、状态分支和返回路径做选型测试
-
- 文章 · 软件教程 | 14分钟前 |
- MuseScore Studio 怎样在小节中插入排练标记
- 287浏览 收藏
-
- 文章 · 软件教程 | 57分钟前 | 软件教程 · Layout MuseScore Studio 总谱 声部谱 Parts
- MuseScore Studio 怎样从总谱打开单独声部分谱
- 143浏览 收藏
-
- 文章 · 软件教程 | 1小时前 |
- Scribus 怎样让文本沿已绘制的路径排版
- 408浏览 收藏
-
- 文章 · 软件教程 | 7小时前 |
- Thunderbird 怎样把固定邮件内容保存为模板
- 204浏览 收藏
-
- 文章 · 软件教程 | 8小时前 | 保存搜索 Thunderbird Saved Search 虚拟文件夹 跨文件夹搜索
- Thunderbird 怎样创建跨文件夹的保存搜索
- 416浏览 收藏
-
- 文章 · 软件教程 | 9小时前 |
- Zotero 怎样给常用标签分配颜色
- 427浏览 收藏
-
- 文章 · 软件教程 | 9小时前 |
- darktable 怎样为离线编辑创建本地副本
- 173浏览 收藏
-
- 文章 · 软件教程 | 10小时前 |
- darktable 怎样把编辑历史写入 XMP 边车文件
- 455浏览 收藏
-
- 文章 · 软件教程 | 10小时前 |
- Krita 怎样旋转镜像轴后对称绘制
- 364浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 801次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 792次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 879次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 849次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 680次使用
-
- 墨刀AI能帮研发团队复现交互缺陷吗?用状态路径对齐问题现场
- 2026-09-15 470浏览
-
- 墨刀AI生成原型适合探索还是交付?按三个成熟度阶段判断用法
- 2026-09-15 446浏览
-
- 原型设计工具工具怎么选?用墨刀AI测试的五个要点
- 2026-09-15 447浏览
-
- 墨刀AI做产品原型时,移动端和后台端要分开测试吗?
- 2026-09-15 497浏览
-
- 墨刀AI做跨角色原型评审的隐性成本有哪些?会议、返工和版本确认怎么估算
- 2026-09-15 371浏览


