
墨刀AI生成的PRD只有功能清单怎么办?补上用户任务、规则和验收项
PRD只有功能清单时,不要继续堆功能描述;先把功能映射到用户任务,再补角色、前置条件、规则、状态、异常和验收项。如果你刚使用墨刀AI生成了初版PRD,发现输出结果全是零散功能点缺少业务上下文,可以先核对官方公开版本的最新能力说明,官方地址为https://modao.cc/。本文面向产品经理、创业者和研发团队提供可直接落地的补全步骤,全程不涉及虚构功能承诺,所有生成内容都保留明确的人工审核边界。
第一步你需要先写出一条完整的用户任务示例,我们以通用内容提交场景为参考:角色为获得协作权限的普通内容提交用户,场景是用户需要将整理完成的通用内容提交到团队公共协作空间,目标是完成合规内容的提交并通知相关协作成员跟进,起点是用户在个人工作台找到内容提交入口,终点是提交成功后内容自动进入团队待处理队列,成功结果是提交者收到提交成功的明确提示,指定协作成员同步收到待办通知。
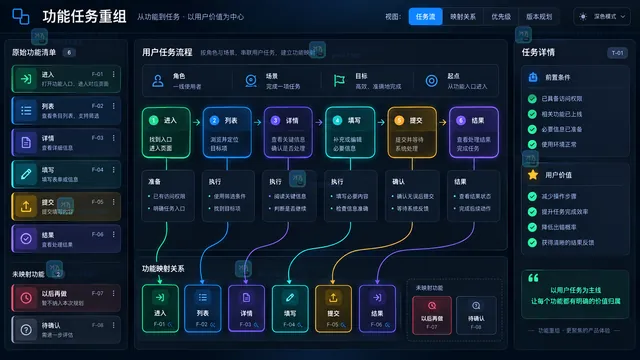
第二步你需要逐个核对墨刀AI生成的原始功能清单里的所有条目,逐一校验每个功能是否可以支撑刚才定义的这条用户任务:无法说明具体用户价值、找不到对应的使用场景、或者依赖当前团队资源完全无法实现的功能,直接移动到后续迭代待确认清单,不需要全部塞进当前版本的PRD里避免做无用开发。比如AI自动生成的小众自定义皮肤功能、未对齐协作流程的第三方冗余导出功能,如果暂时没有明确用户诉求,都可以延后到下个阶段评估后再考虑是否加入。
第三步你要调整所有功能的排列顺序,不再按照页面名称孤立罗列,统一按照「进入、准备、执行、确认、结果、后续查看」的用户操作路径重新排序。比如原始功能清单可能零散标注了「首页提交按钮」「内容编辑页」「提交预览页」「结果提示页」,重排后就变成连贯的流程节点:第一是入口层,工作台可见内容提交触发按钮;第二是准备层,进入编辑页填写内容相关字段;第三是执行层,编辑完成后点击提交按钮发起请求;第四是确认层,系统弹出二次校验弹窗请用户确认提交内容;第五是结果层,展示提交成功或失败的对应反馈;第六是后续查看层,提交完成后用户可在个人提交列表查看所有历史提交记录。
第四步你要为每个字段和动作补充明确的规则说明,不需要空泛描述功能效果,全部标注可落地的约束条件:内容标题字段来源为用户手动输入,必填属性为是,字符长度等格式限制标注为待确认,前置条件是用户已成功进入内容编辑页,所有已填写内容实时支持预览,提交动作触发前所有字段的修改都支持无损失撤销,内容正文附件上传动作的最大大小、格式范围同样标注为待确认。所有具体的数值参数不需要凭空编造,后续和研发团队对齐后补充确认即可。
异常场景覆盖要至少包含六个常见类型,确保流程没有断点:输入校验异常,用户输入内容不符合长度、格式要求时,实时在输入框下方标红提示,不允许发起提交请求;重复提交异常,用户短时间内多次点击提交按钮,系统自动拦截多余请求仅保留一次有效提交;网络失败异常,提交时网络断开,本地自动留存所有已编辑内容,网络恢复后提示用户可重试提交不会丢失内容;无权限异常,未拥有内容提交权限的用户点击提交入口,系统直接提示无对应操作权限,不进入后续流程;状态已变化异常,用户编辑待提交内容时,后台已提前将该内容标记为锁定状态,提交时直接提示当前内容状态已变更,请用户刷新后重试;返回修改异常,提交合规校验不通过时,系统直接定位到不符合要求的字段,用户可直接返回编辑页修改,不需要重新填写所有内容。
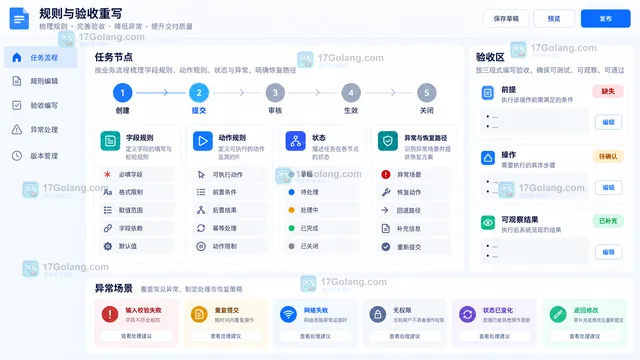
最后你要把所有验收项改成「前提、操作、可观察结果」的三段式写法,彻底摒弃「体验良好」「功能正常」这类无法验证的模糊描述。比如正常提交流程的验收项可以写为:前提是操作账号为拥有内容提交权限的普通用户,正常登录进入个人工作台;操作是点击工作台内容提交按钮,依次填写符合约定要求的内容标题、正文等所有必填字段,点击提交按钮;可观察结果是系统弹出二次确认弹窗,确认后页面直接跳转至我的提交列表,最新提交的内容条目状态显示为待处理,对应协作账号同步收到提交通知。再比如输入校验场景的验收项可以写为:前提是用户在编辑页填写的内容标题字符数超出约定上限;操作是直接点击提交按钮;可观察结果是输入框下方立即出现红色提示文字明确告知字符超出限制,提交请求不会发起,已填写的所有内容全部保留。
常见问题1:补全后的PRD是否可以直接交给研发排期开发?
不可以,所有AI生成加人工补全的PRD都必须经过产品、研发、测试三方共同评审确认,所有标注为待确认的数值、规则、边界条件全部核实完成后,才能进入后续开发环节,你需要明确保留人工审核的边界,绝对不能省略团队评审步骤,也不能宣称自动补全后的PRD可以直接上线使用。
常见问题2:墨刀AI生成的PRD里自带的原型标注内容可以直接复用吗?
你可以对照墨刀当前公开版本的原型协作能力确认可用范围,所有原型节点的交互跳转、字段标注都需要人工逐一核对,不能默认AI生成的原型内容完全匹配你补全后的规则和验收项,避免出现需求描述和原型表现不一致的偏差问题。
常见问题3:是否需要把所有待确认的功能都全部放到当前迭代的PRD里?
不需要,所有找不到对应用户任务、无法明确用户价值、团队当前资源无法覆盖的功能点,全部移动到待后续迭代的待确认清单中,不要为了凑功能清单长度增加不必要的开发成本,优先保障核心用户流程的完整可用。
常见问题4:验收项写得太细会不会限制研发的自主实现空间?
验收项只定义可观察的输入输出结果、边界反馈和最终用户侧的表现,不需要指定研发具体的技术实现方案,既可以避免需求传递偏差,也不会干涉正常的技术选型决策,完全可以兼顾需求准确性和研发自主性。
最后提醒所有使用者,本文提到的墨刀相关的生成入口、PRD导出、团队协作、权限配置等能力,都以墨刀官方当前公开版本的实际功能为准,请勿将文中的示例内容等同于真实线上产品的已实现能力,所有生成内容都需要产品从业者完成最终的人工校验和调整后再落地使用。
 Go reflect.TypeFor 如何在泛型函数中获取类型
- 上一篇
- Go reflect.TypeFor 如何在泛型函数中获取类型
- 下一篇
- Linux perf record 采样频率过高时如何调整
-
- 文章 · 软件教程 | 20分钟前 | 墨刀教程 · 产品经理实用工具 · AI PPT制作 · 办公工具技巧 · 演示文档优化 · 墨刀AI生成PPT跑偏 墨刀AI PPT内容修复 AI PPT页面结构调整 墨刀AI输入优化方法 PPT生成结果排查
- 墨刀AI生成PPT时内容跑偏怎么办?从输入材料到页面结构逐项排查
- 326浏览 收藏
-
- 文章 · 软件教程 | 33分钟前 | 墨刀AI · PPT制作教程 · 产品方案整理 · 办公效率工具 · 产品经理实用工具 · 墨刀AI生成产品方案PPT 产品经理汇报PPT教程 产品方案转PPT步骤 墨刀AI PPT校对方法 产品汇报材料筛选技巧
- 墨刀AI怎么把产品方案整理成PPT?从材料筛选到逐页校对
- 352浏览 收藏
-
- 文章 · 软件教程 | 46分钟前 | 墨刀教程 · 需求交付规范 · PRD撰写 · AI产品工具 · 产品经理实操 · 墨刀AI PRD验收方法 墨刀生成PRD检查步骤 AI产品需求文档交付标准 PRD内容质量校验流程 PRD协作权限配置指南
- 墨刀AI生成的PRD怎么验收?从内容质量、文档格式到权限逐项检查
- 413浏览 收藏
-
- 文章 · 软件教程 | 1小时前 | 墨刀教程 · PRD编写 · 产品需求文档 · AI辅助产品设计 · 业务需求梳理 · 墨刀AI生成访客登记PRD 访客登记PRD编写方法 墨刀AI产品文档生成 PRD产出效率技巧 访客登记需求梳理
- 墨刀AI怎么生成访客登记PRD?先整理角色、规则和异常状态
- 166浏览 收藏
-
- 文章 · 软件教程 | 1小时前 | 墨刀教程 · 产品评审 · 产品原型验收 · 表单设计 · 协作工具使用 · 墨刀AI表单原型验收 墨刀表单字段规则检查 表单状态反馈验收方法 表单原型权限校验 墨刀原型评审规范
- 墨刀AI生成的表单原型怎么验收?检查字段规则、状态反馈和权限
- 210浏览 收藏
-
- 文章 · 软件教程 | 1小时前 | 开发工具 · vs code · Remote SSH · VS Code 端口转发 Ports Remote SSH
- VS Code Remote SSH 端口转发入口在哪里设置
- 391浏览 收藏
-
- 文章 · 软件教程 | 1小时前 | 效率工具 · 墨刀教程 · 产品原型技巧 · 多角色设计 · 原型复用 · 墨刀AI多角色原型制作 墨刀原型减少返工技巧 多角色权限原型设计 墨刀任务骨架复用教程 业务原型权限差异处理
- 墨刀AI生成多角色原型怎么减少返工?先复用任务骨架再补权限差异
- 494浏览 收藏
-
- 文章 · 软件教程 | 2小时前 | 墨刀教程 · 产品原型制作 · AI生成原型技巧 · 产品需求梳理 · 原型交互校验 · 墨刀AI原型异常状态补齐 墨刀原型需求重写技巧 墨刀空错误状态生成教程 墨刀AI原型走查方法 墨刀原型任务规则梳理
- 墨刀AI生成的原型缺少异常状态怎么办?按任务、规则和结果重写需求
- 291浏览 收藏
-
- 文章 · 软件教程 | 2小时前 | 墨刀AI · 原型设计教程 · 内部系统原型 · 产品工具实操 · 需求落地方法 · 墨刀AI生成员工报修原型 墨刀AI原型生成教程 内部报修产品原型制作 墨刀原型异常状态补全 产品经理AI原型实操
- 墨刀AI怎么生成员工报修原型?从需求描述到异常状态补全
- 360浏览 收藏
-
- 文章 · 软件教程 | 2小时前 | 需求管理 · 产品原型 · 墨刀使用教程 · 研发协作 · 创业者工具 · 墨刀原型交付方法 墨刀AI研发交付规范 产品原型状态整理教程 研发需求降歧义技巧 墨刀原型验收说明编写
- 墨刀AI创业者交付给研发前怎么整理原型?补齐状态、规则和验收说明
- 110浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 30次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 132次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 68次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 24次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 13次使用
-
- 墨刀AI适合产品经理做需求澄清吗?从访谈笔记到评审材料的输入边界
- 2026-09-15 262浏览
-
- 墨刀AI能帮产品经理做需求变更评审吗?先画影响范围再改原型
- 2026-09-15 304浏览
-
- 产品经理评估墨刀AI前怎么做小样测试?用一个需求走完输入、评审和交付
- 2026-09-15 147浏览
-
- 研发团队评估墨刀AI前要测什么?用一次原型变更跑通开发交接闭环
- 2026-09-15 410浏览
-
- 墨刀AI适合创业者验证产品想法吗?先做任务原型再决定是否开发
- 2026-09-15 255浏览


