
墨刀AI适合研发团队做技术预评审吗?把原型假设转成接口问题清单
墨刀AI可以帮助研发团队从原型整理候选技术问题,但不能替代架构设计、接口定义、安全评估、容量判断和开发估时。如果你需要先查看墨刀官方公开的原型能力说明,可访问地址 https://modao.cc/ 核对当前版本的所有公开功能。
很多中小研发团队在拿到产品原型后经常直接进入排期,很容易忽略原型里藏着大量未明确标注的假设,等到开发中途才发现很多逻辑没有对齐,导致项目延期。用墨刀AI做预评审辅助的核心价值,就是把这些藏在视觉表现背后的隐性假设全部挖出来,转化成可跟踪的接口问题清单,避免后期出现大范围的需求返工。
正式启动预评审的第一步,必须先冻结当前原型的版本和功能范围,约定评审周期内不随意新增未同步过的交互和页面,所有团队成员都基于同一版原型开展梳理工作。接下来逐页拆解原型内容,依次列出每个页面对应的所有用户动作、动作触发的前置条件、操作成功后的返回状态、操作失败后的提示状态、异常场景下的用户恢复路径,以及整个交互流程里产生和调用的所有数据对象。
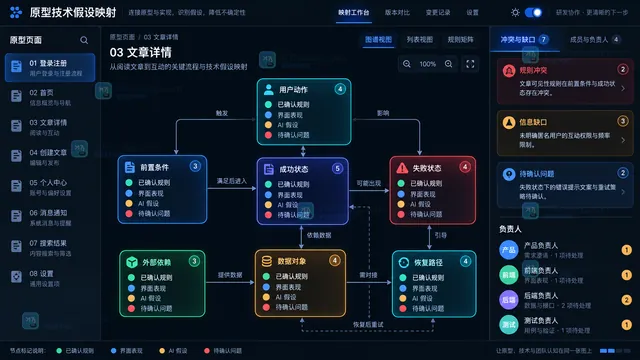
完成初步拆解后,必须明确区分四类不同属性的内容,不能混为一谈:第一类是产品已经正式确认的业务规则,比如「用户下单前必须完成实名认证」这类写在需求文档里的固定规则;第二类是原型自带的视觉表现,比如占位的弹窗样式、临时填充的测试文案,这类内容不属于业务规则,仅代表交互表现效果;第三类是墨刀AI自动生成的推测性假设,比如AI根据页面上的多图展示自动推测出的批量上传规则,这类内容默认没有经过产品侧确认;第四类是研发团队提出的待确认问题,所有无法从前三类内容里直接得到明确答案的点,都要纳入这个分类跟踪。
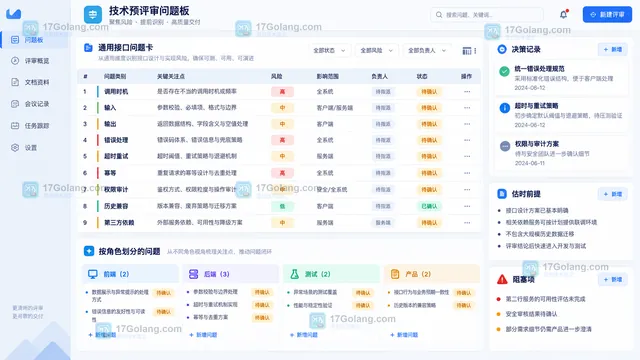
针对梳理出的所有交互流程,接口维度的待确认问题至少要覆盖十一个核心方向:第一是接口的调用时机,明确用户操作到哪一步才会触发接口请求;第二是接口的输入参数边界,比如哪些字段是必填、哪些是选填、各类输入的长度和格式约束;第三是接口的输出内容范围,明确正常返回需要携带哪些字段,哪些字段仅做前端展示不需要后端返回;第四是分页或批量处理规则,明确列表类数据的分页逻辑、批量提交的单次最大数量限制;第五是错误码的分类规则,区分业务错误、系统错误、网络错误的不同返回逻辑;第六是失败后的重试机制,明确哪些操作场景允许自动重试、重试的间隔次数限制;第七是接口调用的超时阈值,不同网络环境下最长的用户可接受等待时间;第八是接口的幂等性约束,哪些重复提交的操作需要保证后端不生成冗余数据;第九是接口的权限校验规则,明确不同角色的用户调用该接口的准入条件;第十是操作的审计留痕要求,哪些接口的调用日志需要长期存储满足合规要求;第十一是历史版本兼容规则和第三方服务依赖关系,确认哪些旧版本客户端不能直接废弃,哪些外部接口的可用性会直接影响当前业务流程。以上所有问题都仅做候选梳理,不需要提前编造具体的字段值、错误码和实现方案,全部留待后续技术讨论确认。
在整个预评审过程中,墨刀AI仅适合承担重复问题归类、标准化检查清单生成的辅助工作,绝对不能直接替代研发团队决定接口协议选型、技术栈选型、数据库结构设计、安全合规方案这类核心技术决策。所有AI生成的结论都必须经过对应领域的专业人员二次校验,避免因为AI的推测性错误带来技术方案风险。
最终输出的技术预评审结果,必须包含五个核心模块:第一是所有外部内部的依赖项列表,明确各个依赖的交付方和最晚交付时间;第二是不同等级的风险清单,标记出高、中、低风险对应的应对预案;第三是每个待确认问题的决策人,避免多人重复讨论却无人拍板;第四是还没有得到明确结论的待确认项汇总,全部同步给所有协作方;第五是所有会影响开发估时的前提条件,明确标注哪些估时是基于什么假设得出的,绝对不能在前提条件完全未知的情况下给出确定的开发工期承诺。
常见问题
墨刀AI能自动从原型中导出完整可直接使用的接口文档吗?
不能,墨刀AI当前生成的所有接口相关内容都属于候选参考材料,仅用于帮助团队快速梳理待确认的问题方向,所有接口字段、规则、定义都需要研发团队人工校验确认后才能正式进入开发流程。
技术预评审阶段我们还没确定技术栈,能先用墨刀AI生成的问题清单推进讨论吗?
完全可以,预评审阶段的核心目标是先锁定所有需求层面的假设和不确定点,不需要先定技术栈,你可以先把所有动作、状态、数据依赖梳理完成后,再结合后续选定的技术栈补全对应的实现约束即可。
原型里很多视觉动效没有标注触发逻辑,墨刀AI能直接补全这部分的技术实现规则吗?
不能,未在原型文档中明确标注的动效规则都属于待确认项,墨刀AI生成的相关描述都属于推测性假设,需要和产品、交互团队确认后才能纳入正式的需求范围,不能直接作为开发依据。
如果预评审阶段发现超过30个待确认问题,是否要直接暂停项目开发?
不需要,你可以按问题的影响等级拆分,高影响的核心依赖问题优先找对应决策人确认,低影响的边缘兼容问题可以在后续迭代中逐步明确,只要把所有未确认点的风险和对应的估时影响同步给所有协作方即可,不需要强行在预评审阶段100%澄清所有细节。
最后需要提醒所有团队,墨刀相关的具体协作功能、原型存储规则、文档导出权限、成员权限配置、定价方案、使用额度与版本能力,全部以墨刀官方当前公开的最新版本说明为准。所有AI生成的内容都仅作为候选参考素材,核心技术决策、业务规则校验、安全与容量评估环节必须安排专业人员完成人工审核,不要直接将AI输出结果作为生产环境的落地依据。
 Go strconv.ParseFloat 解析科学计数法时如何保留精度边界
- 上一篇
- Go strconv.ParseFloat 解析科学计数法时如何保留精度边界
- 下一篇
- VS Code launch.json 的 preLaunchTask 为什么没有执行
-
- 文章 · 常见问题 | 28分钟前 | 产品原型 · 墨刀使用教程 · 研发协作 · 交互测试 · 缺陷管理 · 墨刀AI交互缺陷复现 研发团队状态路径对齐 墨刀缺陷记录规范 交互问题复现方法 产品研发协作工具
- 墨刀AI能帮研发团队复现交互缺陷吗?用状态路径对齐问题现场
- 470浏览 收藏
-
- 文章 · 常见问题 | 1小时前 | 墨刀AI · 产品工具选型 · 原型制作 · 团队协作流程 · 产品实操指南 · 墨刀AI评估方法 产品经理小样测试流程 墨刀原型工具选型 墨刀AI需求输入规范 原型交付评审方法
- 产品经理评估墨刀AI前怎么做小样测试?用一个需求走完输入、评审和交付
- 147浏览 收藏
-
- 文章 · 常见问题 | 1小时前 | 原型设计 · 需求管理 · 墨刀使用技巧 · 产品工具指南 · 跨团队协作 · 墨刀AI需求变更评审 产品经理需求影响分析 原型改动追溯方法 跨职能需求评审流程 需求变更管理技巧
- 墨刀AI能帮产品经理做需求变更评审吗?先画影响范围再改原型
- 304浏览 收藏
-
- 文章 · 常见问题 | 1小时前 | 需求管理 · 墨刀AI · 产品经理工具 · PRD草拟 · 需求评审 · 墨刀AI需求澄清用法 产品经理访谈笔记整理 墨刀AI评审材料生成 产品需求事实分类方法 墨刀AI输入边界规则
- 墨刀AI适合产品经理做需求澄清吗?从访谈笔记到评审材料的输入边界
- 262浏览 收藏
-
- 文章 · 常见问题 | 1小时前 | 运营效率工具 · 成本估算方法 · AI电商设计 · 素材多端适配 · SkildArt实操 · SkildArt电商AI作图 多平台改版成本估算 电商素材工时拆解 设计安全区合规 跨境运营素材核算
- SkildArt 电商AI作图怎么估算多平台改版成本?按比例、安全区和复核拆工时
- 232浏览 收藏
-
- 文章 · 常见问题 | 2小时前 | 电商运营工具 · AI作图选型 · SkildArt评测 · 多人协作评估 · 跨境营销工具 · 电商AI作图工具选型 SkildArt多人协作测试 素材交接成本评估 AI作图版本管理 电商团队协作流程
- 电商AI作图工具选型怎么测多人协作?用SkildArt评估交接、版本和复核成本
- 229浏览 收藏
-
- 文章 · 常见问题 | 2小时前 | AI模特图 · SkildArt实用教程 · 工时管理 · 电商成本管控 · 人工复核标准 · SkildArt AI模特图复核成本估算 AI模特图工时拆分方法 电商商品AI图复核标准 跨境AI模特图成本控制 AI生成图人工复核规则
- SkildArt AI模特图项目怎么估算商品复核成本?按遮挡、图案和版本拆工时
- 243浏览 收藏
-
- 文章 · 常见问题 | 3小时前 | 运营效率工具 · AI电商工具 · SkildArt使用教程 · AI模特图 · 多色生成测试 · AI模特图工具选型 同款多色一致性测试 SkildArt实操指南 电商AI生图对照方法 跨境电商AI模特图生成
- AI模特图工具选型为什么要测同款多色?用SkildArt建立一致性对照
- 252浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 27次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 131次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 64次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 23次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 8次使用
-
- 墨刀AI能帮产品经理做需求变更评审吗?先画影响范围再改原型
- 2026-09-15 304浏览