
SkildArt做AI白底图时哪些商品要先小样?透明、反光与细边缘判断
透明、镜面反光、毛发织物、细链条、网孔、镂空和多配件交叠商品不宜只凭一张结果直接批量,应先做代表性小样并逐项检查轮廓、材质和结构。你可通过SkildArt官方平台了解完整功能说明,官方地址为https://www.skildart.cn/。
日常运营过程中,不少团队为了提升电商商品上新效率,会选择AI白底图工具批量处理数百甚至数千件商品图,但如果没有提前区分不同商品的生成风险,很容易出现大面积边缘错误、材质失真、结构篡改的问题,后续返工反而会消耗更多人力时间。普通实体、轮廓清楚、材质稳定、背景对比充分的商品同样需要后续人工验收,但这类商品的生成容错率更高,通常测试1-2个小样就可以快速建立稳定的批量处理规则。
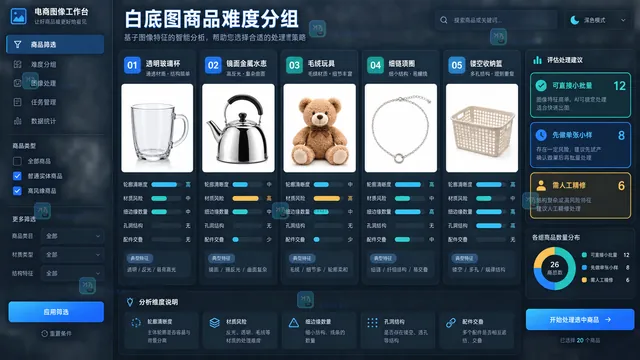
针对透明类商品,小样阶段必须重点记录商品的真实边界、厚度和不同部分的透射关系,不能允许生成结果随意加厚透明板材边缘、填充玻璃或亚克力内部的通透区域,更不能出现AI自行补充的不存在的花纹、分层结构。不少透明商品比如亚克力展示架、玻璃器皿、硅胶容器,一旦批量生成出错,很容易让买家误以为商品边缘是实心底、厚度和宣传不符,带来不必要的售后咨询和退换货问题。
针对镜面反光类商品,小样阶段需要明确区分材质本身的固有色彩、纹路和拍摄时的环境反射,绝对不能把AI自动抹除全部反光的结果当成合格标准,也不允许生成结果擅自补充商品原本没有的结构造型。比如亮面金属首饰、镜面数码产品外壳、抛光陶瓷摆件这类商品,如果批量生成时把表面的正常光泽反射全部替换成哑光材质,会直接完全丢失商品本身的材质卖点,违背白底图突出商品真实属性的初衷。
针对毛发、流苏、细链条、鞋带、网孔和镂空类商品,小样阶段需要逐点检查常见的几类错误:边缘是否出现不该有的断裂粘连、原本镂空的孔洞是否被自动填充、精细边缘是否出现不该有的发灰毛边。很多服饰类的毛领配件、手工编织的网包、金属细链配饰,这类商品的细节本身就是消费者决策的核心参考点,如果批量生成后毛领边缘糊成一团、细链断成好几截,后续商品图的点击率和转化表现都会受到明显影响。
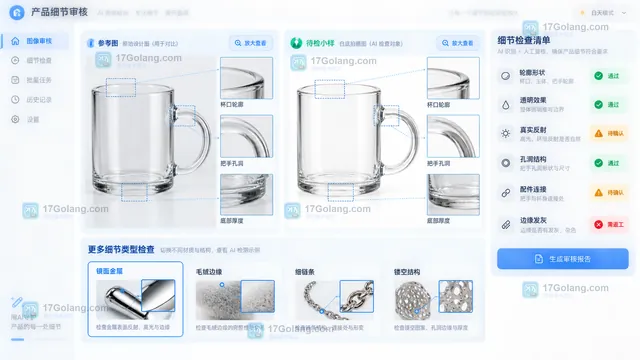
不管是低风险还是高风险商品,用来生成AI白底图的原始参考图本身都要满足几个基础要求:画面清晰无遮挡、主体商品的光线明暗层次可辨、覆盖后续交付需要展示的全部角度。如果原始参考图里完全没有拍摄商品的背面、内部结构细节,不要强行要求工具生成完全符合真实产品的隐藏细节,这类不符合原始参考信息的生成结果,很容易和真实商品出现偏差,引发后续的客诉问题。
小样测试完成后,建议运营和设计团队做好对应记录,包含边缘合格通过情况、单张图人工修订的平均分钟数、本次测试发现的主要失败原因、相同商品多次生成结果的可重复性,绝对不能只以生成结果整体视觉好看作为判断标准,必须优先对齐商品本身的真实事实,避免AI生成的美化结果和实物产生不必要的出入。具体白底图制作入口、编辑方式、参数、导出格式、额度和商业授权以SkildArt当前版本为准,所有生成的候选素材都必须经过人工最终校验才能正式上线使用。
常见实操问答
Q1:我手上一批款式不同的全透明玻璃水杯,能不能直接选批量生成AI白底图?
A1:不建议直接启动批量操作,你可以先在这批水杯里挑选3-4个厚度不同、造型差异大、带不同异形把手的代表性样品做小样测试,逐项检查边缘没有发灰模糊、玻璃本身的通透厚度还原准确、把手衔接处没有缺漏、AI没有在玻璃内部生成不存在的暗纹或斑点。确认3个不同样品的生成结果全部符合要求后,再整理出对应批次的批量处理规则,后续还要按比例抽验10%以上的批量结果确认稳定性。
Q2:之前用普通抠图工具处理金属镜面反光手链经常留环境阴影,用AI白底图是不是不用提前测小样就能直接批量做?
A2:这类高反光金属商品属于高风险品类,必须先做小样验证。因为AI很容易把拍摄环境里落在手链表面的无关反光图案误判成商品本身的纹路,也可能错误填充手链链节之间的镂空缝隙,甚至把细针状的耳钉扣直接抹除。你需要先挑2-3款不同复杂度的镜面手链做小样,确认生成结果保留了合理的金属光泽、没有额外添加不存在的花纹、链节之间的镂空间隙没有被错误堵死,连续2次生成的结果没有出现随机错乱的细节,再推进后续批量流程。
Q3:批量做毛绒玩具类的毛发类商品,小样阶段重点要看哪些维度才算合格?
A3:首先要检查毛绒外层的毛发边缘没有生硬切边,也没有出现明显的灰色半透明晕轮,远看不会发虚发糊;其次要确认毛绒表面的凸起毛流部分没有出现局部断裂、缺块的问题,商品自带的布标、挂饰、小配件位置没有出现偏移变形;最后还要核对生成结果没有擅自修改毛绒原本的配色,也没有额外添加不存在的蓬松绒毛效果,全部要点都符合要求之后,再扩大处理同类型商品的批量任务。
Q4:多配件交叠的首饰套装,小样阶段的记录内容要包含哪些项才算达标?
A4:首先要记录套装里每一个独立配件的边缘合格通过率,统计单张完整套装商品图需要的平均人工修订时长,把测试过程中发现的主要失败点逐一记录下来,比如耳针是否缺失、项链细链是否断裂、戒指和搭配托架之间的缝隙是否被错误填充,还要验证同一样品连续2次生成的结果细节稳定,不会每次都出现随机不同的错误,确认所有指标都在团队可接受的返工成本范围内,再安排后续批量处理流程。
最后需要提醒所有使用AI白底图工具的团队,AI生成的内容永远只能作为候选素材,人工校验确认商品事实的环节绝对不能省略,不要为了追求处理速度牺牲商品图的准确性,避免生成结果和实物不符带来的各种不必要的运营风险。
 Redis PUBSUB shard channels 与普通频道如何选
- 上一篇
- Redis PUBSUB shard channels 与普通频道如何选
- 下一篇
- Go time.Timer Reset 重用定时器前如何排空旧事件
-
- 文章 · 常见问题 | 41分钟前 | 电商设计 · 工具测评 · 白底图制作 · 效率评估 · AI图片处理 · SkildArt批量白底图 AI白底图边缘通过率 电商商品白底图批量制作 白底图人工修订成本 商品分层白底图测试
- SkildArt适合批量做白底图吗?用边缘通过率和人工修订时间判断
- 186浏览 收藏
-
- 文章 · 常见问题 | 1小时前 | 跨境素材本地化 · 工时估算 · 电商运营排期 · 多语言设计 · 协作流程优化 · SkildArt跨境素材本地化工时估算 跨境素材本地化排期方法 跨境运营本地化人力核算 跨境电商设计返工工时拆分 多语言素材语言复核工时计算
- SkildArt跨境素材项目如何估算本地化工时?语言复核、尺寸适配与返工拆分
- 167浏览 收藏
-
- 文章 · 常见问题 | 1小时前 | AI电商工具 · SkildArt使用指南 · 跨境运营效率 · 素材生产流程 · 内容合规管理 · SkildArt跨境素材适用场景 跨境电商AI素材生成 SkildArt任务判断清单 跨境素材批量生产指南 AI跨境素材合规校验
- SkildArt适合哪些跨境电商素材任务?先做与慎用场景判断清单
- 194浏览 收藏
-
- 文章 · 常见问题 | 1小时前 | 跨境电商运营 · SkildArt使用指南 · 素材生产流程 · 多市场营销 · 设计协作规范 · SkildArt跨境素材拆分 避免跨境电商一图通用 多市场电商素材制作 多语言素材审核规范 电商渠道素材适配技巧
- SkildArt做跨境电商素材如何避免一图通用?按市场、语言和渠道拆分任务
- 411浏览 收藏
-
- 文章 · 常见问题 | 2小时前 | SkildArt使用指南 · 跨境运营效率 · 设计项目预算 · AI营销图实操 · 成本管控方法 · SkildArt批量营销图预算分配 跨境电商AI营销图成本核算 营销图试跑返工成本计算 AI设计多尺寸复用核算 电商设计项目交付管控
- SkildArt批量营销图预算怎么分配?试跑、返工与多尺寸复用核算表
- 465浏览 收藏
-
- 文章 · 常见问题 | 2小时前 |
- 外贸企业出口前如何核对原产地证和报关要素
- 248浏览 收藏
-
- 文章 · 常见问题 | 2小时前 | SkildArt教程 · 电商运营工具 · AI营销图 · 跨境素材制作 · 营销设计规范 · SkildArt AI营销图适用渠道 电商AI主图制作 跨境社媒AI素材生成 店铺横幅AI设计 多渠道营销图分工方法
- SkildArt生成AI营销图适合哪些渠道?主图、横幅与社媒素材如何分工
- 444浏览 收藏
-
- 文章 · 常见问题 | 3小时前 | 跨境运营工具 · SkildArt使用指南 · 电商设计成本 · 内容生产核算 · 设计团队协作 · SkildArt详情页成本计算 电商详情页制作预算核算 跨境商品详情页排期方法 详情页模块返工成本统计 多SKU详情页批量成本控制
- SkildArt做电商详情页成本怎么算?按模块、返工与交付核算
- 395浏览 收藏
-
- 文章 · 常见问题 | 3小时前 | 电商运营 · 工具选型 · SkildArt教程 · 详情页制作 · 跨境出海 · 电商详情页生成工具选型 SkildArt测试要点 跨境运营工具评估 电商设计效率提升 详情页交付规范检查
- 电商详情页生成工具怎么选?用SkildArt测试的五个要点
- 244浏览 收藏
-
- 文章 · 常见问题 | 3小时前 | 设计协作 · 电商运营技巧 · SkildArt常见问题 · 工具使用指南 · AIGC设计 · SkildArt电商详情页生成 电商视觉素材制作 跨境电商详情页设计 AI电商设计工具 电商详情页模块拆分
- SkildArt能做电商详情页生成吗?功能范围和适用场景
- 470浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 26次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 130次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 62次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 23次使用
-

- OpenCompass
- OpenCompass是上海AI实验室推出的开源大模型评测平台,提供CompassKit、CompassHub和CompassRank三大核心组件,支持LLM及多模态模型的一站式标准化评估与排行榜查询。
- 81次使用
-
- 电商详情页生成工具怎么选?用SkildArt测试的五个要点
- 2026-09-14 244浏览
-
- SkildArt生成AI营销图适合哪些渠道?主图、横幅与社媒素材如何分工
- 2026-09-14 444浏览
-
- SkildArt成套商品图导出前怎么检查命名和尺寸?
- 2026-09-14 215浏览
-
- 跨境电商运营怎么用SkildArt?第一次完成真实任务的操作路线
- 2026-09-14 195浏览
-
- SkildArt AIGC营销素材生成不生效怎么办?常见原因和排查方法
- 2026-09-14 457浏览


