
Transformers tokenizer padding_side 设置错误会怎样影响批推理
批量生成时,padding_side 不是排版选项,而是会影响模型从哪一个位置继续预测。对 decoder-only 模型,输入长度不一致且使用 padding=True 时,通常应把 tokenizer 配成左填充:真实 token 对齐到批张量右端,generate() 取到的最后位置才是每条输入的真实末尾。右填充可能触发 “right-padding was detected” 警告,也可能让批推理结果和单条推理不一致。
官方文档:https://huggingface.co/docs/transformers/
- decoder-only 批生成优先使用
padding_side="left",右填充会把补齐 token 留在序列末端。 attention_mask负责注意力可见范围,不能把错误的最后时间步自动变成真实末 token。- encoder-decoder 不要机械套用同一配置,最终用 batch=1、batch>1 和不同长度输入做回归。
right padding 为什么会让批生成从错误位置继续
假设同一批有两条输入,一条短、一条长。右填充会把短输入写成“真实 token + padding token”,这样两行的最后一列并不都是真实内容。decoder-only 模型的生成是从序列末端接续,末列落在补齐 token 上时,模型看到的生成起点就偏了。
attention_mask 仍然重要,但它解决的是注意力范围:哪些位置可以参与计算。它不会改变批张量的列数,也不会替 generate() 自动选择每一行最后一个非 padding 位置。因此“mask 已经传了”不能单独证明填充方向正确。
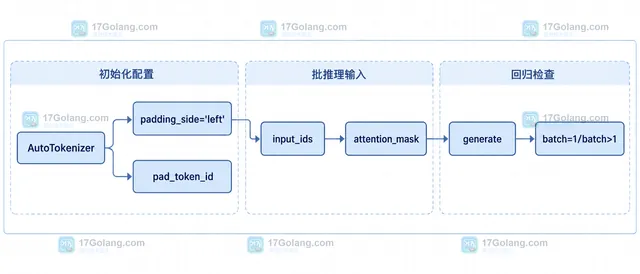
先按模型架构决定填充方向
对常见的 decoder-only 因果语言模型,初始化时直接声明左填充,并处理没有 pad token 的 tokenizer。某些模型把 EOS 同时作为 padding 的占位符,这不是“让 EOS 提前结束”的意思;在生成配置和 attention mask 正确传入的前提下,它只是补齐位置的 token id,具体仍要看模型卡和使用方式。
from transformers import AutoTokenizer, AutoModelForCausalLM

# 左填充让不同长度输入的真实末 token 对齐到批张量右端
model_name = "your-causal-lm"
tokenizer = AutoTokenizer.from_pretrained(
    model_name,
    padding_side="left",
)
model = AutoModelForCausalLM.from_pretrained(model_name)

# 部分 decoder-only tokenizer 没有独立的 pad token,需要显式补齐
if tokenizer.pad_token_id is None:
    tokenizer.pad_token = tokenizer.eos_token
model.config.pad_token_id = tokenizer.pad_token_id
这里的关键不是把 warning 静音,而是让模型架构、tokenizer 的填充策略和生成配置保持一致。不要只修改 model.config 而忘记 tokenizer:真正生成 input_ids 的是 tokenizer。
把 input_ids、attention_mask 和 generate 绑在一起
批推理时应让 tokenizer 同时返回 input_ids 和 attention_mask,并把二者一起传给 generate()。下面的切片使用批张量的统一输入宽度,取出新增 token;它不把左侧补齐区域当成模型回答。
prompts = [
    "解释向量数据库的倒排索引",
    "用一句话说明 attention_mask 的作用",
]

# 统一补齐宽度,保留每行的可见范围
batch = tokenizer(
    prompts,
    padding=True,
    return_tensors="pt",
)

# max_new_tokens 限制新增长度,避免被输入长度配置间接影响
generated = model.generate(
    input_ids=batch["input_ids"],
    attention_mask=batch["attention_mask"],
    max_new_tokens=64,
)

# generate 返回“输入 + 新 token”,统一输入宽度后再截取新内容
input_width = batch["input_ids"].shape[1]
new_tokens = generated[:, input_width:]
answers = tokenizer.batch_decode(new_tokens, skip_special_tokens=True)
如果模型和输入在 GPU 上,实际项目还要把 batch 移到与模型相同的设备;这属于设备管理,不改变 padding_side 的判断。对 chat model 还要先按模型要求使用 chat template,避免把 prompt 格式问题误判成填充问题。
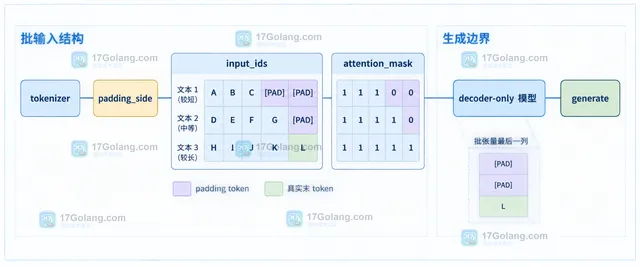
不要把所有模型都改成 left padding
填充方向要跟模型的输入语义绑定。decoder-only 模型的批生成关注输入序列最后位置,因此左填充通常是安全起点;encoder-decoder 模型先把输入交给 encoder,再由 decoder 生成,常见配置不应因为看到一条 decoder-only 警告就全局改写。
| 检查对象 | decoder-only 批生成 | encoder-decoder |
|---|---|---|
| 优先关注 | 最后一列是否为真实输入 token | encoder 输入与 decoder 起始配置 |
| 常见填充选择 | padding_side="left" | 按模型 tokenizer 与官方示例决定,通常不机械迁移 |
| 回归方式 | 单条、短长混合批、相同长度批 | 编码器输入与解码器输出分别检查 |
生产环境至少保留三组样本:batch=1、两条长度明显不同的 batch,以及长度相同的 batch。若只有 batch=1 正常,短长混合批异常,优先检查填充方向、pad_token_id 和截取输出的宽度;若三组都异常,再检查 prompt 模板、模型权重和设备。
常见问题
只传 attention_mask,还需要设置 padding_side 吗?
需要。mask 说明哪些位置可见,padding_side 决定真实输入落在序列哪一侧;对 decoder-only 批生成,两者承担的职责不同。
为什么单条输入看不出 right padding 的问题?
batch=1 且不需要补齐时,序列末端通常就是真实 token,错误配置没有暴露。换成长度不同的批才会出现补齐列。
把 pad_token 设成 eos_token 会不会马上停止生成?
不会因为补齐位置本身就必然停止。停止条件由生成过程中的 EOS 判断控制,但仍应结合具体模型文档、attention_mask 和实际回归样本确认。
 Go errors.Join 组合错误后如何让 errors.Is 继续匹配
- 上一篇
- Go errors.Join 组合错误后如何让 errors.Is 继续匹配
- 下一篇
- SkildArt生成的图能直接当商品首图吗?平台规则与人工校对清单
-
- 科技周边 · 人工智能 | 2小时前 | python · 数据处理 · 人工智能 · Hugging Face Datasets streaming IterableDataset
- Hugging Face Datasets 流式读取大语料时如何切分样本
- 449浏览 收藏
-
- 科技周边 · 人工智能 | 3小时前 |
- Embedding 余弦相似度异常时如何检查向量归一化
- 383浏览 收藏
-
- 科技周边 · 人工智能 | 4小时前 | 人工智能 · openai api · 工程实践 · 批处理 · OpenAI Batch API custom_id 批量请求结果映射 JSONL 结果回配
- OpenAI Batch API 用 custom_id 如何对应原始请求
- 105浏览 收藏
-
- 科技周边 · 人工智能 | 6小时前 | API · 人工智能 · 工具调用 · OpenAI Responses API Function Calling tool call
- OpenAI 工具调用返回多个 tool call 时如何逐个回传结果
- 146浏览 收藏
-
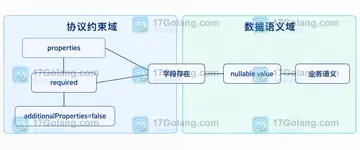
- 科技周边 · 人工智能 | 7小时前 | openai · json schema · Structured Outputs · OpenAI Nullable Schema JSON Schema Structured Outputs
- OpenAI Structured Outputs 可选字段如何设计兼容 schema
- 281浏览 收藏
-
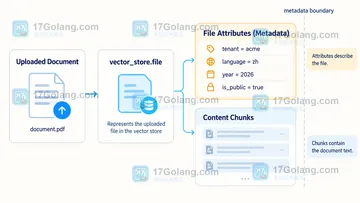
- 科技周边 · 人工智能 | 8小时前 | 人工智能 · openai api · 检索增强生成 · 文件搜索 · OpenAI Attributes 元数据过滤 Responses API File Search vector store
- OpenAI File Search 元数据过滤怎样缩小检索范围
- 426浏览 收藏
-
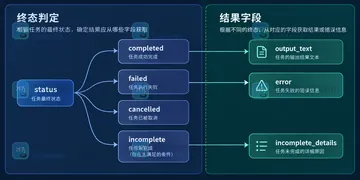
- 科技周边 · 人工智能 | 9小时前 | 异步任务 · 人工智能 · openai api · 接口开发 · 轮询 后台任务 background true OpenAI Responses API response_id
- OpenAI Responses API 后台任务完成后如何取回结果
- 314浏览 收藏
-
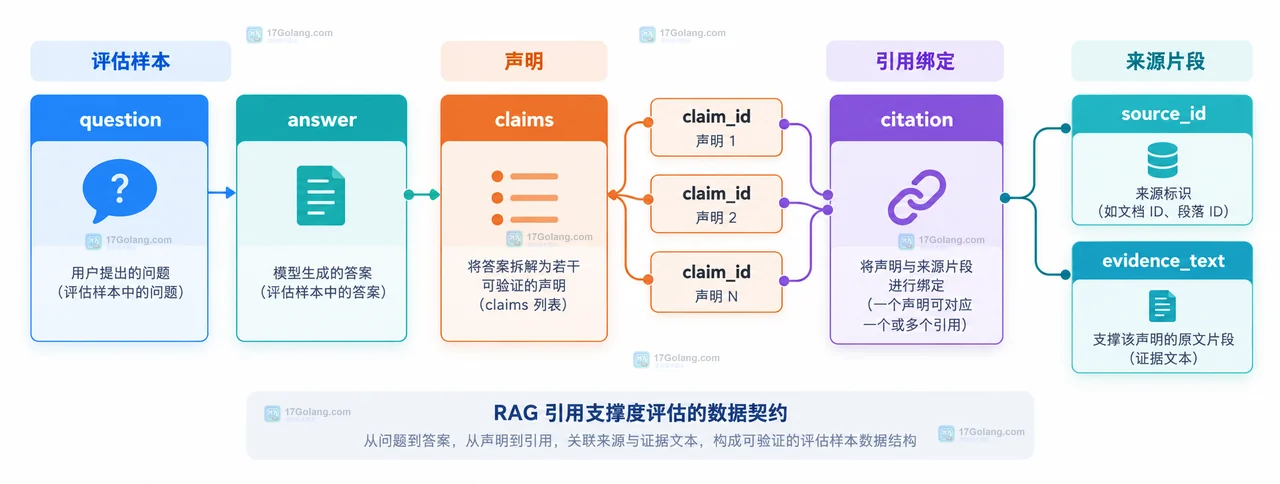
- 科技周边 · 人工智能 | 1天前 |
- 引用支撑度评估怎么配置或排查
- 115浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- LoRA 数据字段怎么配置或排查
- 171浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · 性能排查 · 提示词工程 · Hugging Face · 模型推理 · KV Cache · 提示词缓存动态字段 DynamicCache KV缓存 Transformers缓存 past_key_values use_cache StaticCache
- 提示词缓存动态字段怎么配置或排查
- 397浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 24次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 128次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 55次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 22次使用
-

- OpenCompass
- OpenCompass是上海AI实验室推出的开源大模型评测平台,提供CompassKit、CompassHub和CompassRank三大核心组件,支持LLM及多模态模型的一站式标准化评估与排行榜查询。
- 77次使用
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览
-
- Canva手机闪退解决方法及适配指南
- 2026-05-25 501浏览


