
Go fuzzing 添加种子语料后怎样定位首次失败输入
Go fuzzing 失败后,最有价值的线索通常就在失败日志最后两行:一行是写入的语料文件路径,另一行是可以单独重放的 go test -run=FuzzName/hash 命令。先复制这条命令定位单个输入,再打开 testdata/fuzz/FuzzName 下的文件确认参数,通常比重新跑一轮随机 fuzz 更快。
f.Add和testdata/fuzz/FuzzXxx都是默认会执行的种子语料。- 失败输入会先经过最小化,日志中的 hash 是稳定的单测子名称。
- 修复后优先运行普通
go test,让留下来的失败语料承担回归测试职责。
为什么添加种子后普通 go test 也会执行
Go 的 fuzz 测试有两个相连的入口:不带 -fuzz 时,它像普通测试一样遍历已有种子;带 -fuzz=FuzzXxx 时,测试引擎再围绕种子变异输入并寻找新覆盖路径。种子不是一次性启动参数,而是测试的一部分,所以一个失败语料被写入后,下一次普通测试仍会遇到它。
这正是定位问题的关键:失败后不要先删除文件,也不要只看随机输入的打印结果。文件名和文件内容共同描述了可以复现的测试样本。
用 f.Add 和 testdata/fuzz 管好输入
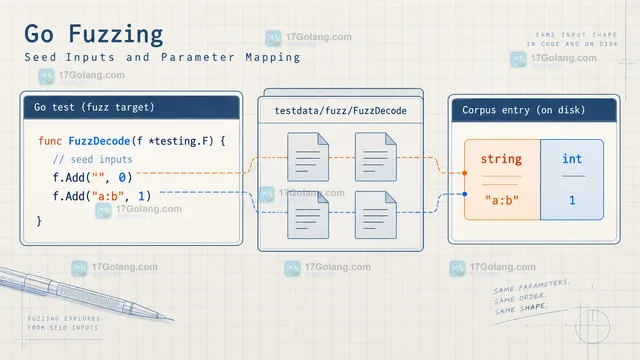
简单、稳定的边界值适合直接写在测试里;需要长期保留、便于代码审查的样本适合落到目录。两种来源进入同一个种子集合,但参数类型必须与 fuzz 目标完全一致,顺序也不能交换。
func FuzzDecode(f *testing.F) {
    // 用短样本覆盖空值、分隔符和正常输入等基础路径。
    f.Add("", 0)
    f.Add("a:b", 1)

    f.Fuzz(func(t *testing.T, raw string, mode int) {
        // 目标函数应尽量确定性,失败时让 testing.T 保留现场。
        if _, err := Decode(raw, mode); err != nil && raw == "a:b" {
            t.Fatalf("decode failed: %v", err)
        }
    })
}
如果要手工放置目录语料,路径应是当前包内的 testdata/fuzz/FuzzDecode。文件第一行写 go test fuzz v1,后续每行按 fuzz 参数顺序写一个值。不要把任意原始文本直接改名塞进目录,否则测试框架无法按语料格式解码。
失败日志怎样指向首次失败输入
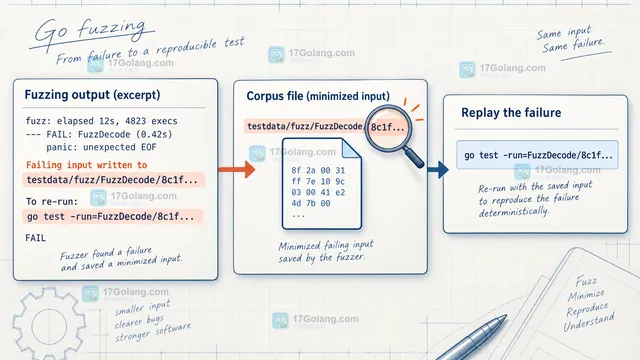
启动 fuzz 后,日志可能先报告最小化,再给出类似下面的重放路径:
Failing input written to testdata/fuzz/FuzzDecode/8c1f...
To re-run:
go test -run=FuzzDecode/8c1f...
这里的 FuzzDecode 是 fuzz 测试名,后面的 hash 是该语料的标识。先执行这条命令,而不是继续使用 -fuzz,可以把变量范围收窄到一个输入。然后打开同名文件,核对它是否包含多个参数,以及文件中的字符串、整数或字节值是否与目标函数签名一致。
“首次失败”不一定等于日志里最早出现的随机样本。引擎会尝试最小化,最终留下的是仍能触发失败的较小语料;真正的排查入口是最终的 hash、语料文件和测试日志三者。若单独重放时不再失败,优先检查测试是否依赖全局状态、时间、网络或并发顺序,这些都会破坏 fuzz 目标的确定性。
修复后如何让失败语料成为回归测试
定位到输入后,先保留语料文件,再修复被触发的代码。修复完成运行不带 -fuzz 的 go test,它会重新执行所有种子,包括刚刚保存的失败样本;通过后再用有限的 -fuzztime 做补充探索。
| 现象 | 优先检查 |
|---|---|
| 普通 go test 仍失败 | 先读语料文件,再按 hash 单独重放 |
| 单独重放结果不稳定 | 排查全局变量、随机数、时间和外部依赖 |
| 语料无法解析 | 检查 fuzz v1 头部、值的数量和参数类型顺序 |
不要为了让流水线变绿而删除失败样本。只有确认它代表误报或测试契约已被有意修改时,才应在代码审查中说明删除理由。
常见问题
f.Add 的种子会和目录语料重复吗?
可能重复。它们都属于种子集合,重复样本不会带来新的覆盖价值,应该保留更容易读懂、维护位置更明确的一份。
为什么 go test -run=FuzzDecode 不能只跑一个失败输入?
这个写法通常会匹配该 fuzz 测试下的多个子测试。要精确定位,应使用日志给出的 FuzzDecode/hash 完整子名称。
什么时候应该继续跑 -fuzz?
当失败输入已经被修复、普通种子测试通过,并且目标函数具备确定性时,再用有限的 -fuzztime 扩大探索范围。
 MySQL CHECK 约束写入非法值时为什么没有报错
- 上一篇
- MySQL CHECK 约束写入非法值时为什么没有报错
- 下一篇
- Redis COPY 复制键时 replace 选项会覆盖什么
-
- Golang · Go问答 | 20分钟前 | 依赖管理 · go · Go Modules · replace go.work Go mod edit modfile
- Go mod edit -replace 如何只在本地开发生效
- 122浏览 收藏
-
- Golang · Go问答 | 30分钟前 |
- Go work use 加入本地模块后 CI 为什么找不到目录
- 386浏览 收藏
-
- Golang · Go问答 | 50分钟前 |
- Go pprof.Do 标签在并发请求中如何避免串到其他 goroutine
- 111浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go pprof.StartCPUProfile 停止太晚会造成什么影响
- 259浏览 收藏
-
- Golang · Go问答 | 1小时前 | pprof · Go问答 · Go性能分析 · 运行时剖面 · Go调试 · go tool pprof Go pprof.Lookup Go运行时剖面导出 pprof.WriteTo Go heap剖面
- Go pprof.Lookup 如何导出指定名称的运行时剖面
- 141浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go runtime.SetFinalizer 遇到引用环时为什么不执行
- 189浏览 收藏
-
- Golang · Go问答 | 1小时前 | go · runtime · Go runtime.KeepAlive finalizer 外部句柄
- Go runtime.KeepAlive 与 finalizer 如何配合外部句柄
- 464浏览 收藏
-
- Golang · Go问答 | 1小时前 | 容器 · 性能排查 · Go问答 · 运行时 · go GOMAXPROCS 容器 CPU 配额 runtime.NumCPU cgroup cpu.max Kubernetes CPU limit
- Go GOMAXPROCS 与容器 CPU 配额不一致时怎么观察
- 360浏览 收藏
-
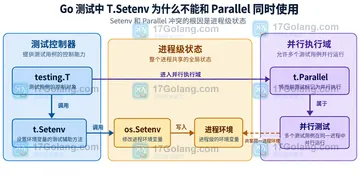
- Golang · Go问答 | 2小时前 | Parallel · 测试隔离 · Go测试 · testing.T · Setenv · Go testing.T.Setenv Go并行测试 Go t.Parallel Go环境变量测试
- Go testing.T.Setenv 为什么不能和 Parallel 同时使用
- 470浏览 收藏
-
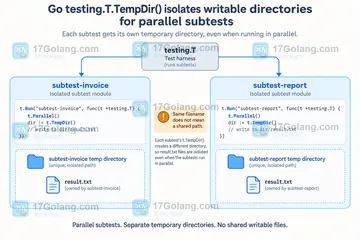
- Golang · Go问答 | 2小时前 | Go测试 · 文件隔离 · 并行测试 · testing.T · 临时目录 · Go testing.T.TempDir Go并行子测试 Go测试临时目录 Go t.Parallel
- Go testing.T.TempDir 在并行子测试中如何隔离目录
- 375浏览 收藏
-
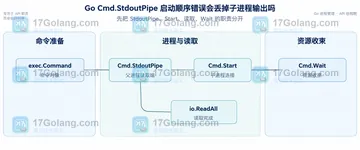
- Golang · Go问答 | 2小时前 |
- Go Cmd.StdoutPipe 启动顺序错误会丢掉子进程输出吗
- 293浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 22次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 125次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 50次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 20次使用
-

- OpenCompass
- OpenCompass是上海AI实验室推出的开源大模型评测平台,提供CompassKit、CompassHub和CompassRank三大核心组件,支持LLM及多模态模型的一站式标准化评估与排行榜查询。
- 71次使用
-
- 用Nginx反向代理部署go写的网站。
- 2023-01-17 502浏览
-
- GoLand调式动态执行代码
- 2023-01-13 502浏览
-
- Go select 用 time.After 做超时有什么资源代价
- 2026-09-10 501浏览
-
- Go 取 range 变量地址为什么得到重复指针
- 2026-09-07 501浏览
-
- Go net.Conn 写入超时为何仍会卡住:SetWriteDeadline、部分写入与连接复用检查
- 2026-08-30 501浏览


