
Go flag.FlagSet.Parse 如何区分未知参数与参数值:ContinueOnError、Usage 输出与退出控制
给 Go 命令增加子命令后,最容易混淆的是“参数名不存在”和“参数名存在但值不合法”。把 flag.FlagSet.Parse 放进 ContinueOnError 模式,再根据返回的错误和 Args 分流,既能保留调用方控制权,也能避免测试时被 os.Exit 打断。
实用判断是:未知参数、缺少参数值、
-h都先交给Parse和Usage,业务代码只处理成功解析后的字段与剩余参数。
要点速览
ContinueOnError会返回解析错误,不会替调用方退出进程。Usage负责展示用法,错误类型仍应由Parse的返回值判断。Args保存第一个非 flag 参数及其后续内容,适合承接子命令参数。
先把三类输入放到同一个 FlagSet
假设命令只接受 -format 和 -verbose 两个选项,其他内容作为要处理的文件名。不要直接使用包级 flag.Parse,因为它默认绑定全局命令行;子命令或单元测试更适合独立的 FlagSet。
package main

import (
    "flag"
    "fmt"
    "io"
    "os"
)

func parseArgs(args []string, out io.Writer) error {
    fs := flag.NewFlagSet("convert", flag.ContinueOnError)
    fs.SetOutput(out)
    format := fs.String("format", "json", "output format")
    verbose := fs.Bool("verbose", false, "print details")

    if err := fs.Parse(args); err != nil {
        return err
    }
    fmt.Fprintf(out, "format=%s verbose=%t files=%v\n", *format, *verbose, fs.Args())
    return nil
}

func main() {
    if err := parseArgs(os.Args[1:], os.Stderr); err != nil {
        os.Exit(2)
    }
}
这里的关键不是把错误吞掉,而是让 FlagSet 完成输入校验后,把决定权交回调用方。SetOutput 还能把用法和错误写进测试缓冲区,不必污染标准错误。
Parse 返回错误时,先区分未知参数和缺少值
ContinueOnError 的价值在于 Parse 返回错误,进程仍然留在当前函数里。比如 -unknown 会得到“flag provided but not defined”一类错误;-format 后没有值时,则是缺少参数值。两者都不应继续进入文件处理逻辑。
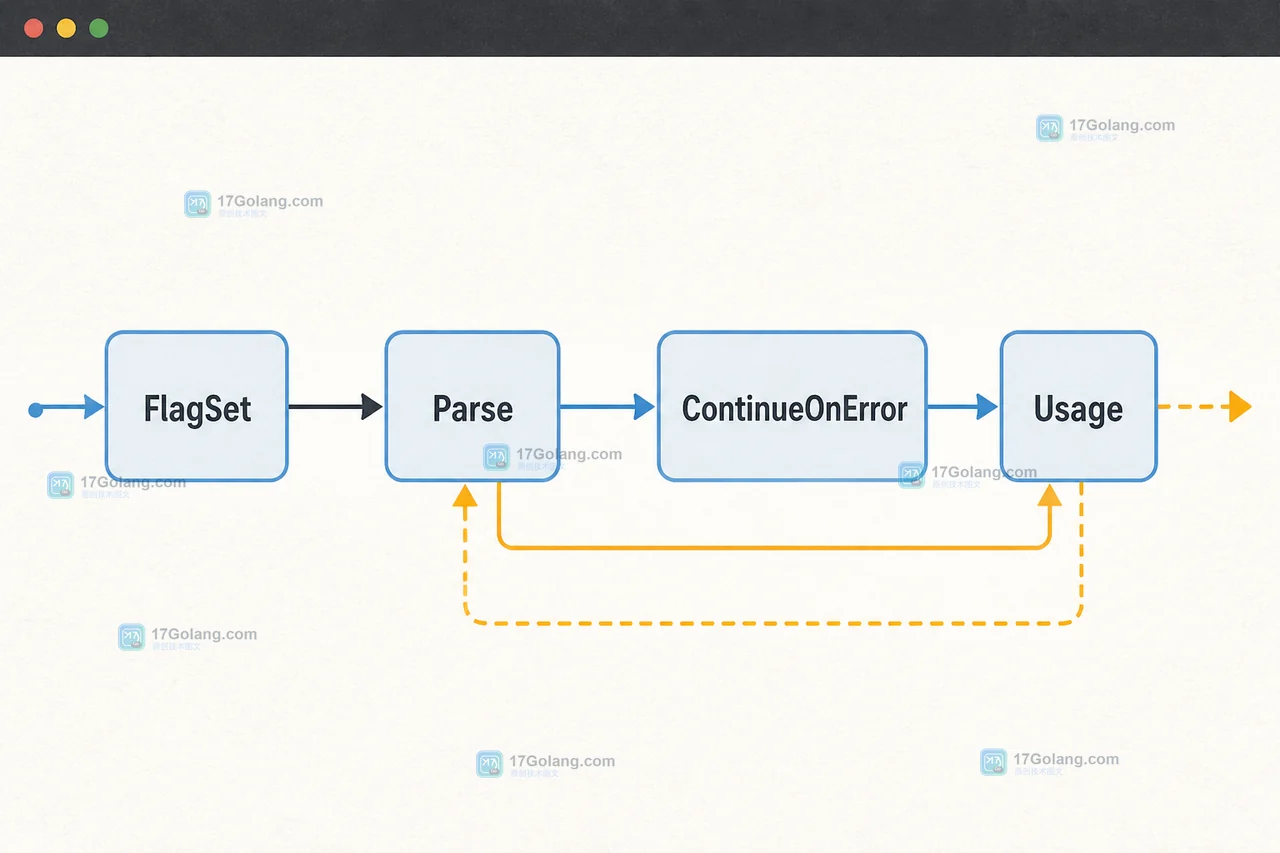
图片中的 FlagSet、Parse、ContinueOnError 与 Usage 对应上面的代码和标准库行为:先由 Parse 读取参数,错误时调用 Usage,再将错误返回给调用方;成功时才会继续读取指针字段。
func parse(args []string) (string, error) {
    var output bytes.Buffer
    fs := flag.NewFlagSet("convert", flag.ContinueOnError)
    fs.SetOutput(&output)
    fs.String("format", "json", "output format")
    fs.Usage = func() {
        fmt.Fprintln(&output, "usage: convert [options] file...")
    }
    if err := fs.Parse(args); err != nil {
        return output.String(), err
    }
    return output.String(), nil
}
需要自定义提示时改写 Usage 即可,不要在 Usage 里再次调用 Parse。解析失败后直接返回,调用方可以把错误映射成测试断言、CLI 返回码或上层提示。
-h 为什么不是普通的未知参数错误
当用户传入 -h 或 -help 时,标准 FlagSet 会展示用法并返回 flag.ErrHelp。这条分支通常表示用户主动请求帮助,不宜和配置错误显示同样的“失败”提示。
err := fs.Parse(args)
switch {
case err == nil:
    // 使用已经解析的字段。
case errors.Is(err, flag.ErrHelp):
    // Usage 已经输出,调用方按帮助路径结束。
default:
    // 未知参数、缺少值或值解析失败。
}
如果采用 ExitOnError,普通解析错误会直接结束进程;库代码和测试代码一般不应把这种退出策略硬编码进去。让外层程序决定退出码,复用性更好。
Args 如何承接文件名和子命令参数
Parse 遇到第一个非 flag 参数后,会把它以及后面的参数放入 fs.Args()。因此下面的输入中,report.csv 不会被当成未知选项,而是作为业务参数保留下来。
args := []string{"-format", "csv", "report.csv", "backup.csv"}
if err := fs.Parse(args); err != nil {
    return err
}
files := fs.Args()
// files: [report.csv backup.csv]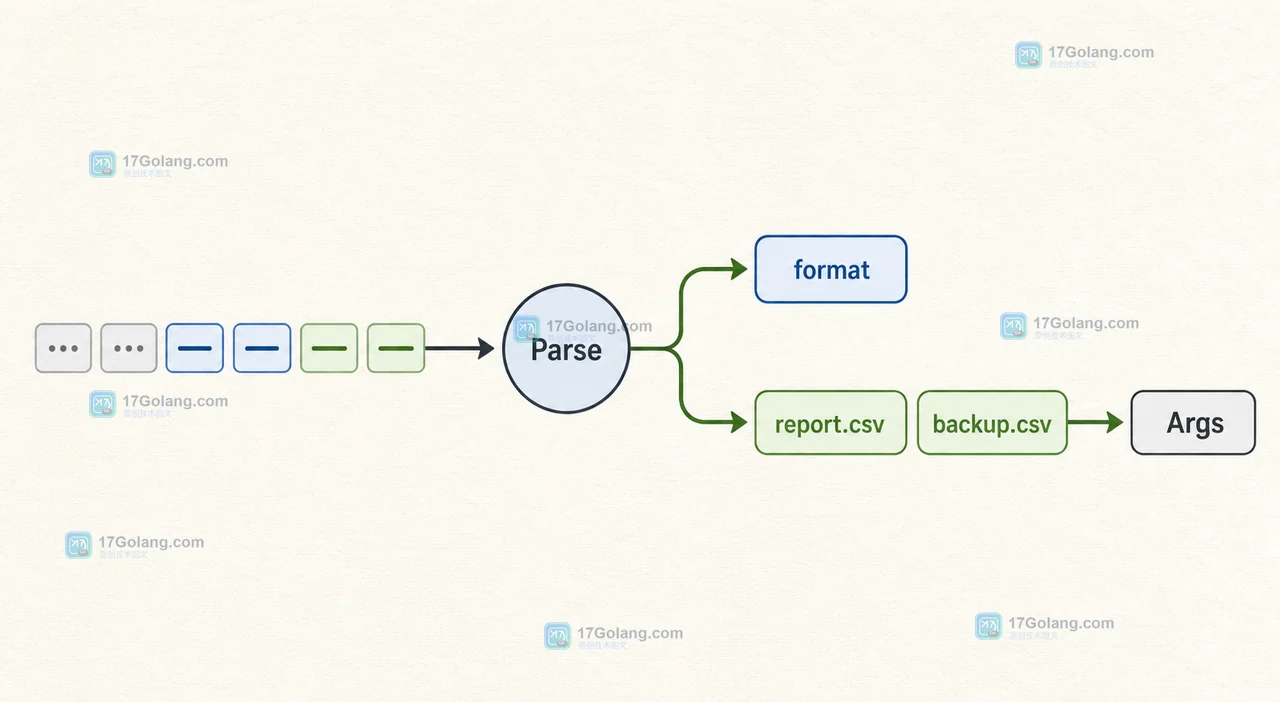
第二张图只表达一个数据路径:输入参数进入 Parse 后,format 进入已定义 flag,report.csv 和 backup.csv 进入 Args。这样图片解释的是正文中的真实数据流,不是泛化的命令行海报。
如果命令必须至少接收一个文件,校验应放在解析成功之后:
if len(fs.Args()) == 0 {
    return errors.New("missing input file")
}
不要把“没有文件”误判成 Parse 错误。flag 语法正确但业务参数不完整,是另一层校验。
测试时把输出和错误一起验收
测试可以传入一组固定参数,观察返回错误、用法输出和字段结果。最少覆盖三条路径:未知参数返回错误、-h 返回 flag.ErrHelp、合法参数留下预期的 Args。
func TestParseArgs(t *testing.T) {
    var out bytes.Buffer
    err := parseArgs([]string{"-unknown"}, &out)
    if err == nil || !strings.Contains(err.Error(), "not defined") {
        t.Fatalf("unexpected error: %v", err)
    }
    if !strings.Contains(out.String(), "usage") {
        t.Fatalf("usage not written: %q", out.String())
    }
}
常见问题:FlagSet.Parse 的边界怎么记
为什么不直接用 ExitOnError?
命令行最外层可以使用它,但可复用函数、子命令分发器和测试更需要拿到错误后自行决定下一步,通常选择 ContinueOnError。
Usage 输出后还要自己再打印一次吗?
一般不需要。解析失败时 Usage 会参与输出;调用方只需根据返回错误选择返回码或提示,避免同一段用法重复出现。
如何判断文件名是否缺失?
先确认 Parse 返回 nil,再检查 len(fs.Args())。flag 语法错误和业务参数不足是两个独立状态。
收尾检查
独立的 FlagSet 让参数边界变得可测试:ContinueOnError 保留控制权,Usage 统一提示,Args 接住剩余参数。把这三处职责分开,未知参数和业务校验就不会互相遮掩。
 Go regexp.Regexp.FindReaderIndex 如何定位流式文本匹配:字节区间、UTF-8 边界与读取策略
- 上一篇
- Go regexp.Regexp.FindReaderIndex 如何定位流式文本匹配:字节区间、UTF-8 边界与读取策略
- 下一篇
- RAG 检索结果为什么会被长文档淹没:分块元数据、重排阈值与上下文裁剪
-
- Golang · Go问答 | 4小时前 |
- Go plugin 在不同构建环境为何无法加载
- 418浏览 收藏
-
- Golang · Go问答 | 4小时前 |
- Go 交叉编译时找不到系统库怎么办
- 445浏览 收藏
-
- Golang · Go问答 | 4小时前 |
- Go json/v2 迁移时怎样评估兼容风险
- 384浏览 收藏
-
- Golang · Go问答 | 4小时前 | 测试 · go · Go 循环变量 go.mod t.Parallel loopvar
- Go 旧版循环变量语义升级后测试为何变化
- 266浏览 收藏
-
- Golang · Go问答 | 4小时前 |
- Go 旧版 ioutil 代码怎样迁移到 os 和 io
- 151浏览 收藏
-
- Golang · Go问答 | 4小时前 |
- Go toolchain 自动下载失败如何固定本地版本
- 103浏览 收藏
-
- Golang · Go问答 | 4小时前 |
- Go 二进制在 Alpine 中运行失败如何判断 libc 依赖
- 374浏览 收藏
-
- Golang · Go问答 | 4小时前 | go · 时区 · 时间处理 · 兼容性 · LoadLocation UTC ParseInLocation Go时区 time.Local 容器时区
- Go 程序时区在容器和本地为什么不同
- 272浏览 收藏
-
- Golang · Go问答 | 4小时前 |
- Go 日志在容器中为什么没有及时输出
- 243浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 467次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 530次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 549次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 498次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 317次使用
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- Golang操作命令行的几种方式总结
- 2022-12-27 426浏览
-
- Golang执行cmd命令行的方法
- 2023-01-20 412浏览
-
- golang执行命令行的实现
- 2023-01-07 109浏览
-
- go语言中的defer关键字
- 2023-02-17 150浏览