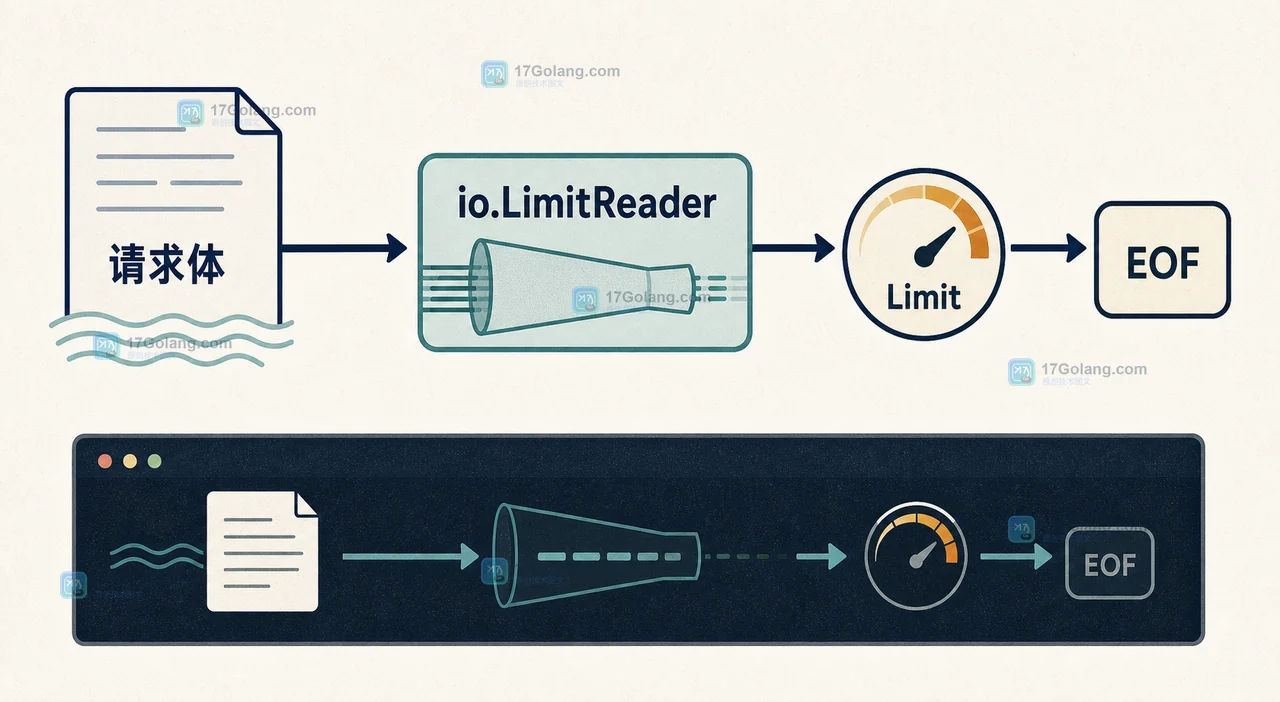
处理上传配置、Webhook 或第三方响应时,最容易被忽略的是“这次到底允许读多少字节”。直接把整个 io.Reader 交给 io.ReadAll,输入一旦失控,内存和后续解析都会被动。io.LimitReader 的用法不复杂,但要把自然结束和超出上限分开判断,否则一段被截断的 JSON 也可能让排查方向跑偏。
io.LimitReader(r, Limit)最多向下游提供Limit个字节。- 读满上限后,包装器通常表现为正常
EOF;它不会主动返回“超限”错误。 - 要识别超限,应读取
Limit+1个字节或保留一个额外探测字节。 - JSON 解析成功不等于输入完整,边界判断必须先于业务落库。
先确定上限:io.LimitReader 的读取路径
io.LimitReader 接收一个底层 Reader 和整数 Limit,返回一个新的读取器。它把剩余可读量记在内部:每次读取都会扣减数量,扣到零时不再向底层索取数据。也就是说,限制发生在读取路径上,而不是 io.ReadAll 读完之后再删掉多余内容。
const Limit int64 = 1 << 20 // 1 MiB

limited := io.LimitReader(r, Limit)
body, err := io.ReadAll(limited)
if err != nil {
    return err
}
// body 最多包含 Limit 个字节
return handle(body)
这里的 Limit 是上限,不是预留内存大小,也不会改变底层 Reader 的生命周期。读取小于上限的数据时,底层读完后返回 EOF;读取达到上限时,包装器也可能在读满后以 EOF 收口。
为什么读到 EOF 还不能证明没有超限
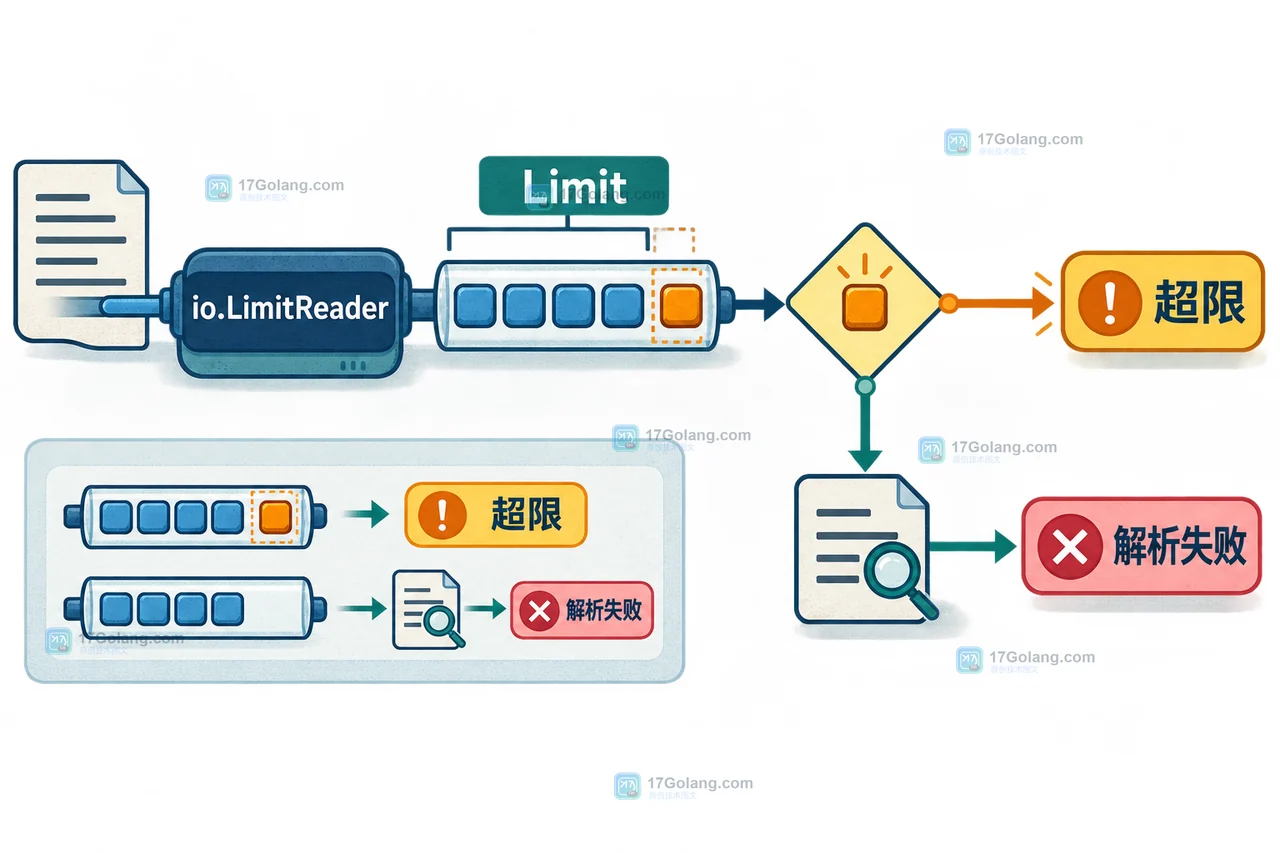
这是 io.LimitReader 最容易误判的地方:它的职责是截断读取,不是报告“原始输入超过上限”。如果原始数据有 2 MiB,Limit 设成 1 MiB,调用方最多仍然只能拿到 1 MiB;后续看到的可能只是一个普通的读完结果。
因此,直接这样写只能完成“最多读多少”,不能完成“判断有没有超过”:
body, err := io.ReadAll(io.LimitReader(r, Limit))
if err != nil {
    return err
}
// body == Limit 字节时,仍无法仅凭 err 判断输入是否更长
若业务需要拒绝超限请求,应该多读一个字节。这个额外字节只用来证明后面还有数据,不进入正常解析内容:
const Limit int64 = 1 << 20

probe, err := io.ReadAll(io.LimitReader(r, Limit+1))
if err != nil {
    return err
}
if int64(len(probe)) > Limit {
    return fmt.Errorf("body exceeds limit %d", Limit)
}
return decode(probe)
这个写法的关键是 Limit+1。输入刚好等于 Limit 时不会误报,输入多一个字节时才进入超限分支。生产代码还要检查整数溢出:如果上限来自配置,先保证它为正且不会在加一时越过 int64 最大值。
超限不能只看解析是否成功
截断后的内容可能恰好落在一个看似完整的边界上,也可能只是让解析器返回错误。把“解析成功”当成“输入没有超限”会把资源保护和业务校验混在一起。先做长度判定,再做 JSON、表单或自定义协议解析,判断会稳定很多。
| 现象 | 更可靠的判断 | 处理 |
|---|---|---|
| 读取量小于 Limit | 底层自然结束,出现 EOF | 允许进入解析 |
| 读取量等于 Limit | 仅凭 EOF 无法判断是否还有后续数据 | 使用 Limit+1 探测 |
| 读取量大于 Limit | Limit+1 次探测拿到额外字节,标记超限 | 拒绝或丢弃,不落库 |
| 内容不完整 | 长度未超限但解析返回错误 | 按协议错误处理 |
把读取上限放在响应体保护的第一层
对于 HTTP 响应,限制应尽量靠近响应体入口。读取上限只解决内存和输入边界问题,状态码、Content-Type、超时和取消仍要单独处理。不要因为用了 io.LimitReader 就省略 defer resp.Body.Close()。
resp, err := client.Do(req)
if err != nil {
    return err
}
defer resp.Body.Close()

if resp.StatusCode != http.StatusOK {
    return fmt.Errorf("unexpected status: %s", resp.Status)
}

const Limit int64 = 256 << 10
body, err := io.ReadAll(io.LimitReader(resp.Body, Limit+1))
if err != nil {
    return err
}
if int64(len(body)) > Limit {
    return fmt.Errorf("response body exceeds limit")
}
return decode(body)
这里的顺序有三个检查点:先保证请求已经成功返回,再限制响应体读取量,最后才交给解码函数。若服务端返回错误页或重定向内容,应该在状态和类型检查阶段退出,避免把错误页面当成业务 JSON。
几个常见边界,别在复查时漏掉
Limit 设为零会怎样?
零表示包装器不再提供数据。若业务允许空内容,先明确这是合法输入;若不允许,应在配置校验阶段拒绝零值,而不是等解析器报错。
io.LimitReader 会关闭底层 Reader 吗?
不会。它只是一个读取包装器,不负责关闭底层对象。文件、请求体和响应体仍由创建它们的代码负责关闭。
只用 io.ReadAll 再检查 len 可以吗?
不适合不可信输入。那样可能已经把超大内容读进内存;应先通过 io.LimitReader 限制读取,并用 Limit+1 做超限探测。
解析失败就代表超限吗?
不是。解析失败可能来自截断、格式错误或协议不匹配。超限必须由额外探测字节或协议层明确错误来确认。
常见问题
io.LimitReader 能直接返回超限错误吗?
不能。它只限制最多能读出的字节数;需要识别超限时,应读取 Limit+1 个字节并检查长度。
读取刚好等于 Limit 时应该拒绝吗?
不能仅凭长度等于 Limit 就拒绝,因为输入可能刚好到达上限。只有额外探测到第 Limit+1 个字节,才能确认超限。
io.LimitReader 适合替代所有请求体校验吗?
不适合。它只负责读取量,状态码、内容类型、超时、取消和业务字段仍要由 HTTP 与业务层分别校验。
一张检查清单收尾
- 上限是否为正数,
Limit+1是否存在溢出风险? - 是否把
Limit和Limit+1的语义分开? - 是否先做超限判断,再做 JSON 或业务解析?
- 底层文件或响应体是否仍然由调用方关闭?
- 是否为小于、等于、大于上限三种长度写了测试?
 diagrams.net 怎么把流程图导出为 PNG:页面尺寸、透明背景与下载核对