
Go 泛型约束怎么写:用类型集合限制可比较与可排序类型
给一个函数加上泛型后,最容易遇到的不是尖括号怎么写,而是“这个类型到底允许做什么”。例如键要放进 map,约束必须允许比较;排序函数则需要允许小于号。把参数写成 any 只能让函数更宽,却不能让编译器替你证明这些操作合法。
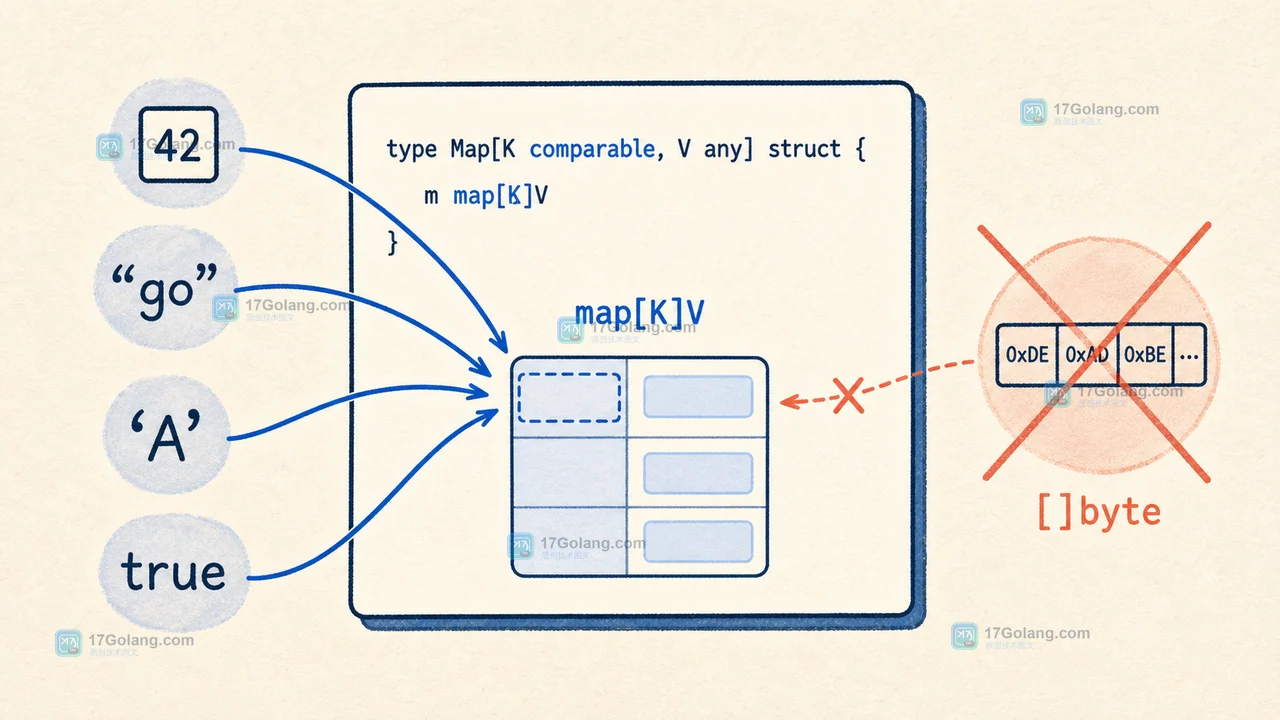
Go 泛型约束用类型集合描述允许的类型。需要比较时使用
comparable,需要排序时定义包含具体类型或底层类型的接口,并用~保留命名类型的兼容性。
comparable适合 map 键和相等判断,但不代表可以使用小于号。- 类型集合中的
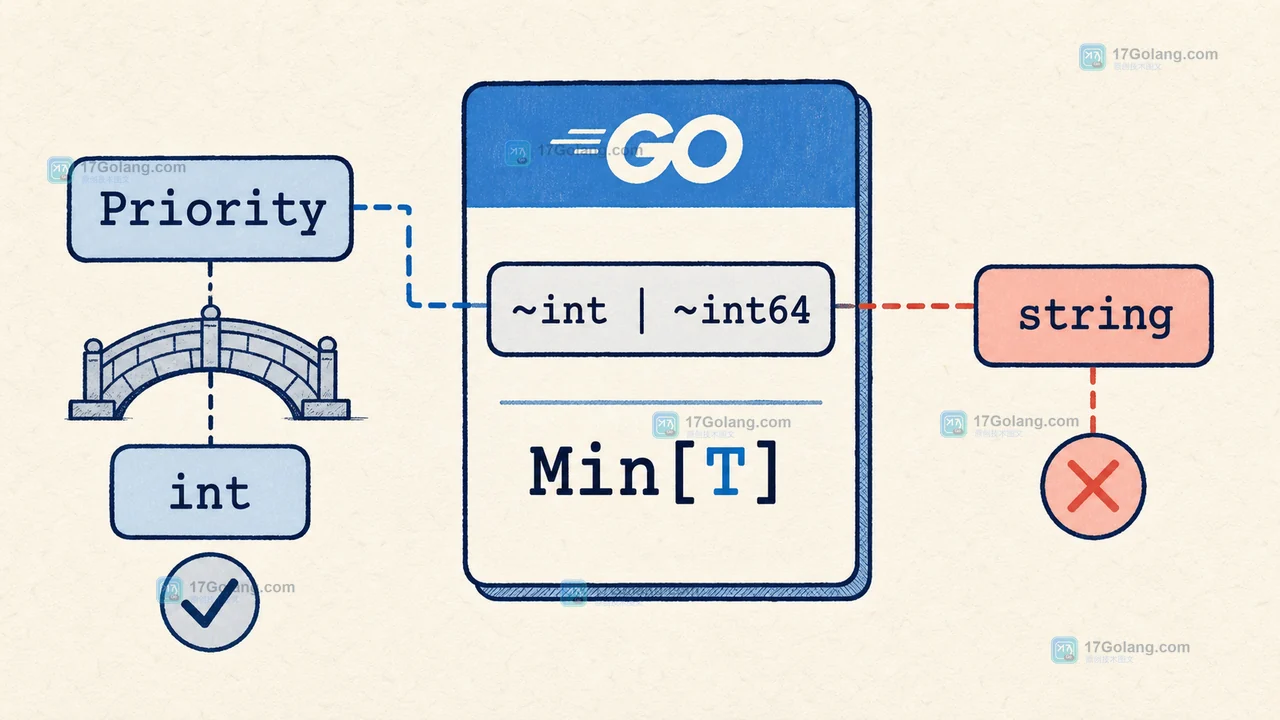
int | int64只接收列出的类型,~int还允许底层类型为int的命名类型。 - 约束越贴近函数真正需要的操作,错误越早暴露,调用方也更容易读懂。
从“能传进来”到“允许做什么”
假设订单服务要按整数键写入缓存。下面的函数看起来很通用,但 any 没有承诺键可以比较,稍微增加一个相等判断就会在编译阶段报错。
func HasKey[K any, V any](m map[K]V, key K) bool {
    _, ok := m[key]
    return ok
}
把键改成 comparable 后,约束表达的就是 map 键需要满足的能力:
func HasKey[K comparable, V any](m map[K]V, key K) bool {
    _, ok := m[key]
    return ok
}这里的边界很重要:comparable 解决的是相等比较和 map 键合法性,不是“所有比较运算都可用”。切片、函数和包含它们的结构体不能作为这样的键。
类型集合怎样表达排序范围
Go 标准库没有把所有数值类型统一封装成一个名为“可排序”的内置约束。如果你写泛型函数时要用到小于号做比较操作,完全可以在自己的项目包里声明对应的类型集合来做限制:
type OrderedInt interface {
    ~int | ~int8 | ~int16 | ~int32 | ~int64
}

func Min[T OrderedInt](a, b T) T {
if a 竖线表示并集,约束允许集合中的任意一种类型。这里的波浪号不是装饰:~int 匹配底层类型为 int 的命名类型,而不只匹配预声明类型 int。
命名类型为什么需要波浪号
业务代码通常不会直接把所有数字都叫 int。例如订单优先级可能有自己的类型名:
type Priority int

var p Priority = 3
// Min(p, Priority(5)) 可以匹配 ~int
// 如果约束写成 int,则 Priority 不能作为实参
命名类型仍然保留自己的语义和方法,但底层类型是 int。因此,数值算法通常使用 ~int 这一类约束;只有确实要限制为预声明类型时,才写成不带波浪号的具体类型集合。
约束太宽或太窄时怎么判断
| 需求 | 推荐约束 | 要注意的边界 |
|---|---|---|
| 作为 map 键 | comparable | 不能因此推断支持 排序 |
| 只接收内置整数 | int | int64 | 命名类型不会自动匹配 |
| 接受整数命名类型 | ~int | ~int64 | 底层类型必须对应 |
| 只需保存或转发值 | any | 不要为了“通用”凭空增加操作承诺 |
判断方法很朴素:先写函数体,再看函数体实际使用了哪些操作。如果只存取值,就保留 any;如果需要相等判断,收紧到 comparable;如果需要排序,明确列出支持的底层类型。不要先设计一个覆盖所有类型的“大而全”接口。
编译器报错时先看哪一层
泛型调用失败时,先确认实参的静态类型,再检查约束是否包含它。常见问题是把 type Score int 传给只写了 int 的集合,或者把 string 传给只允许数值的排序函数。
type Score int

func Max[T ~int | ~int64](a, b T) T {
    if a > b {
        return a
    }
    return b
}

func main() {
    fmt.Println(Max(Score(7), Score(4)))
}
如果约束改成 int | int64,上面的调用就不再成立。这个错误不是类型推断“失灵”,而是约束准确地拒绝了未声明的类型范围。
常见误区与验收清单
- 把
comparable当成可排序约束:需要时必须声明支持的类型集合。 - 忘记命名类型:面向业务类型的数值函数通常应优先考虑
~。 - 集合覆盖过宽:浮点数、字符串和整数的排序语义不同,不要为了省事混成一个无边界约束。
- 只看能否编译:还要为命名类型、空集合边界和错误实参各写一个小测试。
相关问题
comparable 能约束切片吗?
不能。切片不能直接做相等比较,也不能作为 map 的键;如果业务需要判断切片内容,应显式选择比较函数或标准库提供的切片比较方式。
为什么约束接口不能像普通接口一样直接声明变量?
包含类型集合的接口主要用于约束类型参数,不是普通运行时值的接口类型。把它当作变量类型会得到编译错误。
所有整数都应该放进一个约束吗?
不一定。若函数要处理无符号溢出或浮点精度,最好按算法语义拆分约束,让调用者知道函数接受哪些值。
小结
泛型约束的价值不在于把函数签名写得复杂,而在于把操作前提写在类型层。先从函数体需要的操作出发,再决定使用 any、comparable 还是带 ~ 的类型集合,通常就能得到既能复用、又不会放宽过头的 Go 代码。
 雨后竹林微光手机壁纸怎么留出锁屏时间区:青绿色主图与雾气变体提示词
- 上一篇
- 雨后竹林微光手机壁纸怎么留出锁屏时间区:青绿色主图与雾气变体提示词
- 下一篇
- Go channel 关闭后如何安全判断:comma-ok、range 与并发发送边界
-
- Golang · Go教程 | 36分钟前 |
- slog 自定义 Handler 怎样批量提交结构化日志
- 240浏览 收藏
-
- Golang · Go教程 | 1小时前 | go · 错误排查 · 错误日志 Go slog HandlerOptions AddSource 调用位置
- 用 slog HandlerOptions 为错误日志补充调用位置
- 465浏览 收藏
-
- Golang · Go教程 | 1小时前 | go ·
- log/slog 如何为一次请求绑定嵌套属性组
- 311浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- slices.Chunk 分组后如何避免保留多余底层数组
- 276浏览 收藏
-
- Golang · Go教程 | 2小时前 |
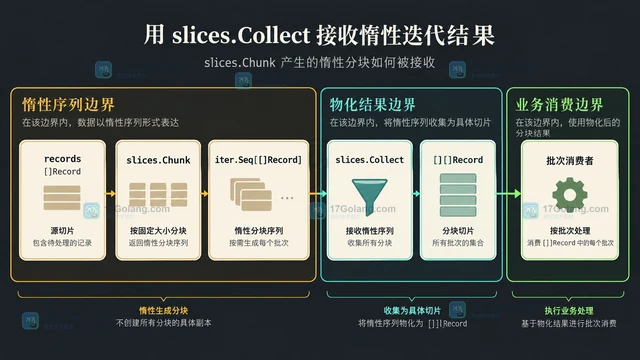
- 用 slices.Collect 接收惰性迭代结果
- 144浏览 收藏
-
- Golang · Go教程 | 2小时前 | 迭代器 · Go教程 · 批处理 · 批量写入 iter.Seq Go slices.Chunk 切片分组
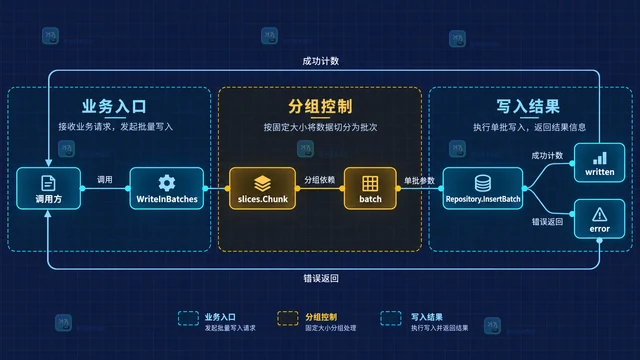
- slices.Chunk 如何把批量写入拆成固定大小分组
- 229浏览 收藏
-
- Golang · Go教程 | 2小时前 | 迭代器 · Go教程 · iter.Seq slices.Sorted Go maps.Keys 稳定键顺序
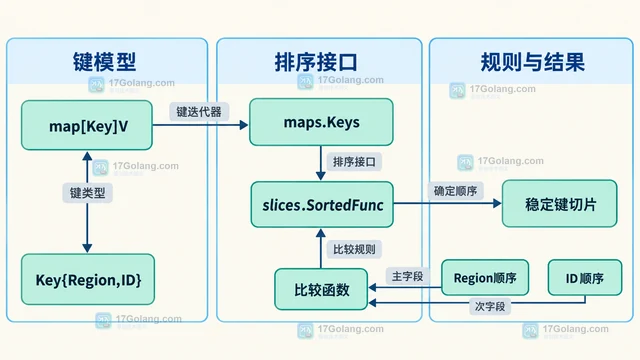
- maps.Keys 与 slices.Sorted 怎样输出稳定键顺序
- 294浏览 收藏
-
- Golang · Go教程 | 3小时前 |
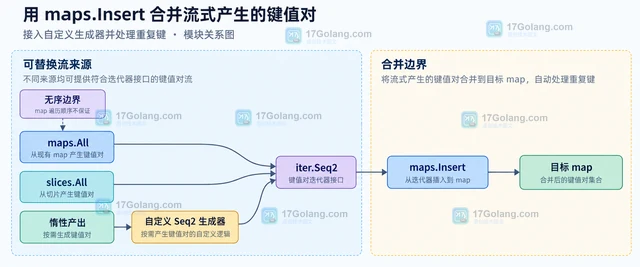
- 用 maps.Insert 合并流式产生的键值对
- 387浏览 收藏
-
- Golang · Go教程 | 3小时前 | 迭代器 · Go教程 · Go迭代器 iter.Seq2 Go maps.Collect map去重
- maps.Collect 如何从迭代器重建去重字典
- 406浏览 收藏
-
- Golang · Go教程 | 3小时前 | go · 迭代器 ·
- 怎样把推送式回调适配成 Go 迭代器
- 417浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 390次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 470次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 477次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 421次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 245次使用
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- go语言中的defer关键字
- 2023-02-17 150浏览
-
- Go泛型实战教程之如何在结构体中使用泛型
- 2023-02-24 234浏览
-
- 关于go-zero单体服务使用泛型简化注册Handler路由的问题
- 2022-12-30 346浏览
-
- Go1.18新特性工作区模糊测试及泛型的使用详解
- 2022-12-30 131浏览


