
Redis GEOSEARCHSTORE 怎么核验距离过滤:COUNT、排序与结果集合边界
线上“附近门店”接口偶尔会把上一轮查询的门店带出来,排查后发现问题不在 GEOSEARCH,而在把结果写入固定集合时没有处理旧成员。Redis 的 GEOSEARCHSTORE 适合把一次距离查询固化成新集合,但要同时看清半径单位、COUNT 截断、排序方向和目标集合的生命周期。
把源 GEO 集合作为空间索引,把目标集合当作一次查询快照;每次写入前先清理或换唯一 key,再用 WITHDIST 回读验证结果,才能确认筛选真的生效。
- 用
BYRADIUS时,半径后面的单位直接影响结果范围。 COUNT 3 ASC是“按距离升序取前三个”,不是先取三条再排序。- 目标集合不会自动替你表达查询批次,固定 key 必须主动清理或带批次号。
GEOSEARCHSTORE 解决的不是“查附近”本身
假设门店坐标都在 store:geo,接口需要把某个用户位置 5 千米内的候选门店暂存到 store:nearby:ready,后续还要交给库存服务继续过滤。直接用 GEOSEARCH 可以返回列表,但结果只存在响应里;使用 GEOSEARCHSTORE 后,Redis 会把结果成员写进目标有序集合,便于继续读取或交给下一步流程。
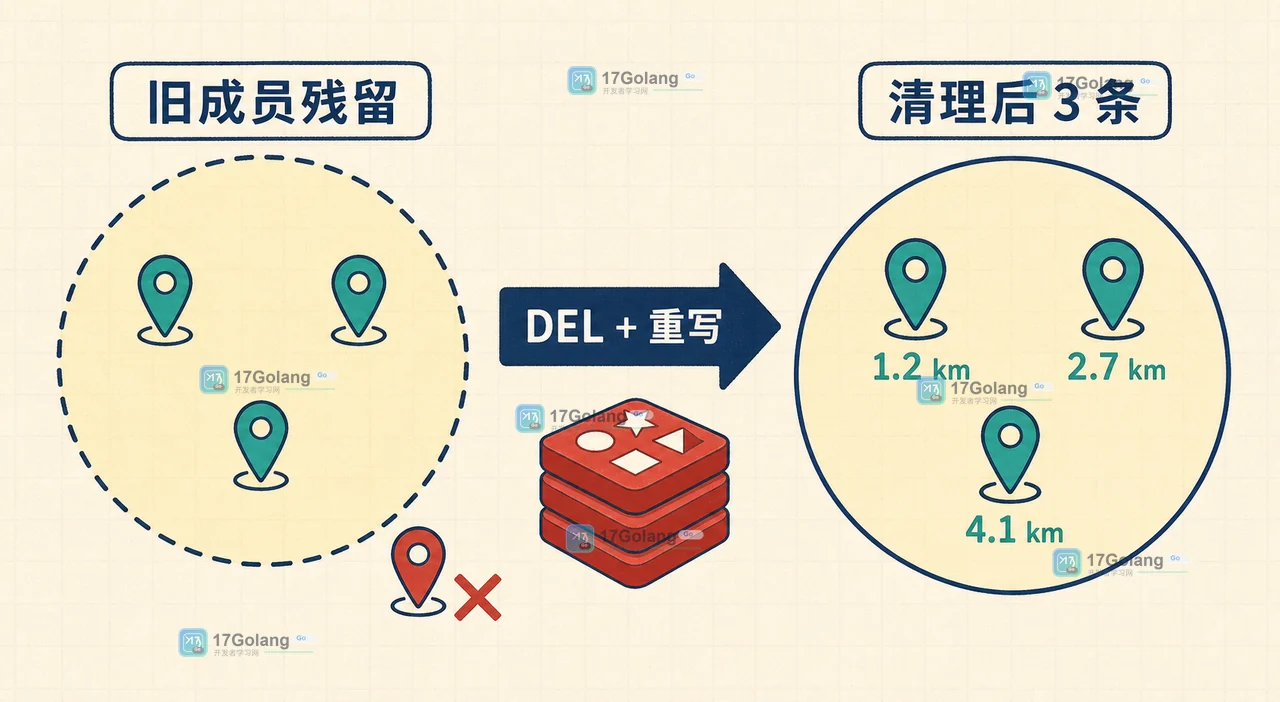
这里有个容易忽略的取舍:目标 key 是查询结果容器,不是永久索引。相同目标 key 再写一遍时,如果本轮结果比上一轮少,旧成员可能继续留在集合里,接口于是看起来像“距离过滤失效”。
先准备一组能看出边界的坐标
不要拿全部门店都挤在同一条街上测试。下面四个成员故意安排成近、中、远三档,其中 store:d 在半径外,方便检查数量和范围:
redis-cli GEOADD store:geo 116.3974 39.9093 store:a \
  116.4050 39.9140 store:b \
  116.4200 39.9100 store:c \
  116.4700 39.9300 store:d

redis-cli GEOPOS store:geo store:a store:b store:c store:d
测试时先用 GEOPOS 确认写入顺序和坐标没有颠倒。经度、纬度写反时,命令可能仍然成功,但距离结果会完全偏离预期。
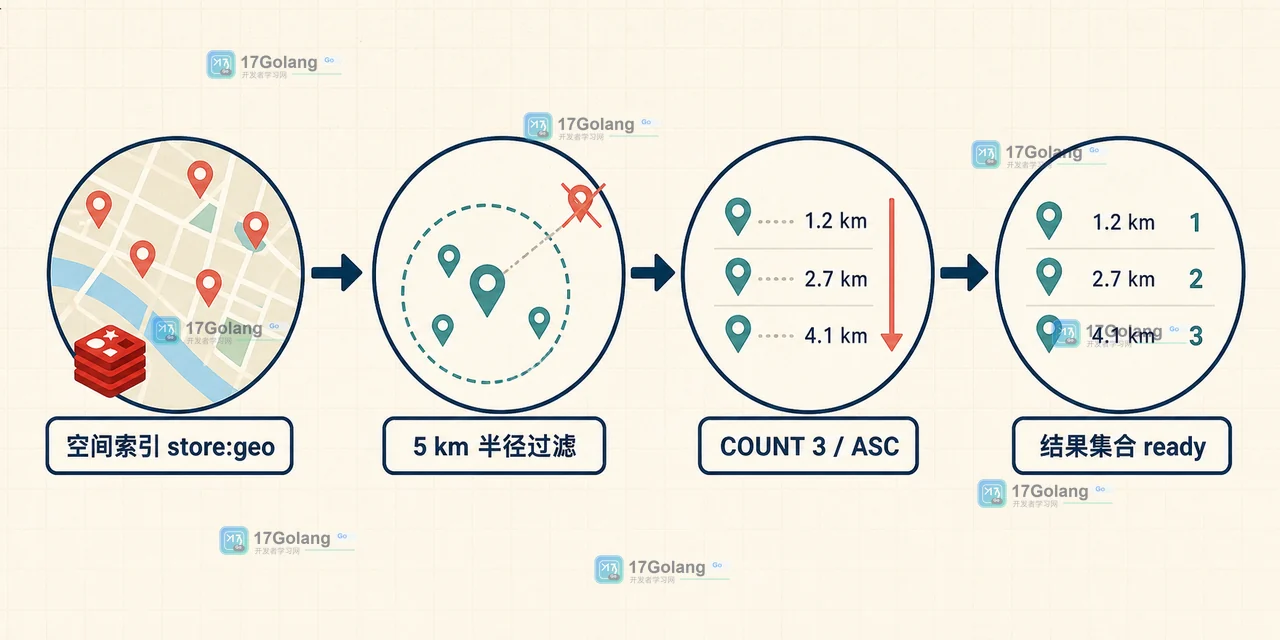
用 BYRADIUS、COUNT 和排序锁定查询语义
下面这条命令以天安门附近的坐标为中心,搜索 5 千米内的成员,按距离从近到远取前三条,并把结果写到新的集合:
redis-cli DEL store:nearby:ready
redis-cli GEOSEARCHSTORE store:nearby:ready store:geo \
  FROMLONLAT 116.3974 39.9093 \
  BYRADIUS 5 km \
  ASC COUNT 3

redis-cli ZRANGE store:nearby:ready 0 -1 WITHSCORES
目标集合仍然是有序集合,分值是 Redis 计算出的距离分值。若业务要把距离返回给调用方,直接在查询阶段加 STOREDIST,或者对源集合使用 WITHDIST 做对照读取,别把有序集合分值当成未经确认的业务字段。
COUNT 截断和旧成员要分别验收
COUNT 3 ASC 的验收至少看三个量:返回成员数不超过 3、每个成员都在 5 km 内、结果顺序没有逆转。可以在命令行把集合读出来,再用一个更宽的只读查询做交叉检查:
redis-cli ZCARD store:nearby:ready
redis-cli ZRANGE store:nearby:ready 0 -1 WITHSCORES
redis-cli GEOSEARCH store:geo FROMLONLAT 116.3974 39.9093 \
  BYRADIUS 5 km ASC WITHDIST
第二个验收点是目标 key 的残留。先写入一个明显不可能命中的旧成员,再执行一轮窄半径查询。如果它仍出现在目标集合,说明“覆盖结果”没有等价于“清空集合”。生产代码可以在写入前 DEL,也可以按请求生成带过期时间的批次 key;不要让多个请求共同覆盖一个固定 key。
兼容处理:先确认 Redis 版本和结果保存策略
GEOSEARCHSTORE 属于较新的 GEO 查询命令。部署前在目标环境执行 INFO server 检查版本,并在同一连接参数下做一次小数据验证。若服务仍处于旧版本,不能只把命令替换成相似拼写;应改为读取 GEOSEARCH 结果后由应用写入临时集合,并补上清理与过期策略。
当结果集合只服务一个请求时,推荐使用请求 ID 作为 key,并设置合理 TTL;当结果需要跨请求复用,则应把查询参数、生成时间和数据版本一起记录。这样距离范围变化时,缓存不会把旧快照误当成新结果。
常见问题
GEOSEARCHSTORE 会自动删除目标集合中的旧成员吗?
不要依赖自动删除语义。固定目标 key 复用前主动删除,或者使用带批次标识的 key 并设置过期时间。
为什么 COUNT 3 返回的结果看起来不是最近的三个?
检查排序参数是否写成 ASC COUNT 3,并确认读取目标集合时使用了正确的范围和分值。还要排除坐标顺序写反。
能不能直接把目标集合当作附近门店缓存?
可以,但必须定义失效策略、查询参数和数据版本。没有 TTL 或批次隔离的固定 key,很容易把上一次请求的成员带入本次结果。
总结
Redis GEOSEARCHSTORE 的关键不只是“能否搜到附近成员”,而是把空间查询转成可复核的结果集合。用坐标样本验证半径,用 COUNT 和 ASC 验证截断与顺序,再单独检查旧成员残留,最后为目标 key 设计清理、TTL 或批次隔离策略,附近搜索才算真正验收完成。
 纸艺昆虫科普海报怎么画:中英文完整提示词、改词方法与竖版变体
- 上一篇
- 纸艺昆虫科普海报怎么画:中英文完整提示词、改词方法与竖版变体
- 下一篇
- Node.js 26 测试随机化怎么落地:固定种子、顺序依赖与失败复现
-
- 数据库 · Redis | 55分钟前 | Redis · 高可用 · Redis Functions FUNCTION LOAD FCALL 主从切换
- Redis Functions 如何在主从切换后保持脚本可用
- 154浏览 收藏
-
- 数据库 · Redis | 3小时前 | Redis · 缓存设计 · HEXPIRE Hash字段过期 Redis Hash HSETEX
- Redis Hash 字段过期适合哪些数据模型
- 462浏览 收藏
-
- 数据库 · Redis | 6小时前 | Redis · redis 缓存失效 CLIENT TRACKING BCAST 客户端缓存
- Redis 客户端缓存如何用广播模式减少失效消息
- 484浏览 收藏
-
- 数据库 · Redis | 10小时前 |
- Cluster 哈希槽迁移期间客户端请求会发生什么
- 397浏览 收藏
-
- 数据库 · Redis | 15小时前 | Redis · 缓存 · 运维 · redis 缓存 maxmemory-policy 内存淘汰
- 内存淘汰策略怎么选:先区分缓存库与持久数据
- 309浏览 收藏
-
- 数据库 · Redis | 17小时前 |
- 缓存穿透治理:空值、布隆过滤器与回源限流组合
- 105浏览 收藏
-
- 数据库 · Redis | 19小时前 |
- 热点 Key 不扩容也能缓解吗:拆分、复制与本地缓存
- 397浏览 收藏
-
- 数据库 · Redis | 1天前 |
- 分布式锁续期失败后还能继续工作吗:租约与围栏令牌
- 333浏览 收藏
-
- 数据库 · Redis | 1天前 | Redis · 消息订阅 消费者组 XREADGROUP XACK Redis Streams Redis Pub/Sub
- Pub/Sub 与 Streams 不只是是否持久化:订阅模型怎么选
- 220浏览 收藏
-
- 数据库 · Redis | 1天前 | 高并发 · Redis限流 滑动窗口限流 Redis Functions FUNCTION LOAD FCALL
- 用 Redis Functions 封装滑动窗口限流:部署、版本与回滚
- 468浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 385次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 462次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 473次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 410次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 237次使用
-
- Redis Stream XTRIM 如何避免消费组积压无限增长
- 2026-09-12 501浏览
-
- Redis AOF rewrite 期间如何判断磁盘与内存压力
- 2026-09-12 501浏览
-
- Redis RDB 和 AOF 怎么按可接受数据丢失量选择
- 2026-09-08 501浏览
-
- Redis XAUTOCLAIM 之后为什么仍有 pending:JUSTID、PEL 与消息删除边界
- 2026-08-29 501浏览
-
- Redis SET 的 GET 与 KEEPTTL 怎么一起验收:旧值返回、续期与回滚边界
- 2026-08-20 501浏览


