
如何在 Telegram Bot 中可靠识别无用户名的用户并建立唯一联系机制
本文详解在 Telegram Bot 开发中,当用户未设置用户名时,如何通过 chat_id、手机号、邮箱等多级 fallback 策略实现用户唯一标识与可追溯联系,兼顾合规性与实用性。

本文详解在 Telegram Bot 开发中,当用户未设置用户名时,如何通过 chat_id、手机号、邮箱等多级 fallback 策略实现用户唯一标识与可追溯联系,兼顾合规性与实用性。
在 Telegram Bot 开发场景里(比如使用 Telegraf.js),username 本来就不是必填项,很多用户会选择不公开,或者干脆留空。这样一来,若把联系链路建立在 @username 之上(例如 t.me/username),稳定性就很难保证。也正因为如此,必须搭建一套更稳妥的用户识别与触达机制,确保订单、客服、后台管理等关键业务环节,都能准确找到并联系到真实用户。
核心原则:chat_id 是唯一且必需的锚点
Telegram 平台为每个用户与 Bot 的会话分配唯一的 chat.id(即 ctx.chat.id 或 ctx.from.id),该 ID 全局唯一、稳定不变,且无需用户授权即可获取。它应作为数据库记录的主键(Primary Key)或索引字段:
// 示例:Telegraf.js 中存储用户基础信息
bot.on('message', async (ctx) => {
const userId = ctx.from.id;// 用户唯一 ID(非 chat.id!注意区分)
const chatId = ctx.chat.id;// 当前对话 ID(私聊场景下通常等于 userId)
const username = ctx.from.username || null;

await db.users.upsert({
where: { telegram_id: userId },
update: { username, last_active: new Date() },
create: {
telegram_id: userId,
chat_id: chatId,
username,
created_at: new Date()
}
});
});
⚠️ 需要特别留意:像 https://t.me/123456789 这样的链接其实是无效的——因为 Telegram 并不支持基于 chat_id 直接生成可点击的 deep link。t.me/ 这类链接能识别的,只有 username,或者 bot?start=xxx 这一类参数。也正因为如此,chat_id 不能拿来做前端跳转,但在后端依然必须作为唯一标识。
可选增强:引导用户提供可联系信息(按优先级降序)
| 方式 | 实现方式 | 合规性 | 可靠性 | 备注 |
|---|---|---|---|---|
| 手机号(用户主动授权) | 使用 ReplyKeyboardMarkup 发送 request_contact: true 按钮,触发 Contact 请求 | ✅ 需用户显式授权,符合 GDPR/Telegram Policy | ⚠️ 用户可拒授,且仅限私聊 | 最新文档 |
| 邮箱地址 | 通过文字输入引导用户发送邮箱(需校验格式) | ✅ 无权限限制 | ⚠️ 依赖用户配合,存在伪造风险 | 建议搭配验证码或二次确认 |
| 自定义 ID(如订单号+用户ID哈希) | 后台生成唯一短码(如 ORD-7X9K),关联 telegram_id | ✅ 完全可控 | ✅ 100% 可用 | 适用于客服人工核对场景 |
示例:请求手机号的键盘配置(Telegraf.js):
const { Markup } = require('telegraf');

bot.command('contact', (ctx) => {
ctx.reply('请分享您的手机号以便我们及时联系您:',
Markup.keyboard([
['? 发送手机号']
]).oneTime().resize().requestContact('? 发送手机号')
);
});

bot.on('contact', async (ctx) => {
const phone = ctx.message.contact.phone_number;
await db.users.update({
where: { telegram_id: ctx.from.id },
data: { phone }
});
ctx.reply('✅ 手机号已保存,我们将尽快与您联系!');
});
关键注意事项与最佳实践
- 绝不尝试“绕过限制”:Telegram 明确禁止通过
forwardMessage、getUserProfilePhotos等接口反向推导隐私信息。此类操作不仅无效,还可能导致 Bot 被限流或封禁。 - 明确告知用户数据用途:在请求手机号/邮箱前,必须用清晰文案说明用途(如“仅用于订单通知与售后联系”),符合《Telegram Bot Platform Terms》第 4.2 条。
- 设计降级流程:在数据库 schema 中为
username、phone、email字段设为NULLABLE,并定义默认 fallback 逻辑(例如:有手机号 → 发信息;无手机号但有邮箱 → 发邮件;全无 → 后台标记“需人工确认”,由客服通过 Telegram 私聊触达)。 - 安全存储敏感信息:手机号/邮箱须加密存储(推荐 AES-256 或使用托管服务如 AWS KMS),避免明文落库。
综上,解决无用户名用户的识别问题,本质是构建「以 telegram_id 为基石、多通道补充验证、用户授权优先」的分层策略。技术上简单,成败关键在于产品设计——用友好的交互降低用户授权门槛,并在后台建立健壮的数据关联与触达回路。
 TypeScript 泛型条件返回类型:实现参数驱动的精准类型推导
- 上一篇
- TypeScript 泛型条件返回类型:实现参数驱动的精准类型推导

- 下一篇
- 如何判断字符串是否以数字开头:JavaScript 实用检测方法
-
- 文章 · 前端 | 3小时前 |
- CSS :has() 怎么控制选择范围避免匹配成本过高
- 210浏览 收藏
-
- 文章 · 前端 | 5小时前 |
- Web Locks API 怎么避免多个标签页重复执行任务
- 348浏览 收藏
-
- 文章 · 前端 | 7小时前 |
- Fetch 流式上传为什么需要 duplex 选项
- 270浏览 收藏
-
- 文章 · 前端 | 9小时前 | 前端 · javascript · 异步编程 · JavaScript Promise.all Array.fromAsync 异步可迭代对象 AsyncIterable for await of
- JavaScript Array.fromAsync 怎么收集异步可迭代对象
- 236浏览 收藏
-
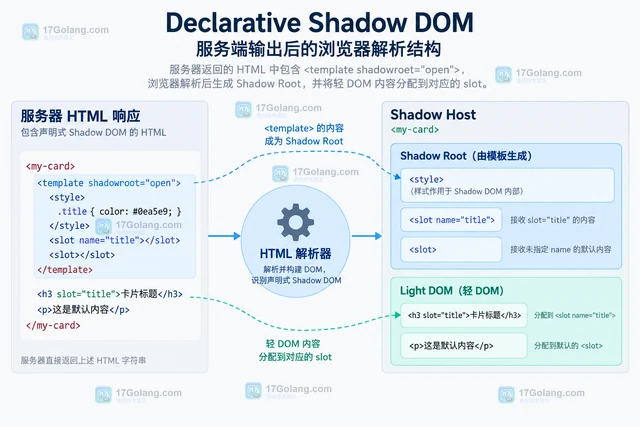
- 文章 · 前端 | 12小时前 | html · 前端 · javascript · slot Web Components 服务端渲染 Declarative Shadow DOM shadowrootmode Shadow Root
- Declarative Shadow DOM 怎么服务端输出组件结构
- 227浏览 收藏
-
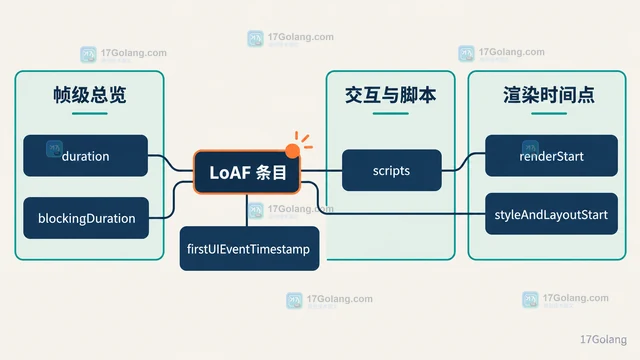
- 文章 · 前端 | 15小时前 | 前端 · 性能监控 · javascript · 前端性能 PerformanceObserver INP Long Animation Frames API LoAF 卡顿脚本
- Long Animation Frames API 怎么定位卡顿脚本
- 463浏览 收藏
-
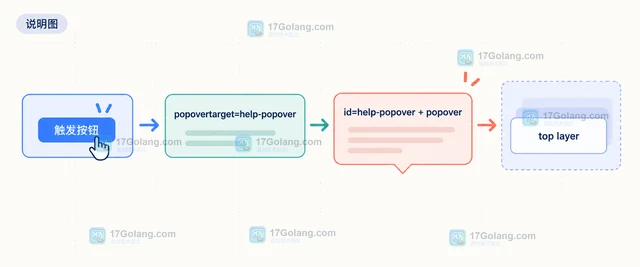
- 文章 · 前端 | 17小时前 | html · javascript · css · html Popover API popovertarget 前端弹层
- HTML Popover API 怎么实现轻量弹层
- 444浏览 收藏
-
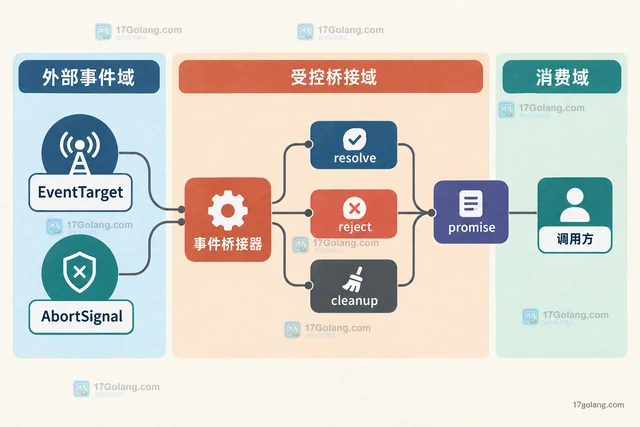
- 文章 · 前端 | 19小时前 | websocket · javascript · 异步编程 · JavaScript websocket AbortSignal 异步迭代器 Promise.withResolvers EventTarget
- JavaScript Promise.withResolvers 适合哪些事件桥接场景
- 431浏览 收藏
-
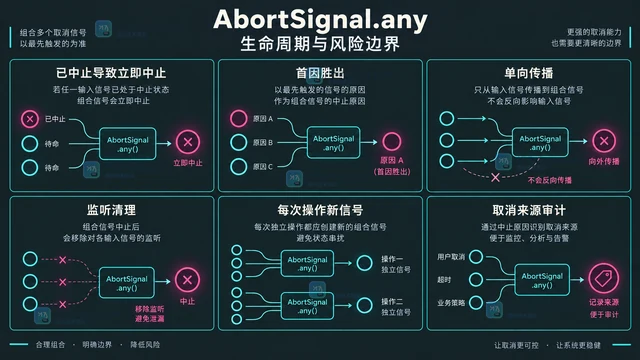
- 文章 · 前端 | 21小时前 | javascript · JavaScript Fetch AbortController 取消请求 AbortSignal.any AbortSignal.timeout
- JavaScript AbortSignal.any 怎么组合多个取消来源
- 174浏览 收藏
-
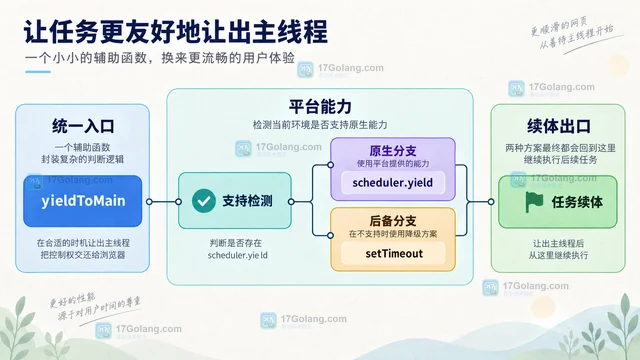
- 文章 · 前端 | 1天前 |
- JavaScript scheduler.yield 怎么让长任务主动让出主线程
- 255浏览 收藏
-
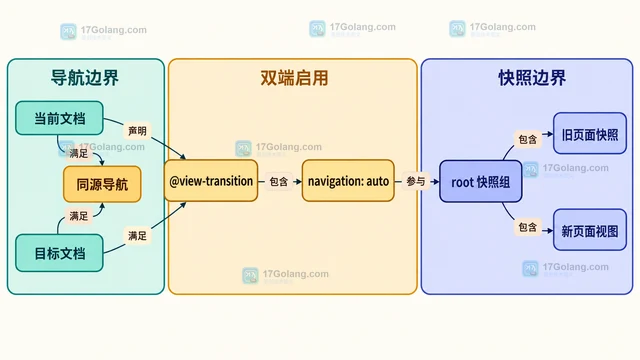
- 文章 · 前端 | 1天前 |
- View Transition API 怎么给跨文档导航添加过渡
- 181浏览 收藏
-
- 文章 · 前端 | 1天前 | css · CSS 自定义属性 container query
- CSS Style Container Query 怎么按自定义属性切换样式
- 440浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 336次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 394次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 388次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 353次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 176次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


