
Linux conntrack 表满怎么排查:nf_conntrack_count 与 max 的安全处理
网关突然出现新连接偶发失败,应用日志却没有明显异常时,先别急着把连接数上限一口气调大。Linux 的 Netfilter 连接跟踪表如果接近 nf_conntrack_max,最有价值的证据通常就在 /proc/sys/net/netfilter/ 和内核日志里。先把当前条目数、上限、增长速度和连接类型对齐,再决定是短连接洪峰、超时过长,还是确实需要扩容。
连接跟踪表满的排查核心是先采数留证、小步调整,优先定位连接暴涨根因,不要上来就盲目调大最大条目数,避免引发内核内存溢出。
nf_conntrack_count看当前已分配的连接跟踪条目,不能把它当成可写参数。nf_conntrack_max到顶时,调大上限只能争取缓冲时间,不能替代流量和超时治理。- 先留存 count、max、内存和协议分布,再做小幅调整;修改后必须观察增长斜率和新连接错误是否同时下降。
- 涉及 NAT、防火墙或容器网络时,要在真正承载流量的网络命名空间和节点上复核。
Linux conntrack 表满时先确认三个信号
连接跟踪表记录的是经过状态跟踪的流,不等同于某个应用的 TCP 连接数。NAT 网关、容器节点、边界防火墙上的短连接业务,往往比普通应用主机更容易遇到这个上限。
sysctl net.netfilter.nf_conntrack_count
sysctl net.netfilter.nf_conntrack_max
cat /proc/sys/net/netfilter/nf_conntrack_count
cat /proc/sys/net/netfilter/nf_conntrack_max
dmesg -T | grep -i 'conntrack\|table full'
重点看三件事:当前 count 是否长期贴近 max;count 是否在故障窗口快速上升;内核日志是否出现连接跟踪表满或丢弃新流的提示。一次采样只能说明“现在有多少”,连续采样才足以判断是否仍在爬升。

count、max 和 buckets 分别解决什么问题
这三个名字很容易被混用。nf_conntrack_count 是只读的当前条目数;nf_conntrack_max 是允许的最大条目数;nf_conntrack_buckets 是哈希表桶数量,影响查找链长度和内存布局。它们不是三个可以随意一起调大的“性能开关”。
| 参数或证据 | 含义 | 排查动作 |
|---|---|---|
nf_conntrack_count | 当前已经分配的流条目 | 连续采样,计算峰值和增长速度 |
nf_conntrack_max | 连接跟踪表允许的最大条目 | 与 count 做比例比较,记录修改前值 |
nf_conntrack_buckets | 哈希表桶数量 | 确认内核版本和网络命名空间,再评估内存代价 |
conntrack -S | 用户态统计视角 | 观察 insert、drop、early_drop 等计数变化 |
当前内核文档还特别说明,连接跟踪条目会按原方向和回复方向加入表中,所以不能用“业务连接数乘一个固定经验值”反推真实占用。最稳妥的基线仍是目标节点自己的 count、协议状态和历史峰值。
用 conntrack 统计找出增长来源
如果机器安装了 conntrack-tools,可以先读取摘要,不要一上来导出完整表:
conntrack -S
conntrack -L -p tcp --state SYN_SENT,SYN_RECV 2>/dev/null | head
conntrack -L -p udp 2>/dev/null | head
这里的目标不是统计某个命令的输出行数,而是确认增长更像 TCP 半连接、UDP 短流,还是大量 NAT 会话。若业务是容器节点,再把宿主机的 conntrack 计数与容器入口、出口流量一起看;只在容器内执行命令,可能看不到初始网络命名空间里的完整表。
对短时间故障可以每 10 秒留一组快照:
for i in 1 2 3 4 5 6; do
  date '+%F %T'
  cat /proc/sys/net/netfilter/nf_conntrack_count
  cat /proc/sys/net/netfilter/nf_conntrack_max
  sleep 10
done
若 count 在请求量下降后仍不回落,优先检查 TCP/UDP 超时、异常重试和下游不可达,而不是继续扩大 max。连接条目留存时间过长,调大上限只会把压力推迟到内存和网络栈。
安全处理:先留证,再做小幅 sysctl 调整
确认表确实逼近上限、且节点还有足够内存时,可以临时把 nf_conntrack_max 调到一个经过容量评估的值。下面的数字只是演示写法,不是通用推荐值:
old_max=$(cat /proc/sys/net/netfilter/nf_conntrack_max)
echo "old_max=$old_max"
sysctl -w net.netfilter.nf_conntrack_max=262144
sysctl net.netfilter.nf_conntrack_count
sysctl net.netfilter.nf_conntrack_max
修改前应记录可用内存、count 峰值、流量峰值和应用错误率;修改后观察至少一个业务峰值窗口。不要把 nf_conntrack_count 写回去,也不要在没有内存评估时直接把 max 改成很大的整数。连接跟踪条目会消耗内核内存,过度扩容可能把问题变成内存回收或 OOM。
如果只是临时救火,确认业务恢复后可以回到原值:
sysctl -w net.netfilter.nf_conntrack_max="$old_max"
sysctl net.netfilter.nf_conntrack_count
若要持久化,使用发行版已有的 sysctl 配置管理方式,并在变更记录中写清节点范围、回滚值和复测结果。不要只改一台机器后假设整个集群都已生效。

别把调大 max 当成根因修复
连接跟踪表满通常只是最后一个症状。常见根因包括客户端重试风暴、下游黑洞导致连接迟迟不结束、UDP 会话超时偏长、NAT 出口端口或中间设备容量不足,以及某个发布版本制造了异常连接模式。
- 应用重试:对照请求量、重试次数和错误率,检查是否存在无退避重试。
- TCP 半连接:结合
SYN-SENT、SYN-RECV和下游健康状态判断,不要只看总 count。 - UDP 短流:核对
nf_conntrack_udp_timeout与业务协议的真实生命周期,不能为追求快速回收而破坏正常会话。 - 容器网络:确认 kube-proxy、CNI、NAT 规则与宿主机内核参数的生效位置。
根因还没收敛时,优先做限流、降低无效重试、修复下游可达性和分散 NAT 压力。参数调整应当是给业务争取恢复窗口,而不是跳过这些动作。
复测和告警应该盯哪些结果
一次成功的处理至少要留下四类结果:count/max 比例回到安全区间;conntrack 丢弃或 early_drop 不再持续增长;应用新连接错误率下降;节点内存没有因为扩容出现异常回收。建议把 count/max 比例、insert/drop、节点可用内存和新连接错误率放在同一个时间轴上。
告警不要只设“count 大于某个固定数字”。不同节点的 max、业务峰值和连接生命周期不同,更适合使用比例加持续时间,例如连续数分钟超过 70% 触发观察,超过 85% 且 drop 增长时升级处理。阈值最终要用自己的峰值数据校准。
常见问题
nf_conntrack_count 能直接修改吗?
不能。它是当前已分配条目的只读统计,应通过流量、超时和连接生命周期治理来让它回落。
把 nf_conntrack_max 调大后一定能恢复吗?
不一定。只有节点内存和哈希表容量允许、问题确实是上限过低时才可能缓解;如果连接持续泄漏或重试风暴仍在,表还会再次填满。
为什么容器里看到的 count 和宿主机不一样?
连接跟踪参数和统计可能受网络命名空间影响。涉及 NAT 或节点级防火墙时,应在承载规则的初始网络命名空间复核。
修改 sysctl 后要不要重启机器?
临时写入通常立即生效;持久化配置需要由系统启动或配置管理流程加载。无论哪种方式,都要用实际业务流量和内核统计复测。
收尾检查清单
现场处理可以按这个顺序收口:保存 count/max 和内核日志;确认增长协议与连接状态;评估内存后小幅调整;观察 drop、错误率和 count 回落;最后修复重试、超时或 NAT 根因,并保留明确的回滚值。
 PHP 8.5 array_last() 非连续键怎么取最后值:空数组与 Polyfill 边界
- 上一篇
- PHP 8.5 array_last() 非连续键怎么取最后值:空数组与 Polyfill 边界

- 下一篇
- Redis HGETEX 怎么读并续期 Hash 字段:PERSIST、EX 与 TTL 验收
-
- 文章 · linux | 11小时前 | 日志 · Linux · systemd · journalctl ·
- Linux journalctl 如何只看某 systemd 服务本次启动日志
- 268浏览 收藏
-
- 文章 · linux | 13小时前 |
- Linux perf stat 如何只统计某个进程的硬件事件
- 185浏览 收藏
-
- 文章 · linux | 14小时前 |
- Linux xargs 处理文件名空格时为什么要配合 null 分隔
- 160浏览 收藏
-
- 文章 · linux | 15小时前 |
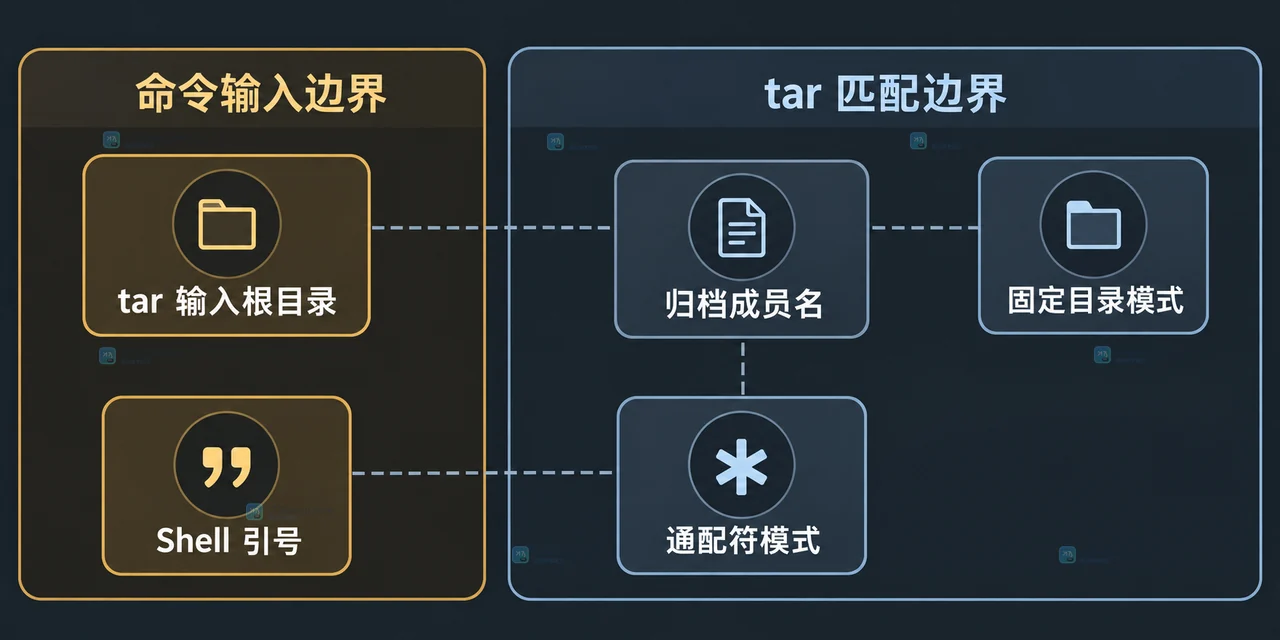
- Linux tar 排除多个目录时怎么避免通配符误匹配
- 119浏览 收藏
-
- 文章 · linux | 21小时前 | Linux · 文件系统 · 挂载 · Linux 软链接 mount namespace mount --bind
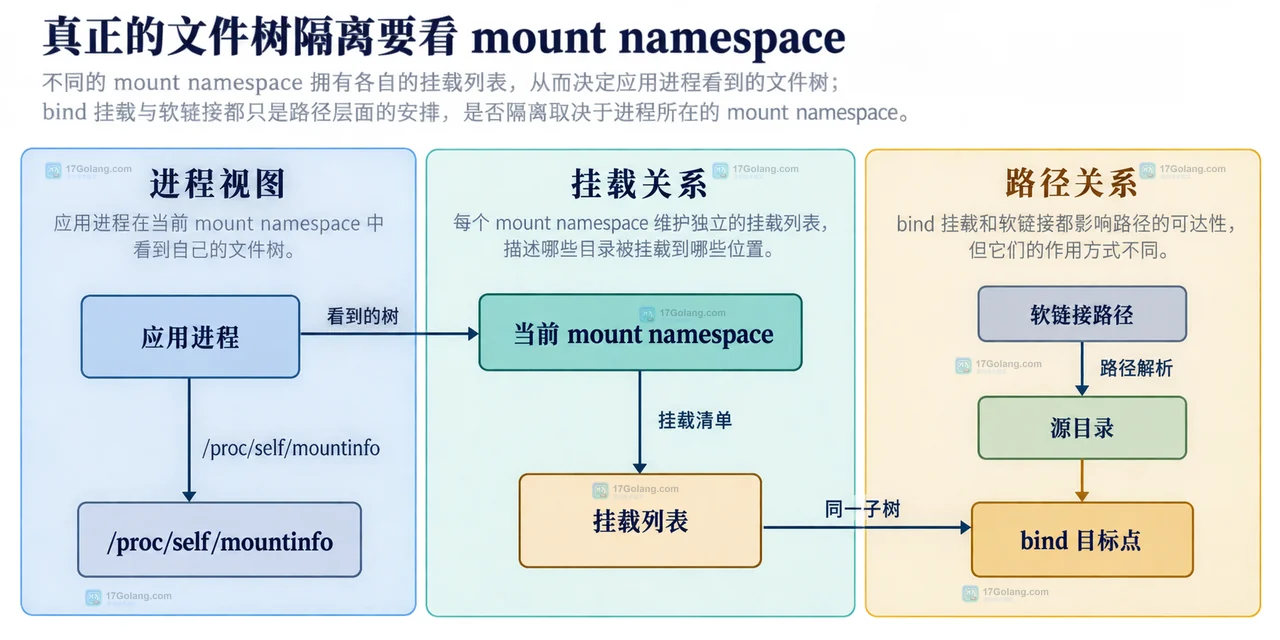
- Linux mount bind 和软链接在文件树隔离上有什么区别
- 142浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 71次使用
-
- SuperCLUE
- SuperCLUE是权威的中文大语言模型综合评测基准,涵盖语言理解、知识应用、AI Agent智能体及安全性等12项核心能力。通过多轮对话与客观测试,定期发布榜单与技术报告,为模型研发、优化及行业选型提供科学依据。
- 234次使用
-
- C-Eval
- 深入了解C-Eval中文评估套件,涵盖52个学科与4级难度。本文详解其功能特点、Zero-shot/Few-shot使用方法及代码示例,助您全面评测LLM中文理解与泛化能力。
- 155次使用
-
- AI Prompt Library
- 探索AI Prompt Library免费资源库,涵盖营销、写作及多场景AI提示词。兼容ChatGPT、Claude等工具,一键复制优化输出,提升工作效率。
- 88次使用
-
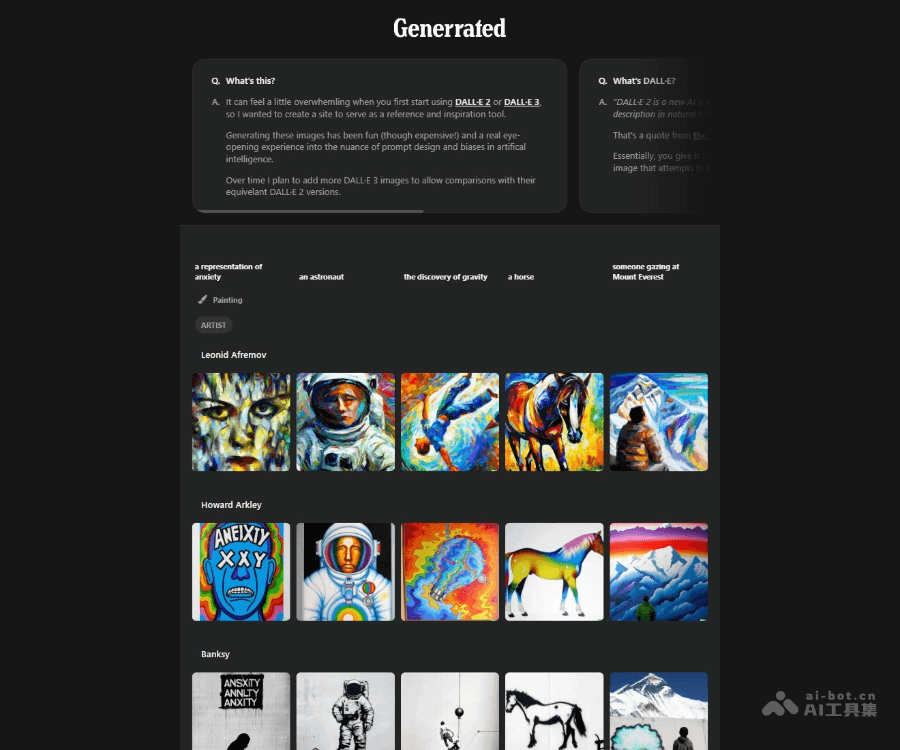
- Generrated
- Generrated汇集9300+张DALL·E生成图像及对应提示词,支持查看完整图集、对比DALL·E 2与3版本差异,是AI绘图新手学习Prompt设计与获取创作灵感的实用工具。
- 64次使用
-
- 详解golang执行Linuxshell命令完整场景下的使用方法
- 2023-01-07 426浏览
-
- go程序部署到linux上运行的实现方法
- 2023-01-02 387浏览
-
- Linux系统下Go语言开发环境搭建
- 2023-01-07 242浏览
-
- 使用golang获取linux上文件的访问/创建/修改时间
- 2022-12-31 238浏览
-
- 在Linux系统中安装Go语言的详细教程
- 2022-12-29 402浏览


