
Chrome WebMCP 要不要接入现有网站:工具接口、授权边界与失败回退
Chrome 在 Google I/O 2026 展示 WebMCP 后,很多团队第一反应是把现有 REST 接口接给浏览器里的智能体。但真正难的不是“能不能调用”,而是要不要把某个动作变成工具、调用前检查什么、失败后怎样退回人工页面。更稳妥的做法是先挑一个低风险、可撤销的查询动作,给它设计清晰的输入输出和授权边界,再用试验环境验证。
WebMCP 更像一层面向浏览器智能体的工具接口约定,不是把后端 API 批量公开的开关。先收敛动作,再控制权限和回退路径,才适合进入 origin trial。
- 优先选择查询、筛选、草稿生成等可重复且可撤销的动作。
- 工具参数要有服务端校验,不能因为来自浏览器就降低鉴权要求。
- 试验期保留原网页入口,遇到超时、拒绝或版本不兼容时回到人工流程。
WebMCP 这次变化,真正影响的是接口边界
Chrome 官方把 WebMCP 描述为一种让网站向浏览器智能体暴露结构化工具的提议方向,工具可以对应 JavaScript 函数或 HTML 表单。公开信息里还提到,实验性 origin trial 从 Chrome 149 开始,Chrome DevTools 149 已出现相关调试能力,但第三方工具和 WebMCP 调试仍不是默认开启的稳定能力。
这意味着团队现在面对的是接口设计问题,而不是一次普通的前端升级。把“查询库存”暴露成工具,和把“提交退款”暴露成工具,风险等级完全不同;前者可以重复,后者涉及金额、身份和审计。

先从一个不会改变数据的动作开始
假设电商后台有一个“查订单物流状态”的页面。页面原本通过 GET /api/orders/{id}/tracking 获取结果,用户需要登录,服务端会检查订单归属。这个动作适合做第一批试验:它有明确输入,结果可重复,调用失败时仍能回到订单页面。
工具层不应该直接复用一串模糊参数,可以把边界写得更清楚:
const tool = {
  name: "查询订单物流",
  description: "根据当前登录用户可访问的订单号查询物流节点",
  inputSchema: {
    type: "object",
    properties: { orderId: { type: "string", minLength: 8, maxLength: 32 } },
    required: ["orderId"]
  }
};
这里的 description 是给调用方理解动作的线索,不是权限声明。订单归属、登录状态、请求频率和数据脱敏都必须在服务端再次判断,不能相信浏览器传回的工具名称或参数描述。
参数、返回值和错误码要让调用方能做下一步
一个只返回“成功/失败”的工具,很快会把智能体逼回页面点击。建议把结果拆成状态、可读摘要和可继续处理的字段:
{
  "status": "in_transit",
  "summary": "包裹已到达杭州转运中心",
  "updatedAt": "2026-08-12T09:40:00+08:00",
  "nextAction": "等待下一节点",
  "traceId": "tr_7f2c"
}
错误也不要只返回 500。参数不合法、没有订单权限、物流供应商超时和工具版本不支持,分别对应不同的下一步:
| 情况 | 接口信号 | 页面回退 |
|---|---|---|
| 订单号格式错误 | 400 / invalid_order | 要求重新输入 |
| 无权访问 | 403 / forbidden | 回到订单列表 |
| 供应商超时 | 504 / provider_timeout | 保留查询条件,允许稍后重试 |
| 工具不可用 | tool_unavailable | 打开原物流页面 |

涉及写入、付款和权限变更的动作先别直接开放
“创建售后单”“修改收货地址”“发放优惠券”都不是查询动作。它们至少需要一次确认,最好拆成预览和提交两个步骤:第一次只生成待确认内容,第二次由用户在原页面明确点击后提交。这样即使调用方重复请求,也不会把一次网络重试变成两笔业务。
同样要留意幂等键、审计日志和 CSRF 防护。WebMCP 只改变调用入口,不会替你解决业务一致性;工具请求仍然要走既有身份体系、权限中间件和风控策略。
用 origin trial 做小范围验证,保留三条观测线
试验阶段可以只对内部测试账号开放一个工具,并记录工具发现、参数校验、服务端执行和页面回退四类事件。日志里至少保留工具名、账号类型、结果码、耗时、traceId 和回退原因,不要记录完整订单地址或令牌。
验收时看三个结果:调用方能否理解工具的输入输出,服务端是否在未授权时稳定拒绝,用户是否能在异常后继续完成原任务。如果只能证明“工具被调用了”,还不足以说明接口设计合格。
常见问题
WebMCP 现在适合直接用于生产提现吗?
不建议把实验性能力当成稳定生产依赖。可以先把工具契约、权限和回退页面准备好,用内部账号验证,等浏览器支持范围和规范形态更明确后再扩大。
现有 REST API 能不能直接变成 WebMCP 工具?
可以复用后端业务能力,但不要直接暴露原始 API。工具需要面向调用方重新整理名称、参数、返回值和错误模型,服务端鉴权与审计仍然照旧执行。
最适合第一个试验的动作是什么?
优先选只读、可重复、数据敏感度低且能回到原页面的动作,例如订单状态查询、知识库检索或报表筛选。
把“能调用”变成“可控地调用”
WebMCP 的价值不在于替网页增加一个神奇入口,而在于把用户任务表达成结构清晰、权限可核验、失败可恢复的工具。先做一个查询动作,给它配好输入约束、错误分流、观测字段和人工回退,再决定是否继续扩展到写入操作,这条路线更容易在试验期获得真实结论。
 Redis 8.8 Stream 怎么扛住 AI Agent 多步任务:重复消费、积压与恢复边界
- 上一篇
- Redis 8.8 Stream 怎么扛住 AI Agent 多步任务:重复消费、积压与恢复边界

- 下一篇
- Go 1.26 bytes.Buffer.Peek 怎么迁移:非消费式预览、EOF 与兼容边界
-
- 科技周边 · 业界新闻 | 47分钟前 | 云原生 · kubernetes · 云原生生态 开源可持续性 CNCF年度报告 开源项目维护 贡献者社区
- 2026 云原生生态为什么更重视开源可持续性
- 137浏览 收藏
-
- 科技周边 · 业界新闻 | 11小时前 | 云原生 · kubernetes · AI工程 · 云原生 Kubernetes AI工程 平台工程 生产级AI
- 为什么生产级 AI 系统越来越依赖云原生平台
- 146浏览 收藏
-
- 科技周边 · 业界新闻 | 13小时前 |
- CNCF 对 2026 云原生发展的判断有哪些重点
- 113浏览 收藏
-
- 科技周边 · 业界新闻 | 15小时前 | 云原生 · kubernetes · Kubernetes 云原生 AI 平台 银行 AI 基础设施 统一训练推理平台
- 银行统一 AI 训练与推理平台为什么采用云原生架构
- 369浏览 收藏
-
- 科技周边 · 业界新闻 | 17小时前 | 业界新闻 · Kubernetes 容器镜像 CNCF 云原生AI Subaru
- Subaru 云原生 AI 案例为什么把镜像分发作为重点
- 102浏览 收藏
-
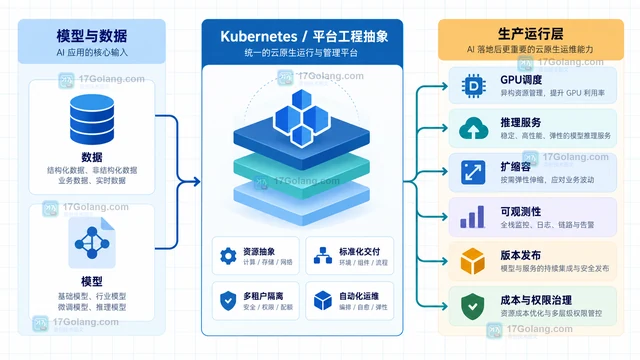
- 科技周边 · 业界新闻 | 20小时前 | 云原生 · AI基础设施 Kubernetes 平台工程 CNCF Japan State of Cloud Native Development in Japan 2026
- CNCF 日本开发者报告为何关注 AI 与云原生结合
- 439浏览 收藏
-
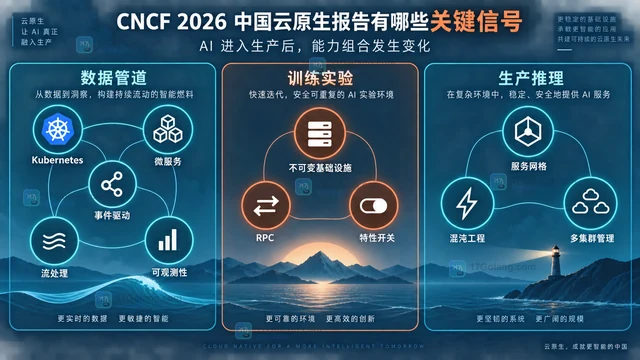
- 科技周边 · 业界新闻 | 23小时前 |
- CNCF 2026 中国云原生报告有哪些关键信号
- 213浏览 收藏
-
- 科技周边 · 业界新闻 | 1天前 | kubernetes ·
- KubeCon 2026 新增 AI Inference 议题反映哪些趋势
- 150浏览 收藏
-
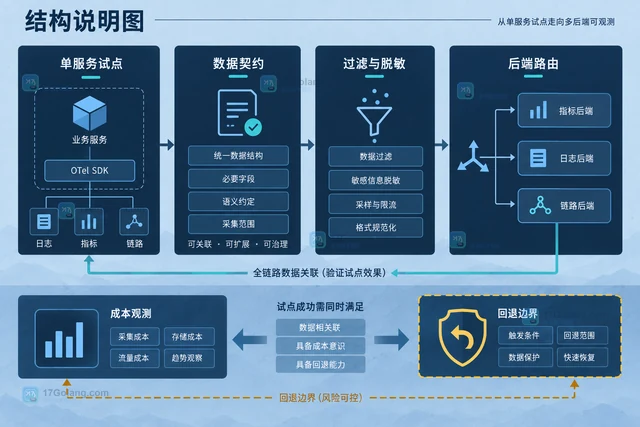
- 科技周边 · 业界新闻 | 1天前 | 云原生 · 可观测性 · 可观测性 OpenTelemetry Collector CNCF毕业 OTLP
- OpenTelemetry 成为 CNCF 毕业项目后释放什么信号
- 381浏览 收藏
-
- 科技周边 · 业界新闻 | 1天前 | 云原生 · kubernetes · Kubernetes CNCF K8gb GSLB 多集群负载均衡
- K8gb 进入 CNCF 孵化阶段关注点有哪些
- 216浏览 收藏
-
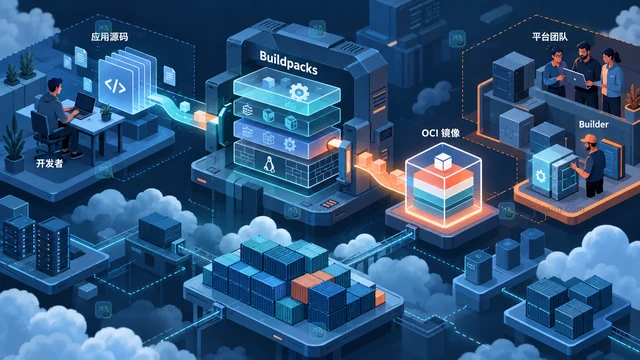
- 科技周边 · 业界新闻 | 1天前 | 云原生 · CNCF 平台工程 Cloud Native Buildpacks SBOM OCI镜像
- Cloud Native Buildpacks 毕业后应用构建生态会怎么变
- 117浏览 收藏
-
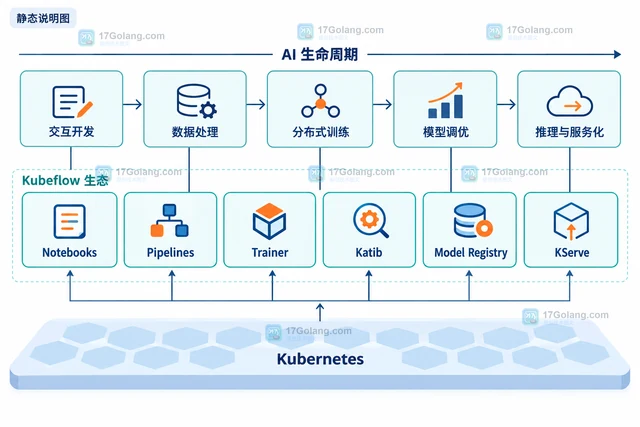
- 科技周边 · 业界新闻 | 1天前 | 云原生 · 业界新闻 · MLOps Kubernetes Kubeflow CNCF 云原生AI
- Kubeflow 晋级 CNCF 毕业项目带来哪些变化
- 463浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 253次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 298次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 271次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 251次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 57次使用
-
- Go语言对前端领域的入侵WebAssembly运行原理
- 2022-12-31 130浏览
-
- Go 批量 CSV 导入怎么控内存:流式读取、资源预算和失败行回传实战
- 2026-07-20 407浏览
-
- Go JSON 严格解码上线后请求变 400:DisallowUnknownFields 的兼容性故障复盘
- 2026-07-26 174浏览
-
- Go 流式响应怎么做:ResponseController.Flush、SSE 与断开回收的取舍
- 2026-07-26 463浏览
-
- Go 分页接口怎么设计:游标参数、错误码与兼容返回
- 2026-07-26 427浏览