
MySQL 8.4 索引跳过扫描怎么验收:复合索引缺首列时的适用边界
线上有一类查询很容易让人先入为主:索引是 (shop_id, created_at),SQL 却只按 created_at 筛选。通常我们会说“缺少最左列,索引帮不上忙”,但 MySQL 8.4 还有一个例外——优化器可能把不同的 shop_id 拆成多个小范围,逐段扫描 created_at。这个能力叫 Skip Scan,值不值得依赖,不能单看一次耗时就下结论,得核对执行计划、前缀基数,还有查询本身是不是覆盖索引。
Skip Scan 适合“索引前缀取值不多、后续列带范围条件、查询只需要索引列”的场景。先用
EXPLAIN确认计划里真的出现Using index for skip scan,再用真实业务数据和会话级开关做对照测试;它不是所有缺最左列查询的通用补丁。
- 复合索引为
(shop_id, created_at)时,created_at >= ...可能触发 Skip Scan。 - 单表查询、覆盖索引、前缀等值、后续带范围条件是几个核心准入门槛。
- 计划里的
Using index for skip scan字段,比“用到了某个索引”的标记辨识度高得多。 - 线上落地前要对比关闭
skip_scan、更新统计信息后的执行计划,同时也要准备好兜底的常规索引方案。
先看一个“索引存在却没写首列”的订单查询
假设订单明细表按店铺和时间建了联合索引,业务需要查最近一天的明细,结果页只展示索引里已经存好的字段:
CREATE TABLE shop_order_item (
  id BIGINT PRIMARY KEY,
  shop_id BIGINT NOT NULL,
  created_at DATETIME NOT NULL,
  order_no VARCHAR(32) NOT NULL,
  amount DECIMAL(12,2) NOT NULL,
  KEY idx_shop_created (shop_id, created_at)
);

SELECT shop_id, created_at
FROM shop_order_item
WHERE created_at >= '2026-08-09 00:00:00'
  AND created_at
这条 SQL 没有约束 shop_id,但它只读取 shop_id 和 created_at,两列都落在索引结构里。对这种查询形状,优化器可以先跳到每个不同的 shop_id 节点,再在该前缀下扫描符合条件的时间范围,不用把整个联合索引从头到尾全扫一遍。

Skip Scan 真正依赖哪些数据条件
最容易踩的误解是“只要缺第一列就会自动走跳过扫描”。实际上 MySQL 内部会先算成本,判断分段扫描的开销是不是比全索引扫描更低。shop_id 的不同值太多时,逐个前缀构造范围反而开销更大;如果查询需要回表取大量非索引字段,覆盖索引的优势也会直接消失。
复合索引顺序仍然决定搜索路径
Skip Scan 没有改变 B+Tree 本身的排序规则。它利用的是索引里前缀值的有序分布:先定位第一个 shop_id,再构造 shop_id = ? AND created_at >= ? 的扫描范围,处理完这段之后再跳到下一个前缀。前缀的可选值越少,整个过程的成本优势越容易体现。
覆盖列和单表是重要边界
官方要求的适用前提是查询只关联一个表,并且所有涉及的字段都在索引中。示例里如果改成 SELECT order_no, amount,现有索引没法覆盖返回结果,执行计划就可能转向普通全扫或者其他访问路径。涉及 GROUP BY、DISTINCT 的查询,也不能直接套同一套判断逻辑。
用 EXPLAIN 认出它,不要只看 key 字段
先更新测试数据的统计信息,再查看传统格式的执行计划:
ANALYZE TABLE shop_order_item;

EXPLAIN
SELECT shop_id, created_at
FROM shop_order_item
WHERE created_at >= '2026-08-09 00:00:00'
  AND created_at
重点别盯着 key = idx_shop_created 这一列看,要去 Extra 里找有没有出现 Using index for skip scan。只有这个提示出现,才能说明执行计划真的走了跳过扫描路径。如果只有 Using index,通常只能说明发生了覆盖索引扫描,不能把它当成 Skip Scan 的判断依据。
需要看更细的成本细节时,可以用树形输出格式的执行计划:
EXPLAIN FORMAT=TREE
SELECT shop_id, created_at
FROM shop_order_item
WHERE created_at >= '2026-08-09 00:00:00'
  AND created_at
不同数据分布下,优化器完全可能选普通索引扫描。这个结果不代表索引失效,先看 SHOW INDEX FROM shop_order_item 返回的 Cardinality,确认统计信息是不是很久没更新了。

用会话级对照确认优化器是否真的受益
排查的时候可以在当前连接里临时关闭 Skip Scan,再执行同一条查询。这样不会改动全局配置,适合压测或者线上只读观察场景:
SET SESSION optimizer_switch = 'skip_scan=off';

EXPLAIN ANALYZE
SELECT shop_id, created_at
FROM shop_order_item
WHERE created_at >= '2026-08-09 00:00:00'
  AND created_at
记录两次执行的实际扫描行数、循环次数和耗时,之后恢复会话设置或者重连就行。这里不要只对比冷缓存下的第一次运行结果,也不要把开发机小表上的耗时直接套到生产环境。至少准备三组测试数据:前缀值很少、前缀值较多、时间范围很宽,这几组场景就能把 Skip Scan 的适用边界摸得差不多。
什么时候应该补一个更贴近查询的索引
如果查询长期只按时间过滤,返回结果还要读很多业务字段,直接建立 (created_at, shop_id) 或者包含必要返回列的索引,通常比依赖优化器临场跳过前缀要可控得多。新建索引会增加写入开销和存储占用,所以先用慢查询样本确认访问频率,再走灰度发布流程留好回滚方案。
常见误区与上线前检查
把“possible_keys 有索引”当成已使用
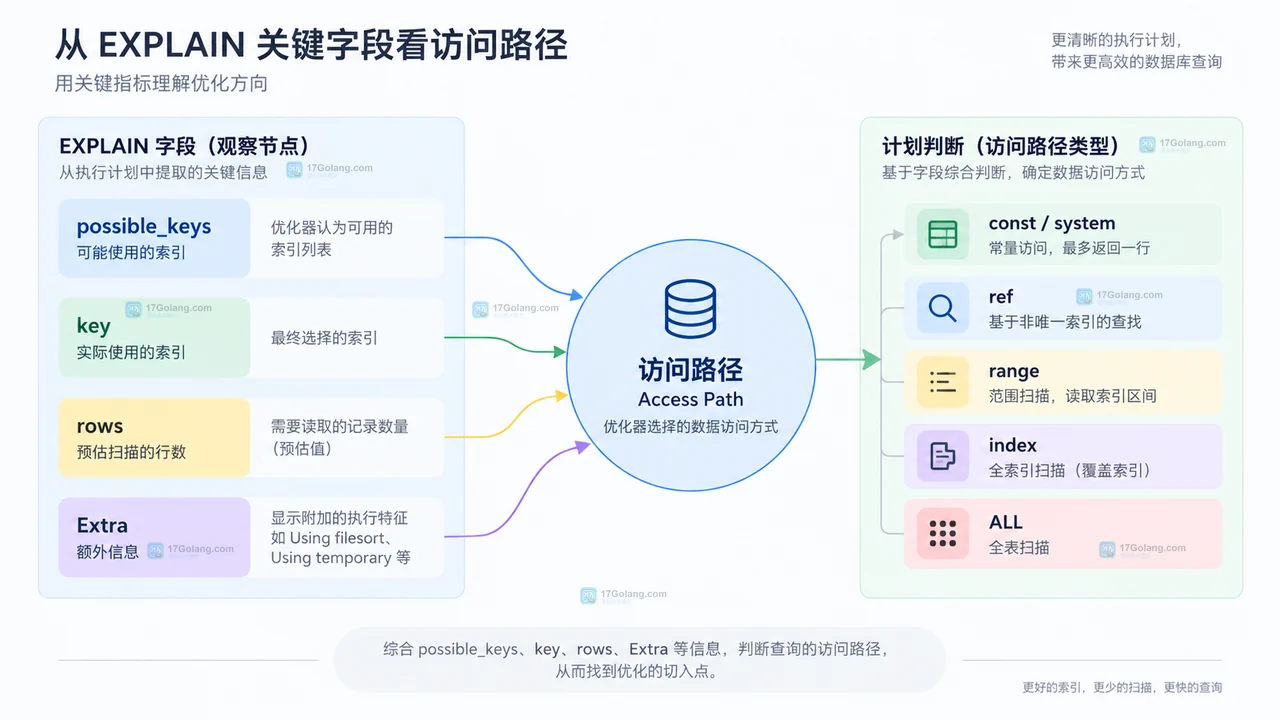
possible_keys 只是候选索引集合,真正选了哪条访问路径要看 key 和 Extra。Skip Scan 的专属识别信号是 Using index for skip scan,不是索引名称本身。
用关闭优化器开关代替索引设计
skip_scan=off 只是诊断工具,不建议设成长期全局配置。要是关闭之后执行计划明显变差,说明当前数据集下这个特性确实有收益;要是开不开都慢,问题大概率出在返回行数、时间范围、统计信息或者索引覆盖度上。
只在一份测试数据上验收
前缀基数和时间范围都会改变优化器的成本估算。发布前把 EXPLAIN、SHOW INDEX、代表性测试参数和两种开关状态下的结果存档,后续表数据量级上涨后还要重新复核。
相关问题
Skip Scan 是否等于跳过联合索引第一列?
可以这么理解,但它不是无条件绕过最左匹配规则,而是把前缀的不同值拆成多个子范围,只有满足所有条件且成本更优时才会启用。
为什么同一条 SQL 有时看不到 Using index for skip scan?
常见原因包括统计信息不准、前缀基数变高、返回列不再满足覆盖要求、查询的时间范围太宽,或者查询形状不满足单表和谓词条件。先更新统计信息,再对比两次的执行计划,不要仅凭一次执行结果就贸然改索引。
Skip Scan 能解决所有慢查询吗?
不能。它只优化了一类索引访问路径;涉及大量回表、排序、聚合或者多表连接的场景,还是要单独分析执行计划和实际数据访问量。
把验收结果留成一张小清单
最终可以把下面四项作为变更记录的最低要求:索引列顺序、代表性 SQL 和对应时间范围、EXPLAIN 里记录的访问方式、开启与关闭 skip_scan 的实际耗时和扫描行数。四项结果都符合预期,才值得把这条路径放到生产观察名单里;不然,补一个查询逻辑更匹配的常规索引往往要稳妥得多。
 Go 依赖被替换怎么查:GOSUMDB、GOPRIVATE 与私有模块边界
- 上一篇
- Go 依赖被替换怎么查:GOSUMDB、GOPRIVATE 与私有模块边界

- 下一篇
- Go slices.Chunk 怎么做批量处理:空批次、底层数组与边界测试
-
- 数据库 · MySQL | 6小时前 |
- MySQL JSON_TABLE 展开数组时如何保留缺失字段
- 501浏览 收藏
-
- 数据库 · MySQL | 7小时前 |
- MySQL CTE 多次引用时为什么可能重复物化
- 237浏览 收藏
-
- 数据库 · MySQL | 10小时前 | MySQL · 执行计划 · 索引优化 · mysql explain OR条件 Index Merge
- MySQL OR 条件什么时候会选择 Index Merge
- 373浏览 收藏
-
- 数据库 · MySQL | 12小时前 |
- MySQL 事务隔离级别下普通 SELECT 为什么看不到新提交
- 385浏览 收藏
-
- 数据库 · MySQL | 14小时前 | MySQL · 索引 · 性能优化 · 执行计划 · mysql explain optimizer hint FORCE INDEX USE INDEX
- MySQL optimizer hint 和 FORCE INDEX 怎么选择
- 478浏览 收藏
-
- 数据库 · MySQL | 14小时前 | MySQL · explain · 性能分析 · JSON执行计划 · 嵌套循环 · mysql 执行计划 EXPLAIN FORMAT=JSON nested_loop 查询成本
- MySQL EXPLAIN FORMAT=JSON 怎么查看嵌套循环成本
- 166浏览 收藏
-
- 数据库 · MySQL | 21小时前 |
- MySQL collation 不一致导致 JOIN 报错怎么统一
- 446浏览 收藏
-
- 数据库 · MySQL | 1天前 |
- MySQL 递归 CTE 生成日期序列时为什么列类型会截断
- 104浏览 收藏
-
- 数据库 · MySQL | 1天前 |
- MySQL 递归 CTE 遍历树数据时怎么防止无限循环
- 142浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 71次使用
-
- SuperCLUE
- SuperCLUE是权威的中文大语言模型综合评测基准,涵盖语言理解、知识应用、AI Agent智能体及安全性等12项核心能力。通过多轮对话与客观测试,定期发布榜单与技术报告,为模型研发、优化及行业选型提供科学依据。
- 233次使用
-
- C-Eval
- 深入了解C-Eval中文评估套件,涵盖52个学科与4级难度。本文详解其功能特点、Zero-shot/Few-shot使用方法及代码示例,助您全面评测LLM中文理解与泛化能力。
- 155次使用
-
- AI Prompt Library
- 探索AI Prompt Library免费资源库,涵盖营销、写作及多场景AI提示词。兼容ChatGPT、Claude等工具,一键复制优化输出,提升工作效率。
- 87次使用
-
- Generrated
- Generrated汇集9300+张DALL·E生成图像及对应提示词,支持查看完整图集、对比DALL·E 2与3版本差异,是AI绘图新手学习Prompt设计与获取创作灵感的实用工具。
- 64次使用
-
- MySQL JSON_TABLE 展开数组时如何保留缺失字段
- 2026-09-10 501浏览
-
- MySQL 分区表怎么处理跨分区唯一键:分区列约束与建表取舍
- 2026-08-30 501浏览
-
- MySQL权限管理设置全攻略
- 2026-03-29 501浏览
-
- MySQL分片实现方法及常见方案解析
- 2025-06-24 501浏览
-
- MySQL表空间碎片怎么清理?超详细优化教程
- 2025-06-13 501浏览


