
千问大模型舆情分析方法与监控方案
通义千问系列大模型为社交媒体品牌舆情分析提供了从轻量级本地部署到高精度闭环预警的五种实战路径:小模型Qwen2.5-0.5B适合边缘设备上的实时情感分类,Qwen3-1.7B支撑长文本与反讽识别的流式监控,Qwen3-Reranker-0.6B精准重排热点话题,Qwen2.5-7B构建跨源数据驱动的危机预警系统,而Qwen3.5-9B联合OpenClaw更可实现关键词触发的全自动监测、研判与多平台响应联动——无论你是初创团队追求隐私可控,还是大型企业需要端到端风控闭环,这套覆盖全场景、全链路的AI舆情方案都能帮你告别模糊选型与低效人工,真正让品牌声量看得清、判得准、回得快。
如果您希望利用通义千问开展舆情监控,对社交媒体上的品牌口碑进行自动分析,但面临模型选型模糊、部署路径不清或情绪识别不准等问题,则可能是由于未匹配具体任务需求与模型能力边界。以下是针对社交媒体品牌口碑自动分析的多种可行方法:
一、选用Qwen2.5-0.5B-Instruct进行本地轻量级情感分类
该模型参数量仅约5亿,FP16精度下整模体积约1.0 GB,适合在笔记本、树莓派或边缘设备上部署,可避免数据外传风险,并满足实时评论流处理需求。其结构化输出能力经专项优化,能稳定生成JSON格式情感判断结果。
1、安装必要依赖:执行pip install transformers torch sentencepiece命令完成基础库安装。
2、加载模型与分词器:使用AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B-Instruct")和AutoModelForCausalLM.from_pretrained(, torch_dtype=torch.float16, device_map="auto")完成加载。
3、构造提示词模板:设定固定格式如“请分析以下文本的情感倾向,输出JSON:{"sentiment": "positive/negative/neutral", "confidence": 0.0–1.0}”。
4、批量输入社交媒体原始评论,调用model.generate()获取结构化响应,解析JSON提取sentiment字段。
二、采用Qwen3-1.7B构建流式舆情监控管道
Qwen3-1.7B支持32K上下文与流式输出,在处理长微博、多轮对话或带emoji/缩写的短视频评论时具备更强语义鲁棒性,尤其擅长识别反讽、隐晦表达等复杂情绪信号,适合构建端到端监控系统。
1、访问CSDN星图镜像广场,搜索并一键拉取“Qwen3-1.7B舆情版”预置Docker镜像。
2、启动实例后,通过浏览器打开Jupyter Lab开发环境,确认端口为8000。
3、在Notebook中编写数据接入脚本,对接微博API、小红书RSS或抖音评论爬虫接口,将原始文本送入模型。
4、配置输出解析逻辑,对每条响应提取sentiment与reasoning字段,写入本地SQLite数据库供后续聚合统计。
三、集成Qwen3-Reranker-0.6B实现热点话题精准排序
该模型不直接做情感判断,而是作为重排序模块嵌入舆情流程,用于从聚类后的候选话题中筛选真实高影响力议题,解决传统TF-IDF或关键词匹配易受噪声干扰、无法识别语义关联热点的问题。
1、将初步聚类得到的Top 100候选话题列表作为输入,调用Qwen3-Reranker-0.6B进行两两比较打分。
2、使用cross-encoder架构对每对“话题-近期高频评论”组合计算相关性得分,输出0.0–1.0区间数值。
3、按得分降序排列,截取前10个话题进入人工复核队列,并标记需优先响应标识。
4、将重排序结果同步至看板系统,触发对应话题的深度情感追踪与传播路径还原任务。
四、部署Qwen2.5-7B-Instruct构建危机预警闭环系统
该模型具备128K超长上下文支持与原生工具调用能力,可在单卡A10/A40或RTX 4090上以FP16精度稳定运行,适用于整合多源异构数据(新闻稿+评论+转发链)进行跨文档一致性研判与风险升级判定。
1、使用vLLM框架加载Qwen2.5-7B-Instruct,启用enable_prefix_caching提升重复上下文推理效率。
2、定义Function Calling函数trigger_alert,当检测到连续3条高置信负面评论且含投诉/举报/维权等关键词时自动激活。
3、配置Open WebUI界面,将预警事件卡片推送至企业微信机器人,附带原始文本快照与情感溯源路径图。
4、在UI中嵌入一键生成话术按钮,调用同一模型基于事件摘要生成安抚型/澄清型/致歉型三类初稿供运营人员选用。
五、结合OpenClaw+千问3.5-9B实现关键词驱动的自动追踪与发布联动
该方案将舆情监控与内容运营打通,以行业关键词为锚点,自动抓取全平台提及、分析立场倾向,并基于结果生成适配各平台特性的回应内容与定时发布指令,形成“监测-研判-响应-传播”闭环。
1、在OpenClaw配置文件中定义核心关键词组,例如["电池爆炸", "充电起火", "品控翻车"],设置监控频率为每5分钟轮询一次。
2、捕获命中关键词的微博、小红书笔记及知乎问答,提取正文与用户画像标签(如“数码博主”“普通消费者”)。
3、调用Qwen3.5-9B执行多步推理:先判别是否构成事实性危机,再评估当前声量是否突破阈值,最后生成平台定制化响应包。
4、将生成的微博文案、小红书图文草稿、知乎回答逐条写入OpenClaw任务队列,按预设时间自动发布,并记录发布时间与平台反馈数据。
本篇关于《千问大模型舆情分析方法与监控方案》的介绍就到此结束啦,但是学无止境,想要了解学习更多关于科技周边的相关知识,请关注golang学习网公众号!
 QQ音乐缓存清理与空间释放方法
- 上一篇
- QQ音乐缓存清理与空间释放方法
- 下一篇
- 包子漫画网页入口在线看一键访问
-
- 科技周边 · 人工智能 | 8小时前 |
- LabelSpreading 的transduction与新样本预测有什么区别
- 467浏览 收藏
-
- 科技周边 · 人工智能 | 9小时前 |
- scikit-learn LabelSpreading 怎样标记未标注样本
- 283浏览 收藏
-
- 科技周边 · 人工智能 | 11小时前 | nltk Tree treepositions leaf_treeposition 句法树
- NLTK Tree 的叶节点位置与树节点位置有什么区别
- 197浏览 收藏
-
- 科技周边 · 人工智能 | 12小时前 |
- NLTK Tree 怎样读取括号形式的句法树
- 203浏览 收藏
-
- 科技周边 · 人工智能 | 13小时前 | 音频重采样 torchaudio Resample 卷积核缓存
- torchaudio 重采样变换缓存内核怎样减少重复计算
- 356浏览 收藏
-
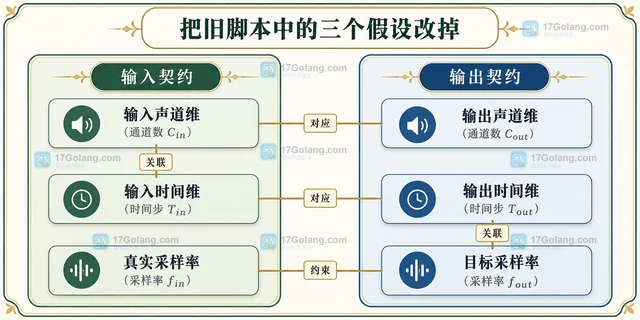
- 科技周边 · 人工智能 | 13小时前 |
- torchaudio 怎样重采样多声道波形
- 210浏览 收藏
-
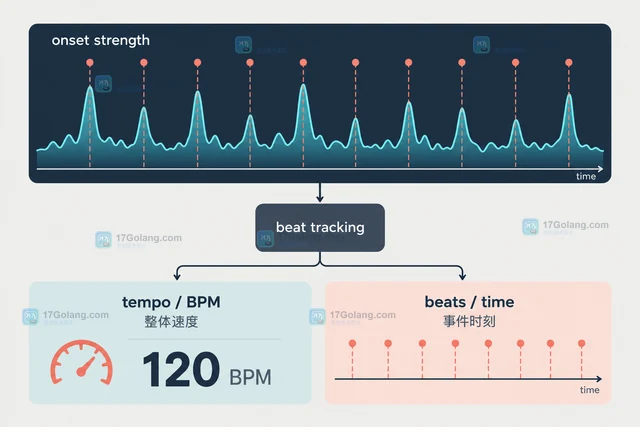
- 科技周边 · 人工智能 | 14小时前 | python · beats librosa beat_track tempo 节拍检测
- librosa beat_track 的速度估计与节拍时刻有什么区别
- 467浏览 收藏
-
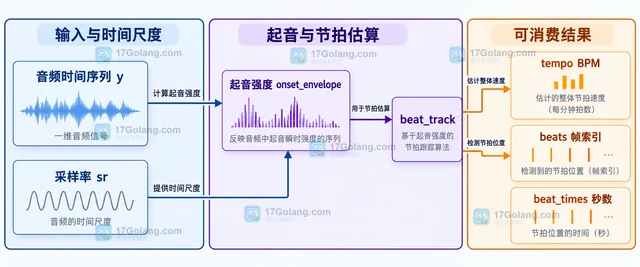
- 科技周边 · 人工智能 | 15小时前 |
- librosa 怎样估算音频节拍位置
- 444浏览 收藏
-
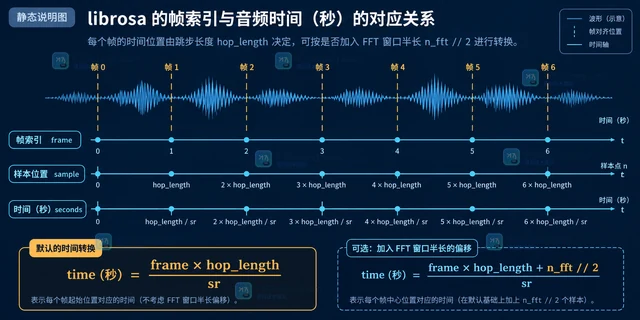
- 科技周边 · 人工智能 | 16小时前 |
- librosa 起音帧编号怎样转换成秒
- 306浏览 收藏
-
- 科技周边 · 人工智能 | 16小时前 | librosa 音频分析 起音检测 onset_detect
- librosa 怎样从音频中提取起音位置
- 484浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 812次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 801次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 892次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 865次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 688次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览


