
Python爬虫文档自动导出技巧
2026-05-31 18:03:32
0浏览
收藏
本文深入解析了使用Playwright进行Python文档自动化PDF导出时的常见陷阱与实战解决方案,直击page.pdf()导出空白、失败、样式错乱、内容缺失等核心痛点,系统性地覆盖打印功能启用、页面渲染等待策略、print媒体模拟、Shadow DOM/iframe处理、登录态持久化、Token过期应对及PDF内容有效性自动校验等关键环节,强调稳定导出的本质并非简单调用API,而是精准把握网页加载节奏、浏览器上下文生命周期与目标站点前端逻辑的深度协同——让每一份自动生成的PDF真正“所见即所得”,而非一张不可靠的白纸。
Playwright 中 page.pdf() 为什么导出空白或失败
直接调用 page.pdf() 常见问题是生成空 PDF 或报错 Protocol error (Page.printToPDF): Printing is not enabled。根本原因不是代码写错了,而是 Chromium 默认禁用打印功能,且页面未充分加载或未触发渲染就执行导出。
实操建议:
- 必须在
page.goto()后显式等待关键内容出现,例如page.wait_for_selector("main")或page.wait_for_load_state("networkidle"),不能只靠time.sleep() - 启动浏览器时需启用打印支持:传入
args=["--enable-printing"](Linux/macOS)或["--enable-printing", "--print-to-pdf-no-header"](Windows 更稳定) page.pdf()不支持直接导出带 JS 渲染的富文档(如 Vue/React 动态表格),需先确保目标 DOM 已静态就绪
导出前如何模拟“页面打印”行为(避免样式丢失)
很多在线文档(如 Notion、语雀、腾讯文档)会通过 CSS 的 @media print 隐藏侧边栏、按钮等非正文元素,但 Playwright 默认不触发该媒体查询。直接截图或 PDF 导出常保留导航栏、广告位,甚至排版错乱。
实操建议:
- 注入一段 JS 强制激活打印样式:
page.add_style_tag(content="@media print { * { visibility: visible !important; } }")(仅作兜底,不推荐长期依赖) - 更可靠的方式是先用
page.emulate_media(media="print")切换媒体类型,再等待重绘完成(如page.wait_for_timeout(300)) - 若文档使用 Shadow DOM 或 iframe 加载正文,需先
page.frame_locator()定位到目标 frame 再执行 PDF 导出
处理登录态与动态 Token 的实际方案
多数在线文档平台要求登录后才能查看完整内容,而 Playwright 的无头模式默认不保存 Cookie,手动登录又易被风控拦截(如滑块、短信验证)。
实操建议:
- 跳过登录流程:用已登录的浏览器配置启动,例如
playwright.chromium.launch_persistent_context(user_data_dir="/path/to/Chrome/User Data", headless=False),复用本地 Chrome 的登录态和扩展 - 若必须自动化登录,优先用
storage_state保存/加载认证状态,而非重复输入账号密码:context = browser.new_context(storage_state="auth.json") - 注意 Token 过期时间——
storage_state中的 cookie 可能含Expires字段,导出任务若隔天运行,需重新触发登录并覆盖旧文件
导出 PDF 后如何校验内容有效性
自动化流程中,PDF 看似生成成功,但可能只有封面页、全是空白页,或文字被渲染为路径(无法复制)。靠人工抽查不可持续。
实操建议:
- 用
pypdf.PdfReader快速检查页数和基础元数据:len(reader.pages) > 0 and reader.pages[0].extract_text().strip() - 避免依赖 OCR:对纯文本 PDF,优先用
pdfplumber提取首屏可见文字,比PyMuPDF更轻量且抗干扰强 - 导出后立即对比哈希值(如
hashlib.md5(open("out.pdf","rb").read()).hexdigest())可快速识别重复或空文件,适合加入 CI 流水线
真正难的不是点一下“打印”,而是让页面在无人值守时稳定进入可打印状态——这需要你理解目标网站的加载节奏、CSS 媒体逻辑和 Playwright 的上下文生命周期。漏掉任意一环,PDF 就可能变成一张白纸。
以上就是《Python爬虫文档自动导出技巧》的详细内容,更多关于的资料请关注golang学习网公众号!
 Golang实现Excel数据导入数据库策略
- 上一篇
- Golang实现Excel数据导入数据库策略
- 下一篇
- 谷歌小恐龙节日版入口与主题切换教程
查看更多
最新文章
-
- 文章 · python教程 | 5小时前 |
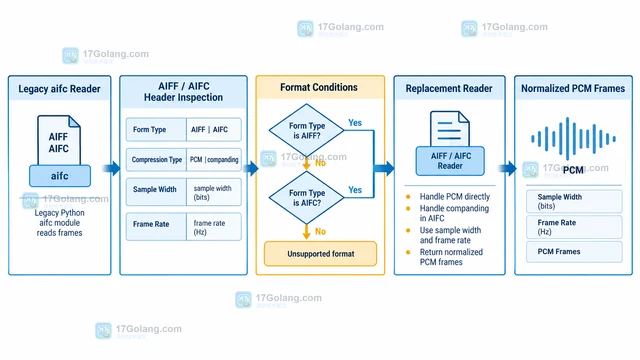
- Python aifc 替代方案 迁移旧 AIFF 读取代码前要确认哪些格式条件
- 144浏览 收藏
-
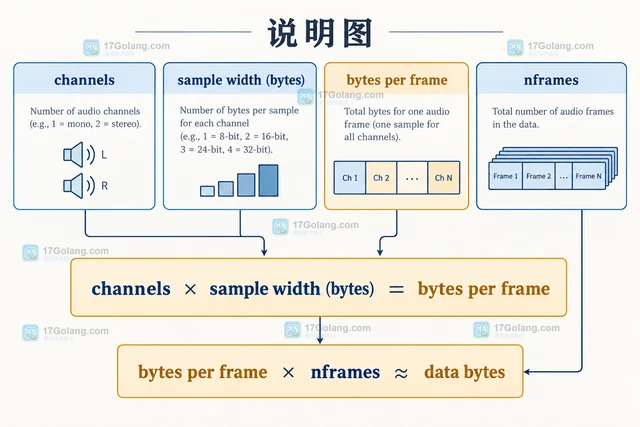
- 文章 · python教程 | 5小时前 | python ·
- Python wave.Wave_read 怎样读取 PCM 声道数和采样宽度
- 243浏览 收藏
-
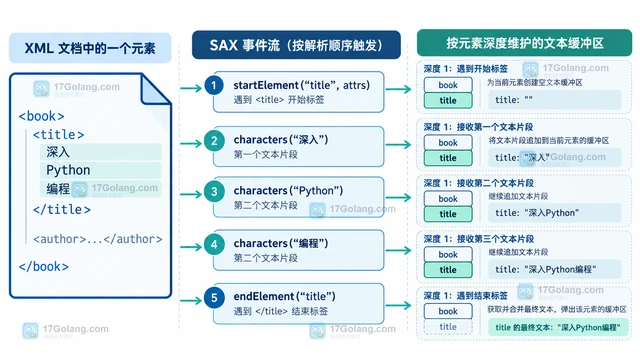
- 文章 · python教程 | 5小时前 | xml · Python教程 · Python SAX xml.sax.handler.ContentHandler characters XML文本解析
- Python xml.sax.handler.ContentHandler 怎样收集跨回调的文本内容
- 382浏览 收藏
-
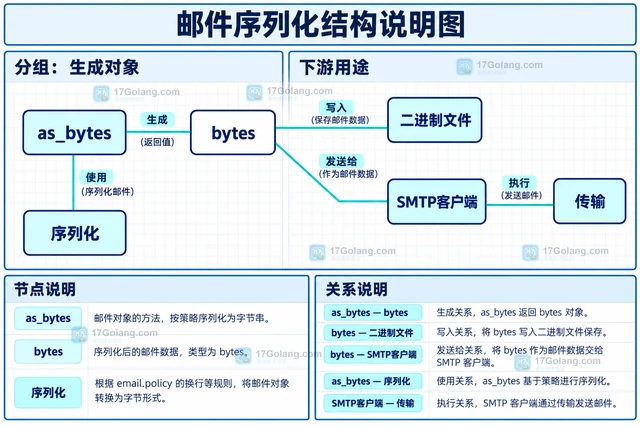
- 文章 · python教程 | 5小时前 |
- Python email.policy.clone 怎样设置邮件序列化换行规则
- 483浏览 收藏
-
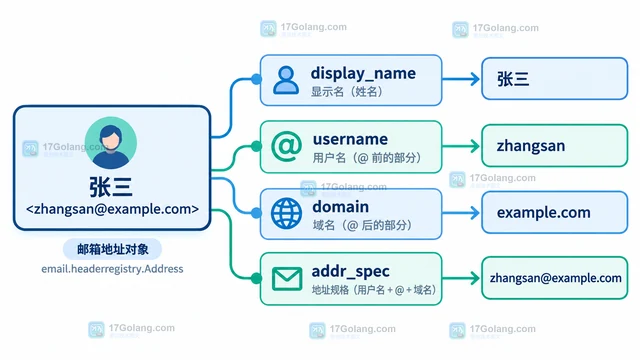
- 文章 · python教程 | 5小时前 | Python教程 · Python 邮件解析 email.headerregistry.Address 邮箱显示名 addr_spec
- Python email.headerregistry.Address 怎样区分邮箱显示名与地址
- 308浏览 收藏
-
- 文章 · python教程 | 5小时前 |
- Python decimal.Context.flags 怎样记录计算中的舍入信号
- 276浏览 收藏
-
- 文章 · python教程 | 5小时前 |
- Python statistics.kde_random 怎样按核密度估计生成样本
- 208浏览 收藏
-
- 文章 · python教程 | 5小时前 | 标准库 · python · Python overlap statistics NormalDist
- Python statistics.NormalDist.overlap 怎样比较两个正态分布重叠程度
- 182浏览 收藏
-
- 文章 · python教程 | 5小时前 |
- Python fractions.Fraction.limit_denominator 怎样用小分母近似测量值
- 401浏览 收藏
-
- 文章 · python教程 | 5小时前 |
- Python graphlib.CycleError 怎样读取依赖环中的节点
- 324浏览 收藏
-
- 文章 · python教程 | 5小时前 |
- Python string.templatelib 怎样读取模板中的插值对象
- 221浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 737次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 737次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 820次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 780次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 612次使用
查看更多
相关文章
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览


