
Python爬虫如何解析Brotli压缩数据
2026-05-31 17:54:32
0浏览
收藏
本文详解了Python爬虫中处理Brotli(br)压缩响应的完整解决方案:只需执行`pip install brotli`,Requests便会通过urllib3自动注册Brotli解码器,无需修改代码或手动解压;若仍报`ContentEncodingError`,问题通常出在环境不一致、urllib3版本过低(需≥1.26)、conda与pip混用、自定义适配器干扰,或服务器返回异常Brotli流等深层原因;文章还澄清了`brotli`与已弃用的`python-brotli`的区别,并指出仅在极少数特殊场景(如空响应、代理篡改、定制化解码需求)下才需手动接管解压逻辑——帮你快速定位、精准修复,告别Brotli压缩引发的爬虫中断困扰。
Requests 报错 ContentEncodingError: Cannot decode content body 怎么办
这是 Requests 遇到 Brotli 压缩响应但没装解码支持时的典型报错。Requests 本身不内置 Brotli 解压能力,必须额外装库并确保底层 urllib3 能识别 br 编码。
- 不是所有服务器都用 Brotli,但越来越多 CDN(如 Cloudflare)默认启用,尤其对静态资源或 API 响应
- 报错通常出现在
response.text或response.json()调用时,而非response.content—— 因为后者不触发自动解码 - 别试
response.headers.get('content-encoding')后手动解压:urllib3 已尝试过且失败了,说明它根本没注册br解码器
装 brotli 还是 python-brotli?
只装 brotli(PyPI 上的 brotli 包)就足够,python-brotli 是旧名、已弃用,装了反而可能冲突。
- 执行
pip install brotli即可,不需要--upgrade或额外编译参数 - 装完后 Requests 会自动通过 urllib3 检测到
brotli模块,并注册br解码器——无需改代码、无需手动调用brotli.decompress() - 验证是否生效:运行
import urllib3; print(urllib3.util.response._DECODERS),输出里应含'br'
为什么装了 brotli 还是报错?
常见原因不是库没装,而是环境或依赖链断了。
- 用了 conda 环境但用 pip 安装:conda 的 urllib3 可能没重新加载解码器,建议统一用
conda install -c conda-forge brotli - 项目锁了
urllib3 < 1.26:老版本 urllib3 不支持动态注册br解码器,必须升到1.26+(Requests 2.26+ 默认带) - 自己 patch 过
requests.adapters.HTTPAdapter或替换了urllib3.PoolManager:绕过了默认解码流程,得手动加decode_content=True或补解码逻辑 - 服务器返回的
Content-Encoding: br但实际内容不是合法 Brotli 流(比如被中间代理篡改),这时brotli.decompress()会抛BrotliError,需捕获处理
要不要手动解压?什么情况下必须绕过自动解码
绝大多数情况不用。但遇到以下场景,就得自己接管:
- 响应头是
Content-Encoding: br,但 body 是空或极小(response.content +try/except更稳 - 需要复用解压后的 bytes 做多次解析(比如先
json.loads()再lxml.fromstring()),避免重复解压开销——直接brotli.decompress(response.content) - 用的是
httpx或aiohttp:它们不共享 Requests 的解码机制,httpx需要httpx[http2](自带 Brotli 支持),aiohttp则要额外装aiohttp[br]
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Python爬虫如何解析Brotli压缩数据》文章吧,也可关注golang学习网公众号了解相关技术文章。
 Golang匿名函数与闭包实战详解
- 上一篇
- Golang匿名函数与闭包实战详解
- 下一篇
- 优化编译指令布局,提升硬件报错效率
查看更多
最新文章
-
- 文章 · python教程 | 4小时前 |
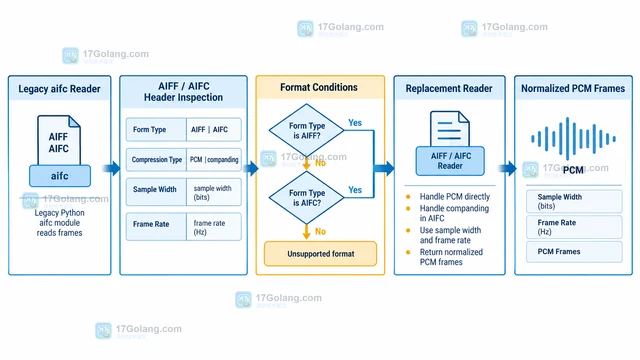
- Python aifc 替代方案 迁移旧 AIFF 读取代码前要确认哪些格式条件
- 144浏览 收藏
-
- 文章 · python教程 | 4小时前 | python ·
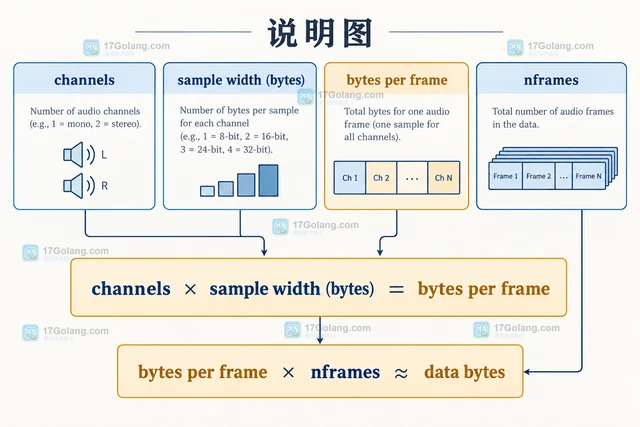
- Python wave.Wave_read 怎样读取 PCM 声道数和采样宽度
- 243浏览 收藏
-
- 文章 · python教程 | 4小时前 | xml · Python教程 · Python SAX xml.sax.handler.ContentHandler characters XML文本解析
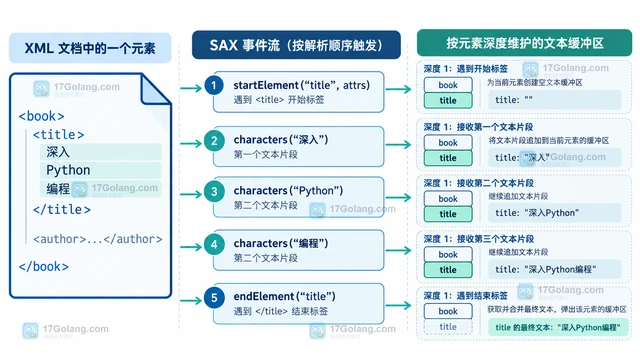
- Python xml.sax.handler.ContentHandler 怎样收集跨回调的文本内容
- 382浏览 收藏
-
- 文章 · python教程 | 4小时前 |
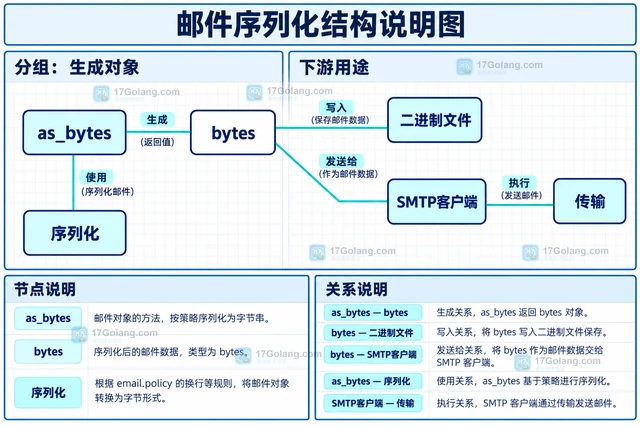
- Python email.policy.clone 怎样设置邮件序列化换行规则
- 483浏览 收藏
-
- 文章 · python教程 | 5小时前 | Python教程 · Python 邮件解析 email.headerregistry.Address 邮箱显示名 addr_spec
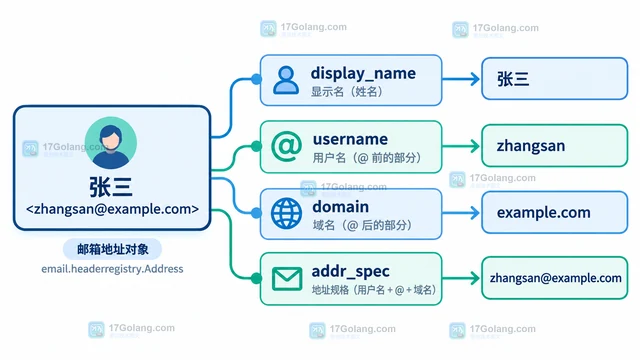
- Python email.headerregistry.Address 怎样区分邮箱显示名与地址
- 308浏览 收藏
-
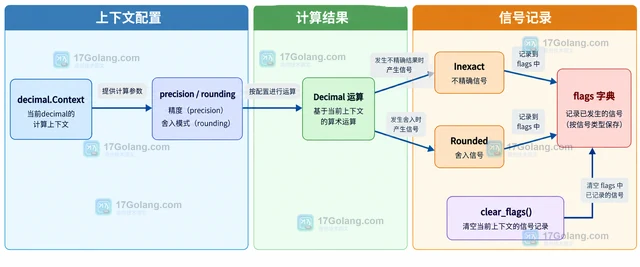
- 文章 · python教程 | 5小时前 |
- Python decimal.Context.flags 怎样记录计算中的舍入信号
- 276浏览 收藏
-
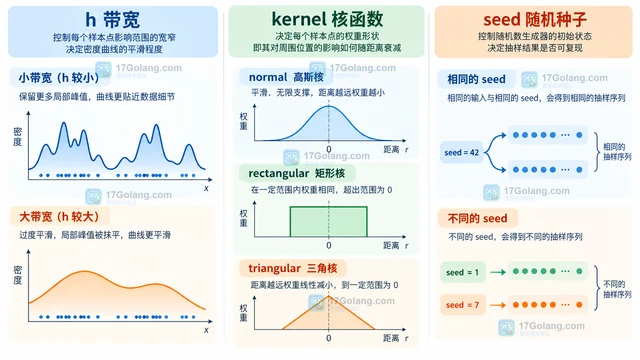
- 文章 · python教程 | 5小时前 |
- Python statistics.kde_random 怎样按核密度估计生成样本
- 208浏览 收藏
-
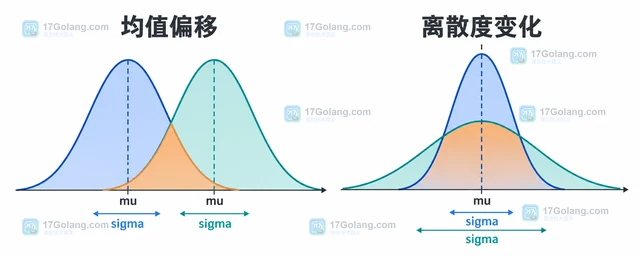
- 文章 · python教程 | 5小时前 | 标准库 · python · Python overlap statistics NormalDist
- Python statistics.NormalDist.overlap 怎样比较两个正态分布重叠程度
- 182浏览 收藏
-
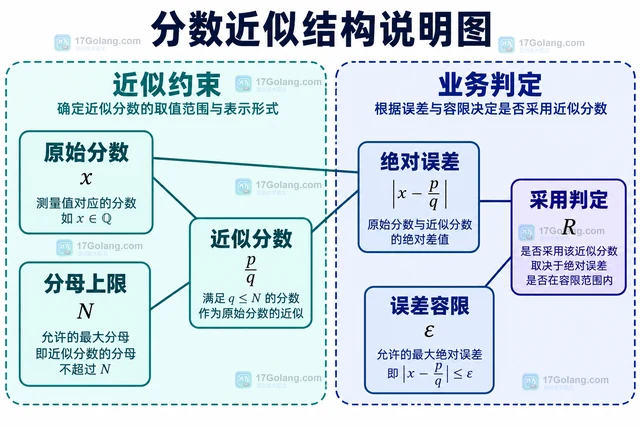
- 文章 · python教程 | 5小时前 |
- Python fractions.Fraction.limit_denominator 怎样用小分母近似测量值
- 401浏览 收藏
-
- 文章 · python教程 | 5小时前 |
- Python graphlib.CycleError 怎样读取依赖环中的节点
- 324浏览 收藏
-
- 文章 · python教程 | 5小时前 |
- Python string.templatelib 怎样读取模板中的插值对象
- 221浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 737次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 737次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 820次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 780次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 612次使用
查看更多
相关文章
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览


