
Python用dateparser解析非标准时间字符串
在网页爬虫开发中,面对五花八门、中英混杂、含相对表述(如“昨天”“2小时前”)和多时区的非标准时间字符串,`dateparser.parse()` 凭借无需预设格式、内置多语言支持、自动时区识别、精准相对时间推算及模糊表达理解等优势,显著优于需硬编码多种格式且完全无法处理动态语义的 `datetime.strptime()`;配合显式指定 `languages`、合理配置 `settings`(如 `RELATIVE_BASE` 和 `STRICT_PARSING`)、预清洗脏数据及针对性性能优化,它能以高鲁棒性和实用性成为爬虫时间解析的首选利器——但务必牢记:它给出的是智能推断结果,而非绝对权威,使用时需结合业务场景审慎判断与验证。

dateparser.parse() 为什么比 datetime.strptime() 更适合爬虫时间解析
爬虫拿到的时间字符串往往五花八门:"2024-03-15T14:23:08+08:00"、"昨天 16:42"、"2小时前"、"2024年3月15日 上午10:30",甚至混着英文和中文的 "Mar 15, 2024 at 2:30 PM"。用 datetime.strptime() 写一堆 try/except + 多种格式硬匹配,维护成本高、漏解析率高。
dateparser 的核心优势是「无需预设格式」——它内置了多语言支持、相对时间推算、时区自动识别和常见模糊表达理解。比如 dateparser.parse("上周三") 能结合当前日期准确回溯到具体日期,而 strptime() 根本无法处理。
注意:它默认返回 datetime 对象(带时区信息),不是字符串,后续做比较或存储前需确认是否要归一化时区。
安装与基础用法:别跳过 locale 和 settings 参数
直接 pip install dateparser 即可,但实际使用中不指定语言环境极易出错。网页内容可能是中文,但系统 locale 是 en_US,这时 dateparser.parse("昨天") 可能返回 None。
推荐显式指定:
import dateparser
# 强制按中文解析
dateparser.parse("昨天 18:20", languages=['zh'])
# 或同时支持中英(适合混合内容)
dateparser.parse("Mar 15, 2024 | 3天前", languages=['zh', 'en'])
# 指定基准时间(避免“今天”“现在”依赖运行时刻)
dateparser.parse("2小时后", settings={'RELATIVE_BASE': datetime(2024, 3, 15, 12, 0)})languages必须传列表,单语言也写成['zh'],不能是字符串'zh'- 未指定
languages时,它会尝试自动检测,但对短字符串(如仅"下午3点")大概率失败 settings中的RELATIVE_BASE对测试和回溯历史页面特别关键;否则“昨天”永远基于datetime.now()
常见失败场景及绕过技巧
不是所有字符串都能被完美解析。典型失败包括:含乱码的日期("2024-03-15??14:23")、嵌套 HTML 标签("2024-03-15")、超长无分隔符数字("20240315142308")。
不要让整个程序卡在一条坏数据上:
def safe_parse_date(text):
if not isinstance(text, str) or not text.strip():
return None
# 预清洗:去标签、去多余空格、替换全角标点
import re
cleaned = re.sub(r'<[^>]+>|[\u3000\s]+', ' ', text).strip()
cleaned = cleaned.replace(':', ':').replace('—', '-').replace('–', '-')
return dateparser.parse(cleaned, languages=['zh'], settings={'STRICT_PARSING': False})
示例
safe_parse_date(" 下午3:00") # → datetime object
STRICT_PARSING=False(默认)允许跳过无法识别的部分,比如"2024-03-15 abc 14:23"仍可能解析出日期时间- 遇到纯数字串(如
"20240315"),dateparser默认不识别,需先正则补成分隔符:re.sub(r'^(\d{4})(\d{2})(\d{2})$', r'\1-\2-\3', s) - 返回
None时,不要直接 .strftime(),务必判空
性能与线程安全要注意什么
dateparser 解析单条文本平均耗时约 5–20ms(视字符串复杂度),比 strptime() 慢一个数量级。高频抓取场景下,批量解析会明显拖慢 pipeline。
优化建议:
- 避免在循环里反复调用
dateparser.parse()处理相同格式的大量数据;可先用正则粗筛标准格式(如 ISO 8601),仅对非标字符串走dateparser - 它本身是线程安全的,但内部有缓存机制;若在多进程(
multiprocessing)中使用,每个子进程需独立初始化,不共享 parser 实例 - 不建议全局缓存
dateparser的结果(如用@lru_cache),因为输入常含相对时间(“刚才”“明天”),缓存会导致时间漂移
真正麻烦的从来不是“能不能转”,而是“什么时候该信它的结果”——比如网页里写 "预计下周发布",dateparser 会给出一个未来日期,但你得知道这个日期只是推算值,不是权威发布时间。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于文章的相关知识,也可关注golang学习网公众号。
 ESM模块异步加载流程图解析
- 上一篇
- ESM模块异步加载流程图解析

- 下一篇
- 苏宁金融账号如何注销?
-
- 文章 · python教程 | 11小时前 |
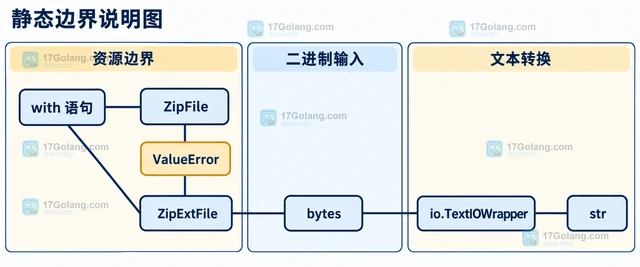
- Python zipfile.ZipFile.open 怎样按二进制流读取压缩成员
- 340浏览 收藏
-
- 文章 · python教程 | 12小时前 | python · Python 进程间通信 multiprocessing shared_memory ShareableList
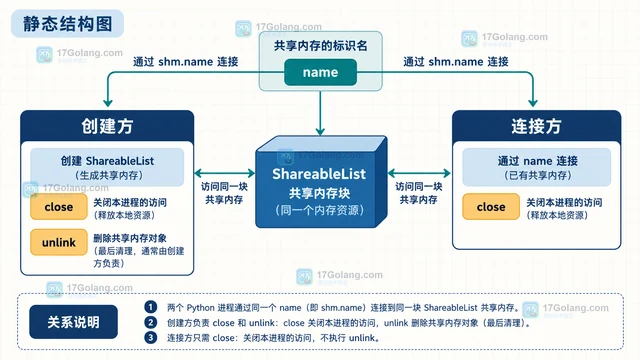
- Python ShareableList 固定长度共享列表的类型与容量边界
- 163浏览 收藏
-
- 文章 · python教程 | 12小时前 | 工程实践 · Python教程 · Python 对象生命周期 weakref weakref.finalize 清理回调
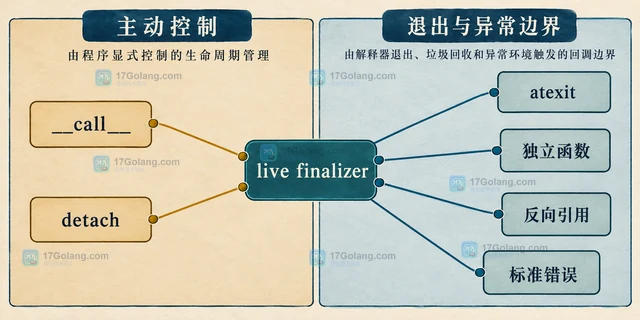
- Python weakref.finalize 怎样为对象注册清理回调
- 200浏览 收藏
-
- 文章 · python教程 | 12小时前 | python · Python TypeGuard 类型收窄 typing.TypeIs
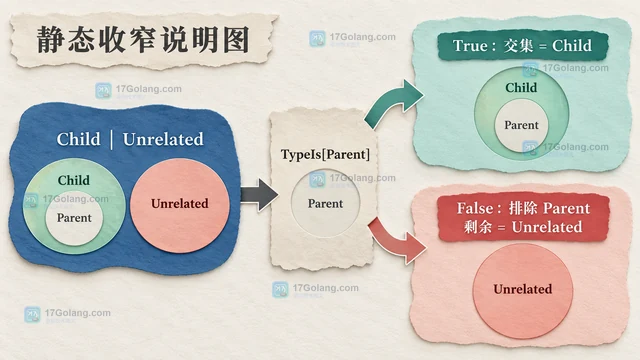
- Python typing.TypeIs 怎样表达更精确的类型收窄
- 218浏览 收藏
-
- 文章 · python教程 | 12小时前 |
- Python dataclasses.field 怎样声明不可共享的默认值
- 250浏览 收藏
-
- 文章 · python教程 | 13小时前 | SQLite · Python教程 · Python sqlite3 sqlite3.Row row_factory 按列名读取
- Python sqlite3.Row 怎样按列名读取查询结果
- 197浏览 收藏
-
- 文章 · python教程 | 13小时前 | Python asyncio CancelledError 异步超时 asyncio.timeout TimeoutError
- Python asyncio.timeout 怎样把超时变成可捕获异常
- 419浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 849次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 852次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 933次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 909次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 736次使用
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览


