
Linux启动优化:systemd-analyzeblame使用详解
本文深入解析了 Linux 系统启动耗时分析的核心工具 systemd-analyze blame 的使用误区与进阶技巧,指出其显示的“毫秒级耗时”仅统计服务自身的 active 阶段,严重低估依赖等待、I/O 延迟、initramfs 解压及内核初始化等真实瓶颈;通过对比 critical-chain 的关键路径分析、plot 时序图可视化、initrd 与 device unit 异常识别等方法,揭示真正拖慢启动的往往是底层硬件交互、系统配置缺陷或启动链末端的阻塞服务——而非 blame 列表里排在最前的那些“显眼”服务,帮你跳出表面数据陷阱,精准定位并解决实际启动性能问题。

systemd-analyze blame 显示的单位是毫秒,但实际耗时可能被低估
systemd-analyze blame 输出每一项服务的“启动耗时”,但它只统计从该 unit 进入 start 状态到进入 running 状态之间的时间(即 active 时间),不包含依赖等待、并行阻塞、I/O 延迟或内核模块加载等前置开销。比如 NetworkManager.service 显示耗时 850ms,但若它卡在等待 sysinit.target 下游的 udev-settle.service 完成,这部分不会计入它的 blame 时间。
实操建议:
- 先运行
systemd-analyze blame快速定位“表面最慢”的几个服务 - 对排在前 5 的服务,用
systemd-analyze plot > boot.svg导出时序图,观察它们是否真正串行,还是被其他 unit 拖累 - 重点关注那些耗时长且
WantedBy=multi-user.target或WantedBy=default.target的服务,它们更可能影响用户可见的启动终点
blame 结果里出现 kernel 或 initrd 相关条目说明问题不在 systemd 本身
如果 systemd-analyze blame 输出中出现类似 dev-disk-by\x2duuid-xxx.device、initrd-switch-root.service 或 kernel-command-line 这类条目,说明瓶颈在内核初始化、initramfs 解压/挂载、或根文件系统识别阶段——这些阶段 systemd 尚未接管,blame 统计无效。
此时应切换诊断路径:
- 检查 initramfs 大小:运行
ls -lh /boot/initramfs-$(uname -r).img,超 50MB 容易拖慢解压 - 确认磁盘 UUID 是否稳定:
blkid和/etc/fstab中的 UUID 是否一致,不一致会导致dev-disk-by\x2duuid-*.device超时重试 - 查看内核日志起点:用
dmesg -t | head -20看第一条时间戳,对比systemd-analyze time中的 “firmware” 和 “loader” 阶段耗时
想看完整启动链路,不能只靠 blame,得配合 critical-chain
systemd-analyze critical-chain 展示的是从启动开始到某个 target(默认 default.target)的**最长依赖路径**,每一步都含实际耗时,比 blame 更能反映“为什么启动慢”。例如它可能显示:default.target → multi-user.target → sshd.service → network-online.target → NetworkManager-wait-online.service,而最后一步耗时 12s——这说明 SSH 启动被网络就绪卡住,而非 sshd.service 本身慢。
实用技巧:
- 加
--no-pager避免分页截断:systemd-analyze critical-chain --no-pager - 指定 target 查关键路径:
systemd-analyze critical-chain graphical.target(桌面环境) - 对比两个 target 的路径差异,能快速判断桌面 vs CLI 启动慢在哪一环
blame 排序不准?注意 --order 和 --reverse 参数的误用场景
systemd-analyze blame 默认按耗时降序排列,但如果你手动加了 --order 或 --reverse,结果会变成按 unit 名字字母序或反序,完全失去性能分析意义。常见错误是复制网上命令时没删掉冗余参数,比如:systemd-analyze blame --order —— 这个 --order 实际被忽略(因为没指定值),但容易让人误以为排序逻辑变了。
安全做法:
- 始终用原始命令:
systemd-analyze blame - 需要过滤时用管道:
systemd-analyze blame | grep -E "(docker|nginx|mysql)" - 导出为 CSV 分析:用
systemd-analyze blame --json=short(systemd v249+)再交给 awk 或 jq 处理
/proc/cmdline 或重做 initramfs,不是改 systemd service 文件能解决的。今天带大家了解了的相关知识,希望对你有所帮助;关于文章的技术知识我们会一点点深入介绍,欢迎大家关注golang学习网公众号,一起学习编程~
 购物车商品消失原因及解决方法
- 上一篇
- 购物车商品消失原因及解决方法

- 下一篇
- QoderWake适合SaaS企业吗?AI全流程案例解析
-
- 文章 · linux | 5小时前 | Linux · 文件系统 · Linux 挂载点 bind mount findmnt mountinfo
- Linux findmnt 怎样看清 bind 挂载的源路径
- 207浏览 收藏
-
- 文章 · linux | 5小时前 |
- journalctl 怎样按服务和启动周期筛选日志
- 356浏览 收藏
-
- 文章 · linux | 6小时前 |
- ip route get 怎样带 mark 模拟策略路由选择
- 320浏览 收藏
-
- 文章 · linux | 6小时前 | Linux systemd CPU占用 内存占用 磁盘I/O cgroup systemd-cgtop
- systemd-cgtop 怎样观察服务资源占用
- 380浏览 收藏
-
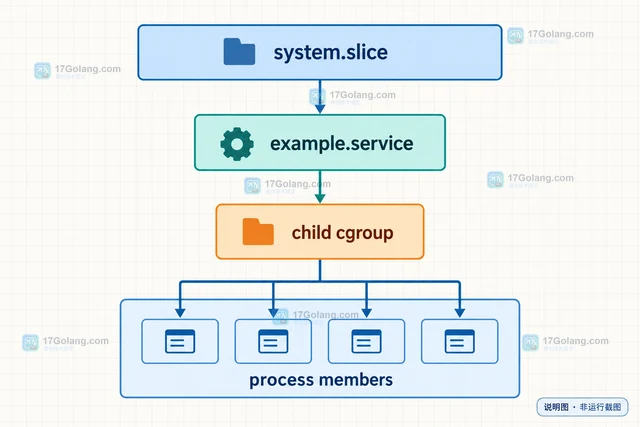
- 文章 · linux | 6小时前 | Linux · cgroup systemd-cgls
- systemd-cgls 怎样查看服务 cgroup 树
- 449浏览 收藏
-
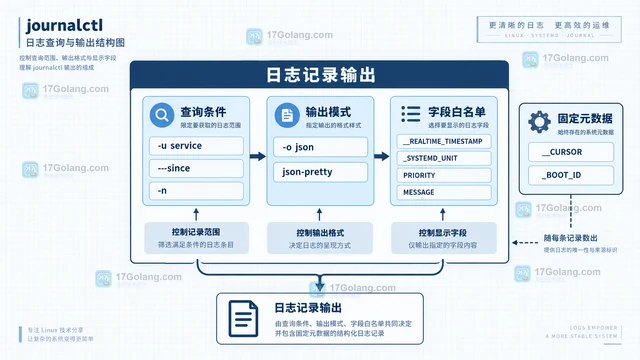
- 文章 · linux | 6小时前 | Linux · JSON systemd journalctl 日志字段 output-fields
- journalctl 怎样只输出指定字段
- 360浏览 收藏
-
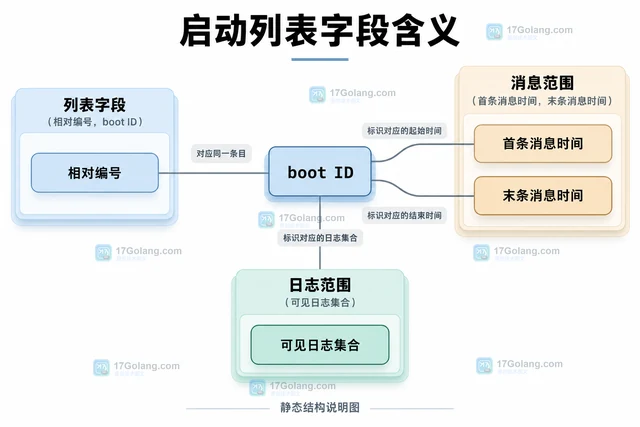
- 文章 · linux | 6小时前 |
- journalctl 怎样按 boot ID 查询指定启动日志
- 415浏览 收藏
-
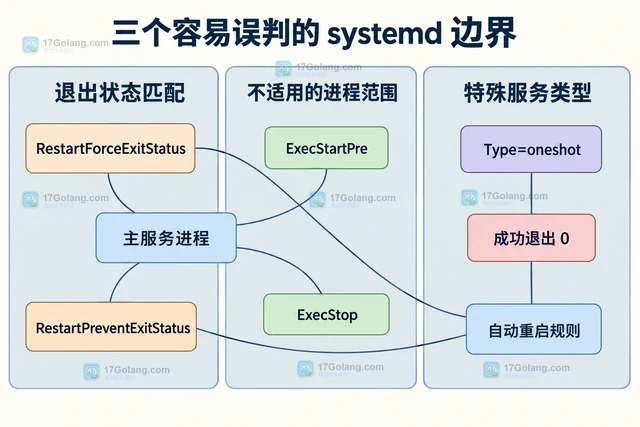
- 文章 · linux | 6小时前 |
- systemd 怎样按退出码决定是否重启
- 199浏览 收藏
-
- 文章 · linux | 6小时前 |
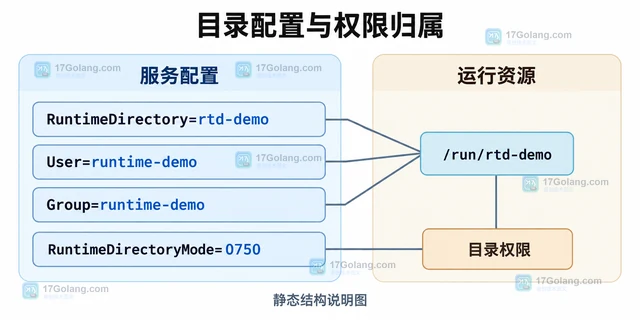
- systemd 服务怎样使用 RuntimeDirectory 管理运行目录
- 367浏览 收藏
-
- 文章 · linux | 6小时前 |
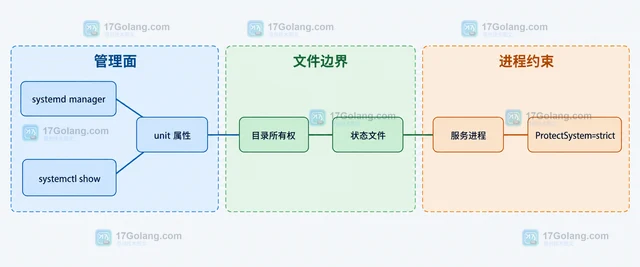
- systemd StateDirectory 怎样保存服务状态文件
- 399浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 479次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 535次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 557次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 507次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 328次使用
-
- Linux vmstat 如何分辨内存抖动与磁盘等待:si、so、wa 与复测顺序
- 2026-08-30 501浏览
-
- Linux搭建vsftpdFTP服务器教程
- 2026-04-30 501浏览
-
- Shell脚本安装教程:.sh一键安装指南
- 2026-03-16 501浏览
-
- Linux清空文件内容的几种方法
- 2025-12-01 501浏览
-
- Linux命令行下载文件技巧
- 2025-11-23 501浏览