
如何通过Stream.flatMap实现对大规模数据集变量的高效采样与分布均衡
2026-05-24 13:34:10
0浏览
收藏
哈喽!今天心血来潮给大家带来了《如何通过Stream.flatMap实现对大规模数据集变量的高效采样与分布均衡》,想必大家应该对文章都不陌生吧,那么阅读本文就都不会很困难,以下内容主要涉及到,若是你正在学习文章,千万别错过这篇文章~希望能帮助到你!
flatMap本身不直接采样或均衡,而是做“一对多映射+扁平化”的结构准备;采样与均衡需结合filter、limit、hash等后续操作或外部策略实现。

Stream.flatMap 本身不直接用于采样或分布均衡,它是一个结构转换工具,核心职责是“一对多映射 + 扁平化”,而非统计抽样或负载调度。但你可以组合使用 flatMap 与其他 Stream 操作(如 filter、skip、limit、distinct)或外部策略(如分片、哈希、随机种子),在数据预处理阶段为高效采样与分布均衡打下基础。
下面从实际可落地的角度说明关键思路和典型做法:
flatMap 在采样与均衡中的定位:做“结构准备”,不做“决策判断”
flatMap负责把原始嵌套/分组/批量数据“摊开成可逐个处理的原子项”;- 真正的采样逻辑(如随机选 1%、按 key 哈希取模、轮询分片)需由后续操作完成;
- 它让大规模、非扁平的数据(如
List、Map、Optional流)变得可统一筛选、排序、截断。
常见高效采样与均衡场景及写法
对分片数据集做均匀采样
假设你有 100 个文件流(每个文件含万级记录),想从中总采 1000 条且尽量覆盖各文件:List
files = /* 100 个路径 */; Random rand = new Random(42L); // 固定种子保障可重现 List sample = files.stream() .map(this::readFileAsStream) // 返回 Stream .flatMap(stream -> stream .sorted((a, b) -> Integer.compare(rand.nextInt(), rand.nextInt())) // 局部随机 .limit(10)) // 每文件最多取 10 条 → 总量可控 .limit(1000) // 全局上限兜底 .collect(Collectors.toList()); 按业务键(如 user_id)做哈希均衡采样
避免某些热 key 主导样本,用flatMap先展开再 hash 过滤:List
events = /* 来自多个日志批次 */; int sampleMod = 100; List sampledUserIds = events.stream() .flatMap(e -> Stream.of(e.getUserId())) // 展开为单元素流(也可配合去重) .distinct() // 去重后按用户采样更合理 .filter(id -> Math.abs(id.hashCode()) % sampleMod == 0) // 取模均衡 .limit(5000) .collect(Collectors.toList()); 处理 Optional 或空集合时避免样本丢失
大规模数据中常含 null 或空 list,flatMap配合安全包装可保流程稳定:List
- allItems = optionalItems.stream() .flatMap(opt -> opt .map(List::stream) .orElseGet(Stream::empty)) // 空值转为空流,不中断也不丢数据 .collect(Collectors.toList()); // 后续再对 allItems 做 limit/skip/shuffle 等采样
结合分区索引实现分层采样(如按时间+地域)
若原始数据是Map,可用flatMap两层展开,再加权重控制:Map
注意事项:性能与边界
flatMap是中间操作,惰性执行,但若映射函数中创建大量小 Stream(如对每个字符串.split("")后flatMap),会带来对象分配开销;- 对超大数据源(如数据库游标、文件流),优先用
limit()配合flatMap截断,避免全量加载; - 真正的“分布均衡”往往依赖外部信息(如 key 分布直方图、分片元数据),
flatMap仅提供结构适配能力,不能替代采样算法本身。
不复杂但容易忽略
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于文章的相关知识,也可关注golang学习网公众号。
 Golang中sync.Map在频繁读写交替场景的吞吐劣势
- 上一篇
- Golang中sync.Map在频繁读写交替场景的吞吐劣势

- 下一篇
- 冬至如何祭祖_冬至节气祭祖的步骤与注意事项
查看更多
最新文章
-
- 文章 · java教程 | 2天前 | Java · ServiceLoader module-info.java Java模块
- Java 模块服务加载的可选实现与回退路径
- 363浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java VarHandle 内存序选择与可见性验证
- 226浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java JFR 事件流定位短时延迟尖峰
- 213浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java Record 序列化兼容字段演进方案
- 483浏览 收藏
-
- 文章 · java教程 | 2天前 |
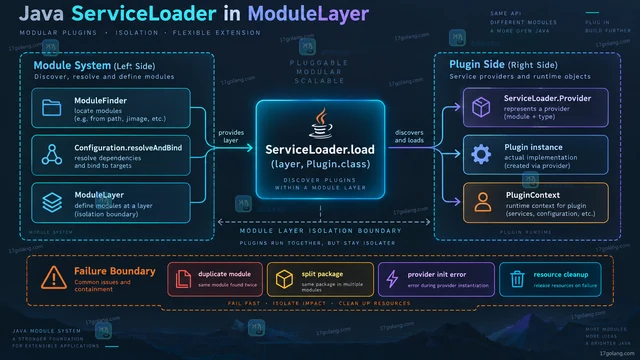
- Java ServiceLoader 隔离模块化插件实现
- 414浏览 收藏
-
- 文章 · java教程 | 2天前 |
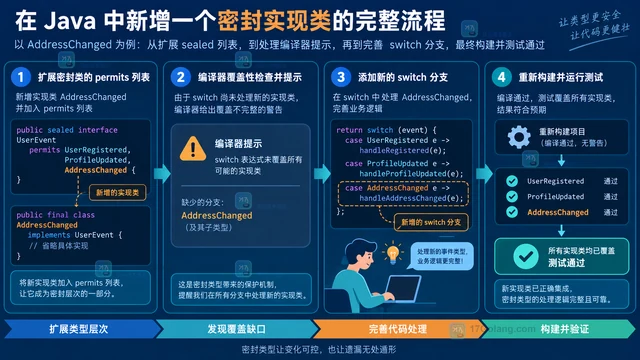
- Java Pattern Matching switch 处理密封层级
- 189浏览 收藏
-
- 文章 · java教程 | 2天前 | Stream · Java教程 · java Stream Collector Collectors.teeing 统计汇总
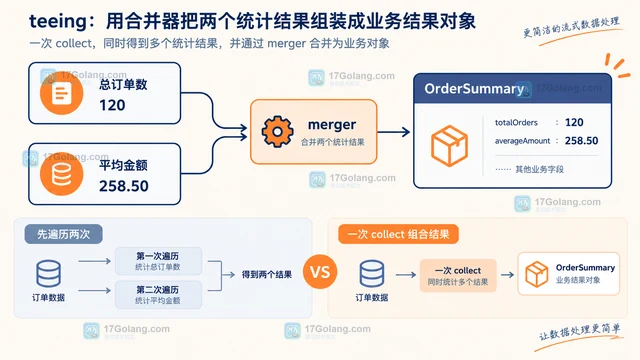
- Java Collectors.teeing 汇总两条统计管道
- 385浏览 收藏
-
- 文章 · java教程 | 2天前 |
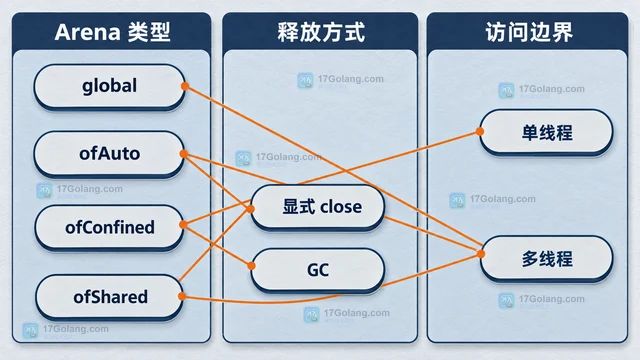
- Java Foreign Function Memory API 管理本地内存生命周期
- 385浏览 收藏
-
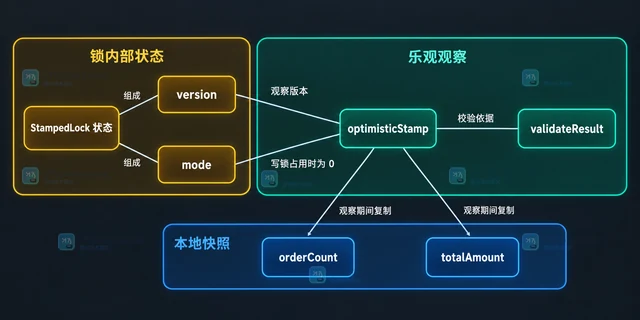
- 文章 · java教程 | 2天前 |
- Java StampedLock 乐观读校验失败的回退方式
- 165浏览 收藏
-
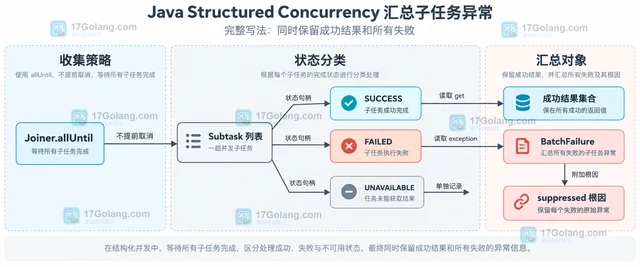
- 文章 · java教程 | 2天前 | 异常处理 · 并发编程 · Java教程 · StructuredTaskScope Java Structured Concurrency Joiner allUntil 子任务异常 聚合异常
- Java Structured Concurrency 汇总子任务异常
- 260浏览 收藏
-
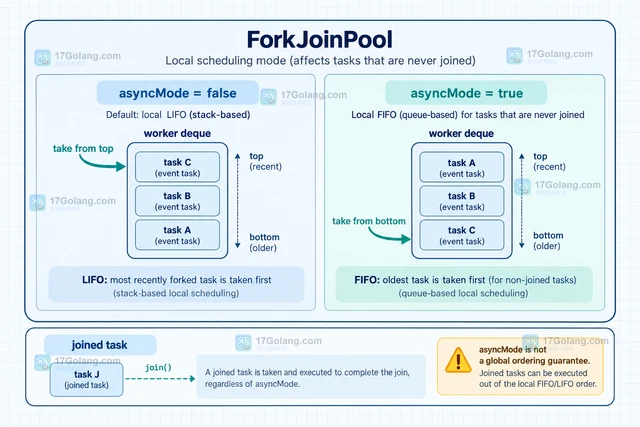
- 文章 · java教程 | 2天前 |
- Java ForkJoinPool asyncMode 调整任务队列顺序
- 121浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 446次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 517次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 532次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 479次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 304次使用
查看更多
相关文章
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览
-
- 反射异常处理:InvocationTargetException解析与应用
- 2026-05-16 501浏览


