
QoderWake自动生成注释:养成高效文档习惯
QoderWake是一款专为开发者打造的智能注释自动化工具,通过Repo Wiki联动、任务流触发、CLI批量注入和Git Pre-commit Hook四大机制,将高质量代码注释从“可选项”变为“必选项”,不仅显著提升函数与类的可读性、降低团队协作与新人上手成本,更将文档编写深度嵌入开发全流程——从编码保存、任务执行、历史补全到提交校验,实现注释生成、同步、复用与强制合规的一站式闭环,真正让高效文档习惯成为每个工程师触手可及的日常实践。
如果您在使用QoderWake进行代码开发时发现函数或类缺乏可读性注释,导致协作效率下降或新人上手困难,则可能是由于注释未随代码变更同步更新。以下是实现QoderWake自动生成注释并固化为开发流程的配置方法:
一、启用Repo Wiki联动注释生成
该方法利用QoderWake与Repo Wiki的知识协同机制,在代码提交前自动注入符合项目规范的结构化注释。系统基于AST解析当前函数签名、参数类型、返回值及调用上下文,生成兼容Sphinx/Google/Numpy风格的文档字符串。
1、打开Qoder桌面端,进入当前项目Workspace。
2、点击左上角「Settings」→「Code Documentation」→ 启用「Auto-generate docstrings on save」。
3、在下拉菜单中选择目标注释格式,例如Google Style。
4、勾选「Sync with Repo Wiki」选项,确保每次保存后注释内容实时同步至Wiki知识图谱节点。
二、配置QoderWake任务流触发式注释补全
此方式将注释生成嵌入日常开发任务链,当QoderWake执行代码修改、重构或新增功能时,自动插入语义对齐的注释块,避免人工遗漏。
1、在Quest视图中新建一个任务,输入目标描述如:“重构user_auth模块,增强token校验逻辑”。
2、在任务设置中展开「Post-action hooks」,点击「Add hook」→ 选择「Insert standardized docstring」。
3、指定注释模板来源:可选用项目根目录下的.qoder/docstyle.yaml文件,或直接引用团队知识引擎中的已审核模板ID。
4、提交任务后,QoderWake将在所有被修改函数顶部插入带参数说明、异常标注和示例用法的完整docstring。
三、通过CLI命令批量注入历史代码注释
针对存量无注释代码库,本方法支持离线扫描并按函数粒度生成高质量注释,输出结果可预览确认后再写入源码,保障代码安全性与可追溯性。
1、在项目根目录终端执行:qoder repo wiki --annotate --scope=function --dry-run,查看拟生成注释的函数列表及置信度评分。
2、确认无误后运行:qoder repo wiki --annotate --scope=function --write,启动批量注入。
3、系统将自动跳过已有完整docstring的函数,并对低置信度项标记[NEED_REVIEW]标签,便于人工复核。
4、注入完成后,执行git diff --no-index docs/annotated_summary.md /dev/null,获取本次注释覆盖范围报告。
四、绑定Git Pre-commit Hook强制注释校验
该配置使QoderWake成为代码准入守门员,任何未附带有效docstring的新函数或公开方法在提交前将被拦截,并提示补全建议,从而将文档习惯固化为工程纪律。
1、在项目根目录运行:qoder git hook install --pre-commit,自动注册校验脚本。
2、校验规则默认启用:public method、exported function、class definition三类元素必须含非空docstring。
3、若检测失败,终端将显示缺失位置及推荐注释片段,例如:def calculate_fee(...) → missing docstring; suggested: "Calculates final fee after tax and discount"。
4、开发者可键入qoder fix --auto一键补全全部缺失项,或手动编辑后重试提交。
到这里,我们也就讲完了《QoderWake自动生成注释:养成高效文档习惯》的内容了。个人认为,基础知识的学习和巩固,是为了更好的将其运用到项目中,欢迎关注golang学习网公众号,带你了解更多关于的知识点!
 爱发电怎么设置专属内容?
- 上一篇
- 爱发电怎么设置专属内容?
- 下一篇
- 拼多多订单无法取消?取消失败解决方法
-
- 科技周边 · 人工智能 | 9小时前 | API · 人工智能 · vLLM max_tokens 推理服务
- vLLM 怎样为在线服务设置请求最大 Token 数
- 326浏览 收藏
-
- 科技周边 · 人工智能 | 9小时前 | 人工智能 · 评估指标 MLFlow 模型版本 Model Registry 机器学习实验
- MLflow 怎样记录模型版本和评估指标
- 313浏览 收藏
-
- 科技周边 · 人工智能 | 9小时前 | 人工智能 · Profiling ONNX Runtime 算子耗时 推理性能 JSON trace
- ONNX Runtime 怎样生成算子级延迟 profiling JSON
- 178浏览 收藏
-
- 科技周边 · 人工智能 | 9小时前 |
- LlamaIndex 怎样把元数据加入向量检索过滤
- 334浏览 收藏
-
- 科技周边 · 人工智能 | 9小时前 |
- LangChain 怎样为工具调用保留中间消息
- 450浏览 收藏
-
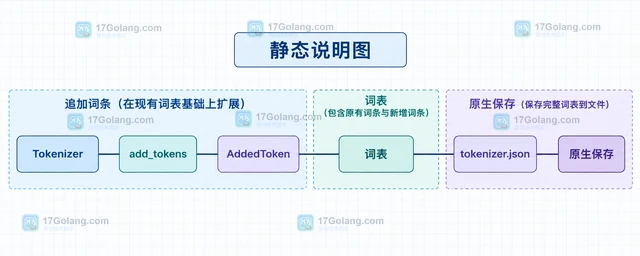
- 科技周边 · 人工智能 | 9小时前 | 自定义词表 tokenizer Hugging Face Tokenizers tokenizer.json
- Hugging Face Tokenizers 怎样保存自定义词表
- 311浏览 收藏
-
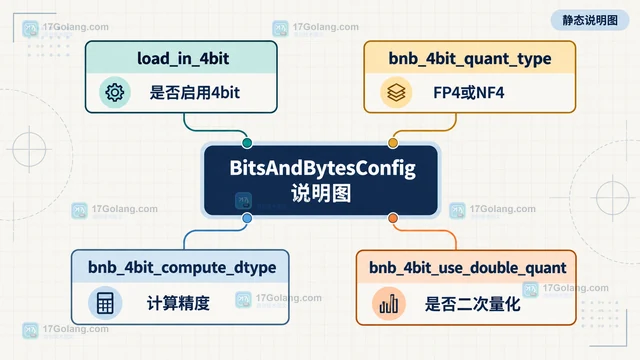
- 科技周边 · 人工智能 | 9小时前 | Transformers bitsandbytes BitsAndBytesConfig 4bit量化
- BitsAndBytesConfig 怎样查看 4bit 量化参数
- 205浏览 收藏
-
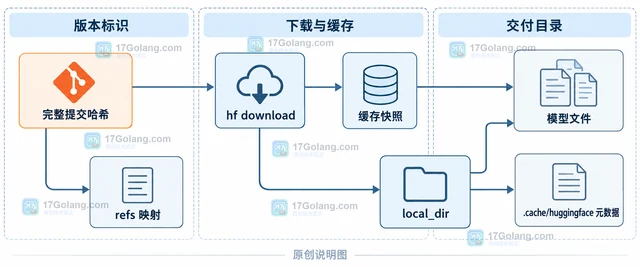
- 科技周边 · 人工智能 | 9小时前 | 缓存 · snapshot_download Hugging Face Hub hf_hub_download revision
- Hugging Face Hub 怎样下载指定提交版本的模型文件
- 415浏览 收藏
-
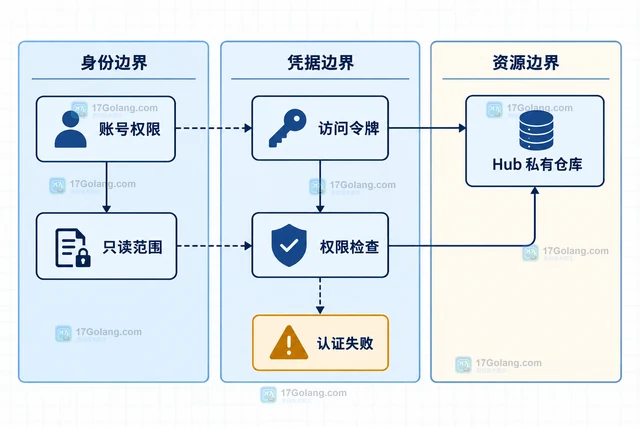
- 科技周边 · 人工智能 | 9小时前 |
- Hugging Face Hub 怎样为私有模型配置访问令牌
- 127浏览 收藏
-
- 科技周边 · 人工智能 | 9小时前 |
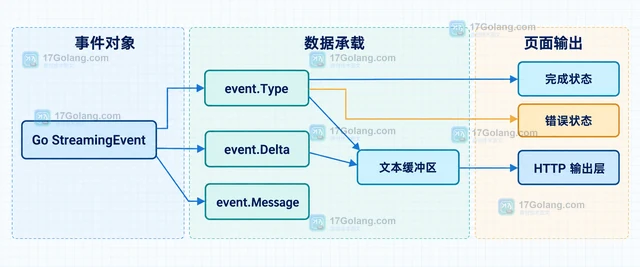
- OpenAI API 流式响应怎样按事件类型更新界面
- 228浏览 收藏
-
- 科技周边 · 人工智能 | 9小时前 |
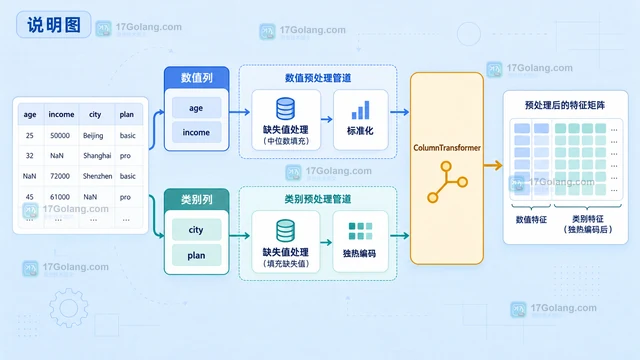
- scikit-learn ColumnTransformer 怎样让数值与类别特征分别预处理
- 459浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 769次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 766次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 847次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 817次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 646次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览


