
大文件处理卡顿怎么办?硬件优化技巧
2026-05-16 22:31:20
0浏览
收藏
面对大文件处理卡顿,关键不在盲目更换编辑器或工具,而在于精准调优VS Code配置、善用命令行利器(如rg/awk)替代低效操作、采用流式读取策略避免内存爆炸,并正视硬件瓶颈——16GB内存加NVMe SSD是实用底线,频繁swap才是隐藏的性能杀手;掌握这些针对性优化,几百MB甚至GB级日志与数据文件也能流畅处理。

用 vscode 打开几百MB的文件卡死,该换编辑器还是调设置?
直接换编辑器不是最优解——vscode 本身支持大文件轻量加载,但默认关闭。卡死主因是它试图构建完整语法树、启用搜索索引、触发 LSP 语言服务,这些对 log、jsonl、csv 类文件完全没必要。
实操建议:
- 打开命令面板(
Ctrl+Shift+P/Cmd+Shift+P),运行Preferences: Open Settings (JSON),在配置里加:"files.maxMemoryForLargeFilesMB": 4096,
"editor.largeFileOptimizations": true,
"search.followSymlinks": false,
"search.exclude": {"**/*.log": true} - 对单个超大文件,右键 →
Open Without Extensions,禁用所有插件(尤其 YAML/JSON 格式化、GitLens 等常驻解析类扩展) - 确认没启用
editor.wordWrap或editor.renderWhitespace,这两项在百万行级文件中会显著拖慢渲染
less 和 tail -f 真的够用?什么时候必须上 rg 或 awk?
纯查看、滚动、找末尾日志,less 和 tail -f 足够快且内存零压力;但一旦要「按字段过滤」「统计出现次数」「提取某列再去重」,它们就力不从心了——less 不支持管道后处理,tail -f 无法回溯。
实操建议:
- 查关键词并高亮:用
rg "ERROR" huge.log,比grep快 5–10 倍,且默认跳过二进制内容 - 看最后 1000 行并实时追加:
tail -n 1000 -f huge.log | rg "timeout",避免把整个文件读进内存再过滤 - 按第 3 列统计错误码:
awk '{print $3}' huge.log | sort | uniq -c | sort -nr | head -20,注意用$3而非$NF,防止日志格式变动导致取错列
Python 读大文件报 MemoryError 或卡住,是不是该换 pandas?
不该。用 pandas.read_csv() 直接读几个 GB 的 CSV 是最常见踩坑点——它默认加载全量到内存、推断类型、建 DataFrame,比原生 Python 还容易崩。真正该做的是绕过「一次性加载」这个动作。
实操建议:
- 逐块读:
pandas.read_csv("big.csv", chunksize=50000),然后用for chunk in reader:处理,每块独立 GC - 纯文本行处理,用生成器:
def read_in_chunks(file_path, chunk_size=8192):
,避免
with open(file_path) as f:
while True:
lines = f.readlines(chunk_size)
if not lines:
break
yield from linesf.read()或list(f) - 确认没误用
json.load(f)读巨量jsonl文件——该用for line in f:+json.loads(line)
SSD 和内存不够时,哪些操作会悄悄变慢?
不是所有“卡”都来自 CPU。当物理内存不足,系统会把部分进程页换出到磁盘(swap),而机械硬盘 swap 一次 IO 就是 10ms 起步,SSD 也要 0.1ms —— 这意味着一个 grep 可能等 2 秒才出结果,你以为是命令慢,其实是被换页卡住。
实操建议:
- 用
free -h看available是否长期低于 1GB;用swapon --show确认是否启用了 swap - 临时禁用 swap:
sudo swapoff -a(仅测试用,重启后恢复),观察大文件操作是否明显提速 - 处理 >500MB 文件时,避免同时开 Chrome、Docker Desktop、IntelliJ 等吃内存大户——它们不会提示你“我正在抢你的 page cache”
硬件上,16GB 内存 + NVMe SSD 是当前处理 1–2GB 日志/数据文件的实用下限;如果常碰 5GB+ 文件,别省那几百块,上 32GB 内存,swap 压力会断崖下降。
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《大文件处理卡顿怎么办?硬件优化技巧》文章吧,也可关注golang学习网公众号了解相关技术文章。
 Scikit-learn多分类:OvR与OvO对比解析
- 上一篇
- Scikit-learn多分类:OvR与OvO对比解析

- 下一篇
- 跨PPT统一背景风格技巧
查看更多
最新文章
-
- 文章 · 前端 | 1小时前 |
- 表单 aria-describedby 关联错误提示的可访问设计
- 349浏览 收藏
-
- 文章 · 前端 | 11小时前 | 前端 · css · 组合选择器 CSS :is specificity :where 级联层
- CSS :is 组合选择器时的 specificity 控制
- 327浏览 收藏
-
- 文章 · 前端 | 23小时前 | javascript · DNS耗时 PerformanceResourceTiming TLS耗时
- PerformanceResourceTiming 拆分 DNS 与 TLS 耗时
- 108浏览 收藏
-
- 文章 · 前端 | 3天前 | 前端 · websocket ·
- WebSocket 重连退避与页面卸载的收尾
- 381浏览 收藏
-
- 文章 · 前端 | 3天前 |
- Fetch keepalive 处理页面卸载前的小请求
- 291浏览 收藏
-
- 文章 · 前端 | 3天前 |
- CSS @scope 限定组件样式作用域的迁移方法
- 294浏览 收藏
-
- 文章 · 前端 | 3天前 |
- View Transition API 在 SPA 状态切换中的降级方案
- 142浏览 收藏
-
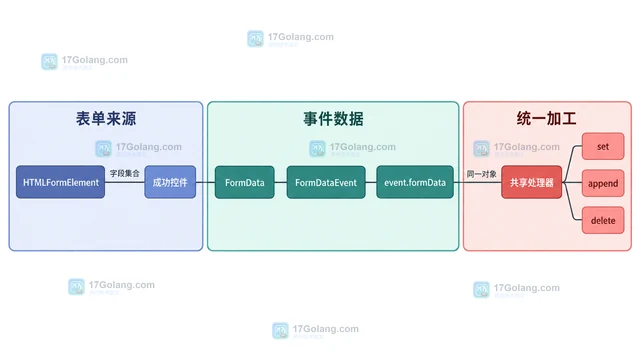
- 文章 · 前端 | 3天前 | javascript · 表单 · FormData FormDataEvent formdata事件 原生表单
- FormDataEvent 统一拦截原生表单数据的实现
- 288浏览 收藏
-
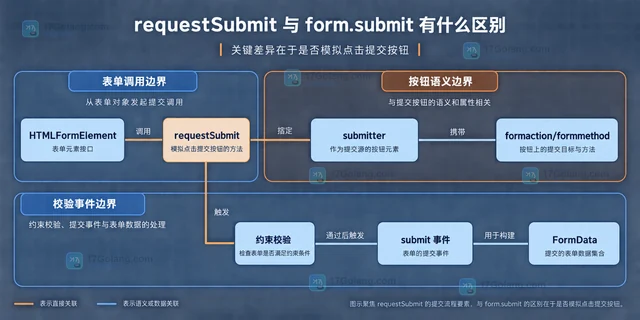
- 文章 · 前端 | 4天前 | html · javascript · 表单 · requestSubmit form.submit HTML表单校验
- requestSubmit 与 form.submit 有什么区别
- 392浏览 收藏
-
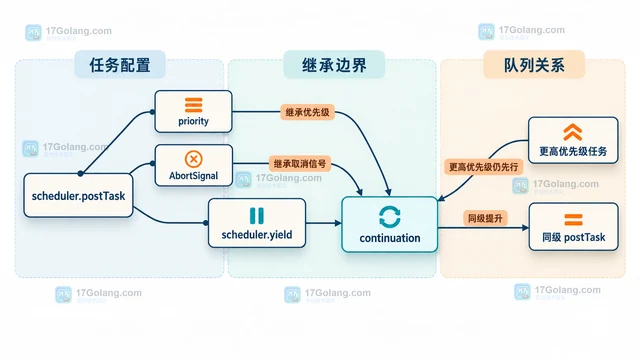
- 文章 · 前端 | 4天前 |
- scheduler.yield 怎么把长任务拆开又保持优先级
- 110浏览 收藏
-
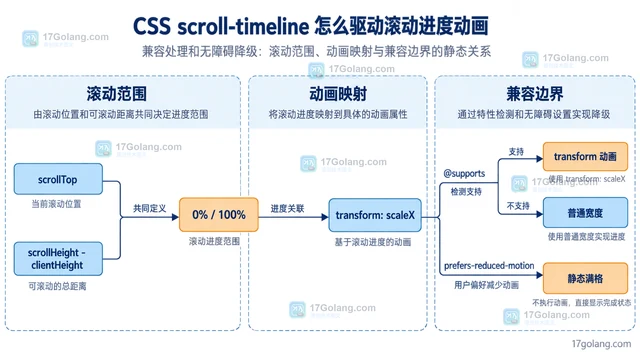
- 文章 · 前端 | 4天前 | CSS 滚动动画 animation-timeline scroll-timeline
- CSS scroll-timeline 怎么驱动滚动进度动画
- 251浏览 收藏
-
- 文章 · 前端 | 4天前 |
- IntersectionObserver scrollMargin 怎么处理嵌套滚动容器
- 380浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 300次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 356次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 355次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 322次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 141次使用
查看更多
相关文章
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


