
Perplexity AI如何深入追问?多轮对话技巧全解析
Perplexity AI的真正威力不在首轮泛泛而答,而在于你能否用一套精密的五步追问法——聚焦子维度、嵌入校验反问、绑定角色与任务、构建结构化追问链、插入语义锚点词——持续撬动它的深层推理引擎;掌握这套方法,你就能把模糊结论转化为可验证的技术推导、将宽泛描述升级为带行号的源码级补丁、让AI从“知道一点”跃迁到“专业交付”,真正把Perplexity用成你的智能科研搭档而非高级搜索引擎。

如果您在Perplexity AI中获得初步回答后,发现信息仍不够深入、具体或缺乏关键细节,则说明尚未激活其多轮对话的深层推理能力。以下是实现有效追问与持续深化的实操路径:
一、锁定主干结论后立即聚焦子维度
首轮回答常提供概括性结论,追问需锚定其中某一可拆解要素,强制模型收缩注意力至技术机制、时间范围、主体角色等具体切口,避免泛化重复。
1、识别回答中出现的术语、数据、方法名称或限定条件,例如“RoPE位置编码”“截至2025年Q4”“从编译器开发者视角”。
2、选取其中一个要素作为追问支点,构造新问题,如:“请聚焦旋转矩阵的复数空间映射过程,用公式说明其如何保持相对距离不变性。”
3、确保新问题中不重复首轮主干句式,而是以“请聚焦……”“请用……说明……”“请对比……差异”等指令性短语开头。
二、嵌入校验型反问触发逻辑自检
模型可能在首轮输出中隐含推理漏洞或默认假设,通过引入反事实、边界条件或量化验证要求,可迫使其回溯推导链并暴露薄弱环节。
1、在追问中设置可验证前提,例如:“若将RoPE的θ基底设为线性增长而非几何衰减,会对长程注意力坍缩产生何种可量化影响?”
2、要求模型输出可比对指标,如延迟数值、错误率变化、FLOPs增幅等,而非仅描述性判断。
3、添加约束词“不涉及OpenAI或Anthropic闭源模型”“仅对比Llama 3-70B与Qwen2-72B”,排除干扰信源,压缩推理噪声面。
三、调用角色-任务双绑定指令重定向输出框架
当追问仍流于表面时,需同时指定专业角色与交付物类型,使模型切换至对应知识结构与表达范式,突破通用语言模型的表达惯性。
1、明确角色,如“从CUDA Graph调度器内核开发者视角”“以arXiv审稿人身份”。
2、同步定义交付形式,如“生成可直接插入论文Method部分的段落”“输出含行号的PyTorch 2.5源码级补丁注释”。
3、组合指令,例如:“以H100显卡固件工程师身份,指出CUDA Graph在动态shape输入下的三处潜在hang点,并标注对应NVIDIA驱动版本号及规避方案。”
四、启用上下文继承的结构化追问链
Perplexity支持会话级上下文延续,但需避免语义漂移;采用编号分层方式显式标记追问层级,可维持逻辑树状结构,防止模型丢失原始问题锚点。
1、首轮提问末尾添加标记,如“【主干问题】Transformer中RoPE的核心优势是什么?”
2、第二轮开头复述标记并升级粒度:“【追问1】请基于【主干问题】,推导θ基底衰减系数λ对序列长度外推误差的函数关系。”
3、第三轮延续编号并引入变量控制:“【追问2】请基于【追问1】,固定λ=10000,计算当序列长度从2048扩展至131072时,角度偏移累积误差的理论上限。”
五、插入语义锚点词强化向量检索精度
单靠自然语言追问易导致检索信号衰减,需在每轮问题中嵌入1–3个领域强相关术语,重建向量空间中的高密度语义簇,提升信源召回质量。
1、从首轮回答中提取3个核心术语,如“flashattention-3”“kv cache compression”“tensor parallelism”。
2、将术语自然融入追问句式,例如:“请结合flashattention-3的kernel fusion机制与kv cache compression的bit-width敏感性,分析其在Qwen2-72B推理中的显存带宽瓶颈。”
3、避免术语堆砌,确保每个术语均承担明确的逻辑功能——或限定技术路径、或定义评估维度、或指明对比对象。
今天带大家了解了的相关知识,希望对你有所帮助;关于科技周边的技术知识我们会一点点深入介绍,欢迎大家关注golang学习网公众号,一起学习编程~
 电脑定时关机设置方法及CMD命令教程
- 上一篇
- 电脑定时关机设置方法及CMD命令教程

- 下一篇
- Windows重启后软件自动打开怎么关?
-
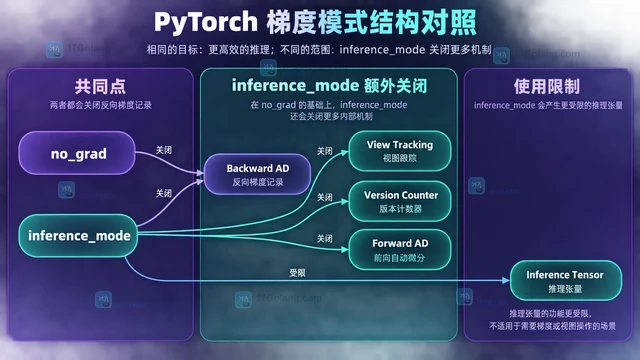
- 科技周边 · 人工智能 | 4小时前 | 人工智能 · PyTorch 模型推理 inference_mode no_grad
- PyTorch inference_mode 与 no_grad 有什么区别
- 458浏览 收藏
-
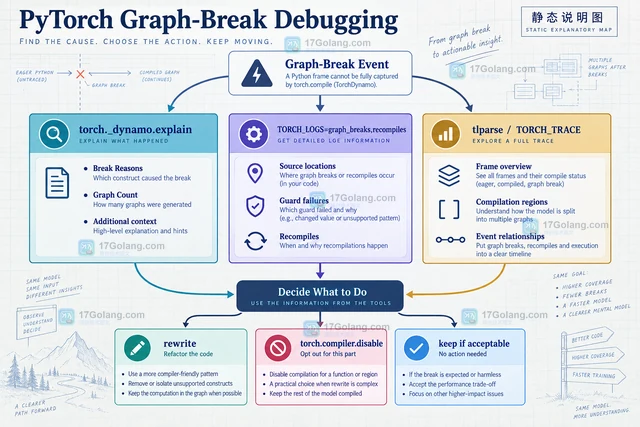
- 科技周边 · 人工智能 | 8小时前 |
- PyTorch compile 出现 graph break 怎么定位
- 478浏览 收藏
-
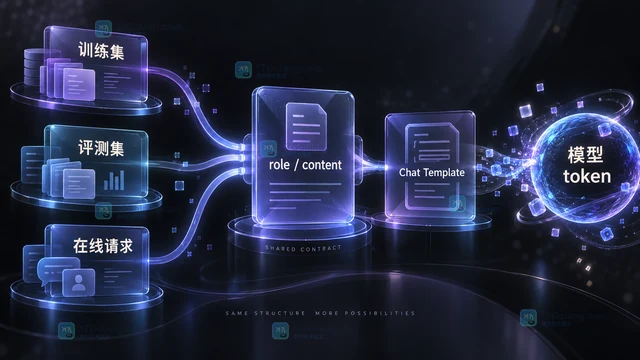
- 科技周边 · 人工智能 | 10小时前 | 人工智能 · Transformers chat template apply_chat_template 对话模型
- Transformers Chat Template 怎么避免角色格式不一致
- 477浏览 收藏
-
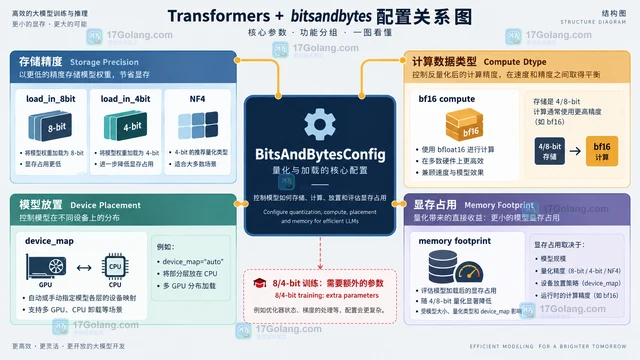
- 科技周边 · 人工智能 | 13小时前 |
- Transformers 量化配置怎么选择 int8 与 int4
- 113浏览 收藏
-
- 科技周边 · 人工智能 | 17小时前 | python · 人工智能 · Bootstrap 模型评估 置信区间 Hugging Face Evaluate
- Hugging Face Evaluate 怎么为指标计算置信区间
- 438浏览 收藏
-
- 科技周边 · 人工智能 | 6天前 |
- AI Agent工具调用设置超时与幂等键的执行边界
- 305浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 234次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 278次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 247次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 229次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 29次使用
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览
-
- Canva手机闪退解决方法及适配指南
- 2026-05-25 501浏览