
AI卡皮巴拉中文优化评测及语言能力分析
本文深入剖析了AI卡皮巴拉在中文场景下的真实语言能力短板,直击语法生硬、语义漂移、文化失语、语音违和、专业误读五大痛点,通过可复现的实测方法——从“CPU干烧了”等网络热词响应到“破五迎财神”的民俗理解,从瑞幸指代追踪到北交所问询函解析——揭示其底层模型对中文语境、语用习惯与社会知识的覆盖缺陷;无论你是日常用户、本地生活服务使用者,还是金融医疗等垂直领域从业者,都能从中快速定位自身遇到的表达异常根源,并获得具象化、可操作的验证路径。

如果您在使用AI卡皮巴拉相关应用或模型时发现中文表达生硬、语义错位、文化适配不足,可能是由于其底层语言模型对中文语境、网络用语、地域表达及语用习惯的覆盖不充分。以下是针对AI卡皮巴拉中文优化效果的实测分析与验证方法:
一、语法结构与句式自然度检测
该方法用于评估AI卡皮巴拉生成中文时是否符合母语者日常表达逻辑,避免直译式欧化句式(如过度使用“的”字链、被动语态堆砌、主谓宾断裂等)。重点观察其在对话响应、文案生成、指令理解等场景下的句法连贯性。
1、在支持文本输入的卡皮巴拉界面中,连续输入三类典型中文指令:口语化短句(如“帮我订明天中午的外卖”)、带地域特征表达(如“这事儿整得挺溜啊”)、含隐喻/谐音的网络用语(如“我直接CPU干烧了”)。
2、记录每条响应中是否存在语序倒置、成分缺失、助词误用(如“了”“过”“着”的混淆)或强行补全导致语义偏移。
3、将响应结果与人工润色版本并列比对,标注出出现“被字句泛滥”“量词搭配错误(如‘一个建议’而非‘一条建议’)”“语气词缺失导致生硬感”的具体位置。
二、语义理解与上下文一致性验证
该方法聚焦AI卡皮巴拉在多轮交互中维持中文语义锚点的能力,尤其检验其对代词指代、省略结构、话轮承接及潜台词识别的稳定性,防止因上下文建模薄弱导致答非所问或逻辑断层。
1、构造一组含嵌套指代的对话序列,例如:“我刚买了杯瑞幸,它家新品真不错。你觉得它下周会上新吗?”——其中“它”需准确绑定至“瑞幸”,而非泛指前文任意名词。
2、在第三轮故意插入干扰信息:“隔壁星巴克也出了新品。”观察第四轮回应是否仍能正确回溯并延续“瑞幸”主线,或发生主体漂移。
3、统计五组同类测试中指代歧义未消解次数超过2次、省略成分误补率达40%以上、跨轮话题断裂达3次及以上的情形。
三、文化适配与本地化表达还原度测试
该方法检验AI卡皮巴拉是否具备中文社会语境感知能力,包括节气习俗、政务用语规范、商业话术惯例、方言借词接受度及敏感词规避策略,而非仅依赖字面翻译映射。
1、输入含强文化负载的短语,如“破五迎财神”“双随机一公开”“咱妈说这瓜保熟”,观察其解释是否脱离民俗背景、政策语境或家庭话语体系。
2、向其提问涉及本地生活服务的问题:“北京朝阳区高碑店附近有没有能刷医保的牙科?”核查其是否调用真实POI数据结构,还是仅拼接关键词生成虚构地址。
3、识别响应中是否存在将“内卷”直译为“inner roll”式拼音残留、对“绝绝子”等Z世代语汇无反应或机械复述、误将“老铁”判定为年龄称谓而非网络亲密称呼等现象。
四、语音交互中的中文韵律与语用匹配度评估
该方法适用于搭载TTS模块的卡皮巴拉终端设备,检测其合成语音在声调准确性、轻重音分布、停顿节奏及情感语气词(如“哈”“呀”“呗”)使用上是否贴合真实中文口语流变规律。
1、播放同一段文字:“你确定要删除全部聊天记录吗?”分别启用默认语音与“北京青年”“广东粤语播音腔”等风格选项,对比基频曲线与自然人录音的梅尔频谱重合度。
2、在用户说出“算了,不用了”后,观察AI是否触发放弃确认流程,而非继续推进操作;若响应为“好的,已取消”,则检查其语调是否同步降调收束,而非保持升调疑问式尾音。
3、标记所有出现阴平调值偏低致“妈”读如“麻”、去声未充分下压致“是”近似“试”、句末“吧”字缺失导致命令感过强的语音样本。
五、专业领域术语与行业黑话兼容性筛查
该方法面向垂直场景使用者,验证AI卡皮巴拉在金融、医疗、教育、政务等中文高频专业场域中,能否准确识别术语缩略形式、行话隐喻及合规表述边界,避免常识性误判或风险话术输出。
1、输入组合型术语指令:“帮我查下北交所上市委第28次审议会议结果,重点关注中集环科的问询函回复要点。”检查其是否解析“北交所”“上市委”“问询函”三级概念层级,而非仅提取“中集环科”作单一实体检索。
2、输入黑话测试句:“这个需求颗粒度太粗,需要先对齐OKR再拆解story point。”观察其是否识别“颗粒度”“对齐”“OKR”“story point”为敏捷开发语境专有表达,而非按字面释义。
3、记录其在响应中是否出现将“穿透式监管”误解为物理探测、把“白名单”等同于普通推荐列表、对“不可抗力”出具非法律效力解释等跨域误读案例。
今天关于《AI卡皮巴拉中文优化评测及语言能力分析》的内容就介绍到这里了,是不是学起来一目了然!想要了解更多关于的内容请关注golang学习网公众号!
 HTML如何制作简单价格表
- 上一篇
- HTML如何制作简单价格表

- 下一篇
- 知末网登录入口及素材官网地址
-
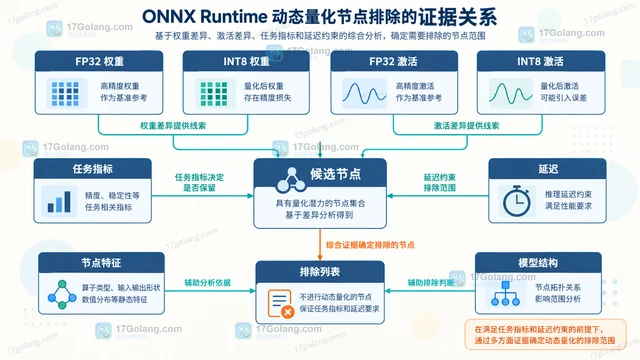
- 科技周边 · 人工智能 | 2小时前 | 人工智能 · 推理优化 ONNX Runtime 动态量化 nodes_to_exclude
- ONNX Runtime 动态量化怎么选择需要排除的节点
- 377浏览 收藏
-
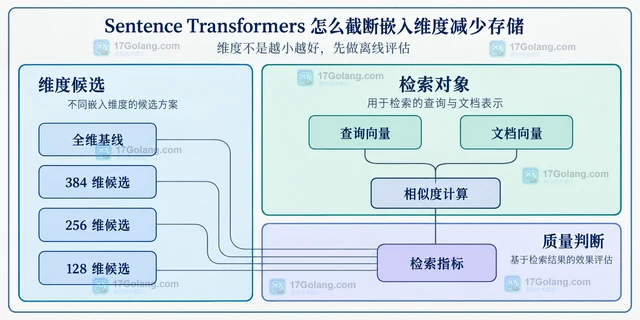
- 科技周边 · 人工智能 | 4小时前 | 人工智能 · 向量检索 · Sentence Transformers truncate_dim 嵌入维度 Matryoshka 向量存储
- Sentence Transformers 怎么截断嵌入维度减少存储
- 165浏览 收藏
-
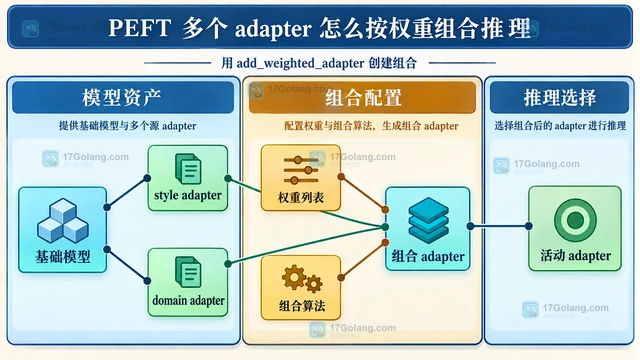
- 科技周边 · 人工智能 | 6小时前 |
- PEFT 多个 adapter 怎么按权重组合推理
- 454浏览 收藏
-
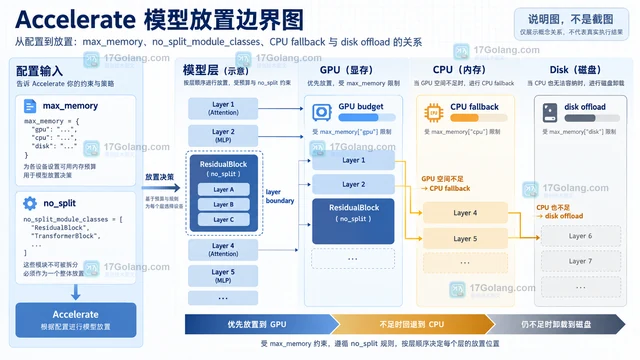
- 科技周边 · 人工智能 | 9小时前 |
- Accelerate 大模型推理怎么自动分配到多块设备
- 358浏览 收藏
-
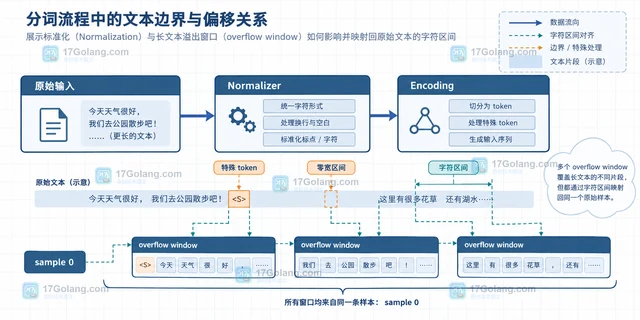
- 科技周边 · 人工智能 | 11小时前 | 人工智能 · Tokenizers offset_mapping 原始文本
- Tokenizers offset mapping 怎么映射回原始文本位置
- 328浏览 收藏
-
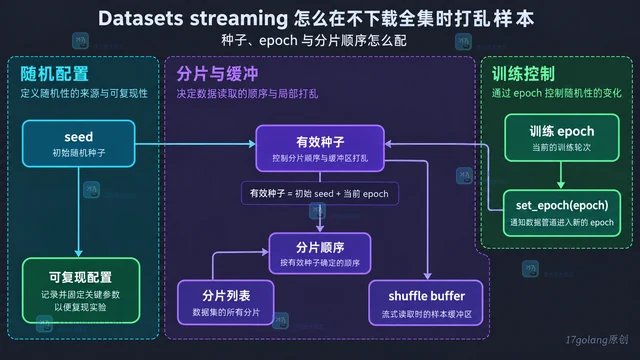
- 科技周边 · 人工智能 | 13小时前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size
- Datasets streaming 怎么在不下载全集时打乱样本
- 470浏览 收藏
-
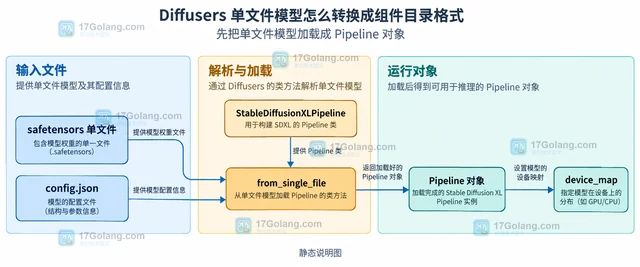
- 科技周边 · 人工智能 | 21小时前 |
- Diffusers 单文件模型怎么转换成组件目录格式
- 308浏览 收藏
-
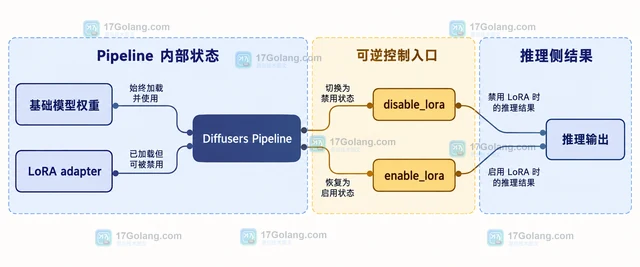
- 科技周边 · 人工智能 | 1天前 | 人工智能 ·
- Diffusers 怎么临时禁用 LoRA 但保留已加载权重
- 309浏览 收藏
-
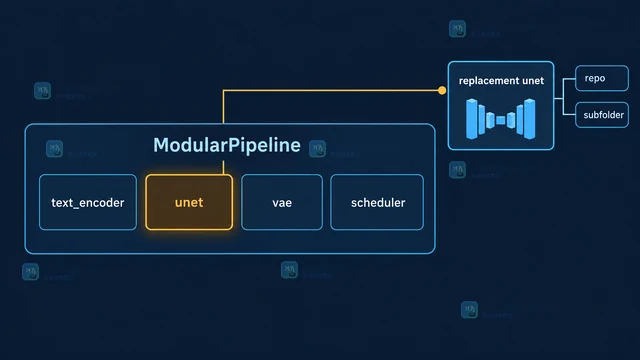
- 科技周边 · 人工智能 | 1天前 | 人工智能 · diffusers ModularPipeline update_components ComponentSpec 模型组件
- Diffusers ModularPipeline 怎么替换单个模型组件
- 175浏览 收藏
-
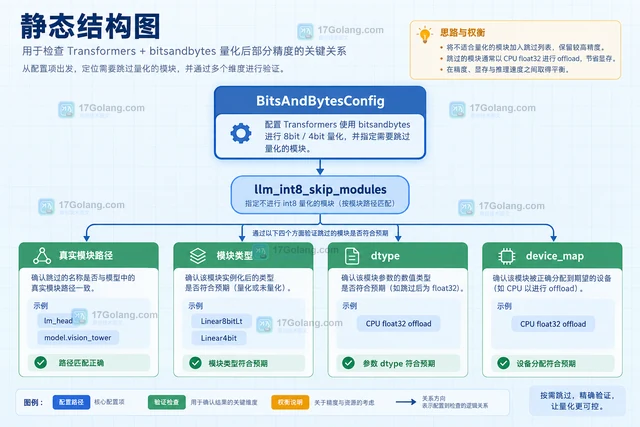
- 科技周边 · 人工智能 | 1天前 |
- Transformers bitsandbytes 量化后怎么保留部分模块精度
- 359浏览 收藏
-
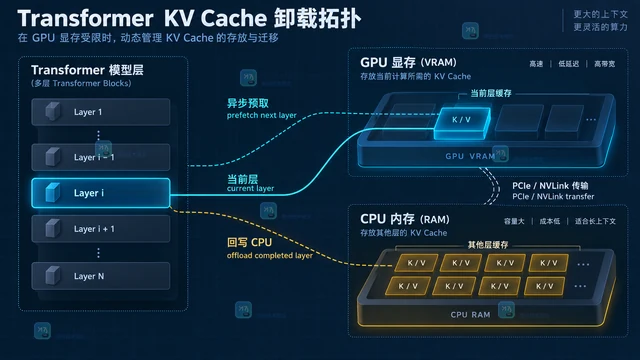
- 科技周边 · 人工智能 | 1天前 | 人工智能 · Transformers 大模型推理 KV Cache 显存不足 缓存卸载
- Transformers KV cache 怎么在显存不足时启用卸载
- 499浏览 收藏
-
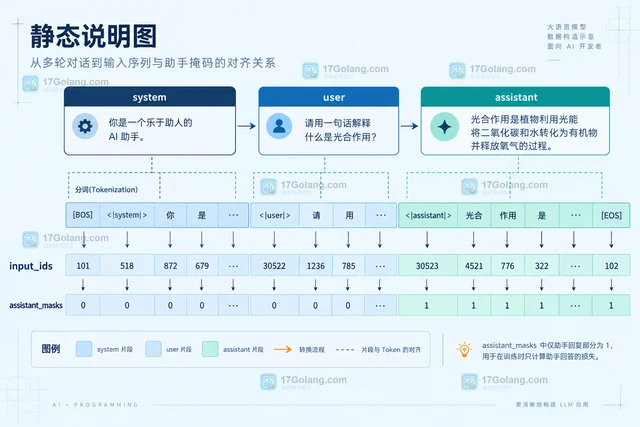
- 科技周边 · 人工智能 | 1天前 |
- Transformers chat template 怎么生成 assistant token 掩码
- 164浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 356次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 416次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 424次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 378次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 201次使用
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览
-
- Canva手机闪退解决方法及适配指南
- 2026-05-25 501浏览


