
Python用RabbitMQ实现微服务通信解耦
本文深入剖析了Python中使用RabbitMQ与Pika实现微服务事件解耦通信时极易被忽视却至关重要的五大生产级难题:自动重连机制缺失导致连接雪崩、fanout交换器因声明或绑定不全引发消息静默丢失、死信队列(DLX)因参数错配或类型不兼容而形同虚设、BlockingConnection在高并发下因同步阻塞和QoS失当造成CPU虚高吞吐低下,以及缺乏端到端可追溯性导致故障排查如盲人摸象;文章不讲原理堆砌,直击线上真实踩坑现场——从心跳超时配置、virtual_host拼写陷阱,到routing_key为空字符串的硬性要求、DLX转发条件的精确触发逻辑,再到用basic.get和firehose trace让每条消息“有迹可循”,帮你避开那些凌晨三点还在日志里大海捞针的致命坑。

RabbitMQ + Pika 实现事件解耦,核心不是“能不能做”,而是“连接要不要自动重连”“消息会不会悄无声息丢掉”“死信队列的 routing key 为什么总对不上”——这几个问题不提前踩准,上线后查日志能盯到凌晨。
如何用 pika.BlockingConnection 建立带重连的可靠连接
默认的 pika.BlockingConnection 在网络抖动或 RabbitMQ 重启时会直接抛 ConnectionClosedByBroker 或卡死,不重连。必须自己包一层重试逻辑,且不能无脑 while True 循环(会夯住线程)。
- 用
connection_params = pika.ConnectionParameters(heartbeat=60, blocked_connection_timeout=30)显式设心跳和阻塞超时,否则连接空闲几分钟后可能被中间设备静默断开 - 建立连接前先检查
credentials和virtual_host是否拼错,错误会表现为ProbableAuthenticationError或ChannelClosedByBroker,但错误信息里不提 virtual_host - 推荐封装成函数,捕获
pika.exceptions.AMQPConnectionError后 sleep 1–3 秒再重试,最多试 5 次;超过就该报警而不是继续等
发布订阅模式下,为什么 fanout exchange 的消息收不到
fanout 是最简单的广播模式,但常见问题是:发了消息,消费者却没收到——往往不是代码写错,而是 exchange 或 queue 没声明对,或者 binding 被漏掉。
- 必须确保生产者和消费者都调用
channel.exchange_declare(exchange='event.fanout', exchange_type='fanout'),哪怕只是“确认存在”。RabbitMQ 不会自动创建未声明的 exchange - 消费者端必须调用
channel.queue_declare(queue='', exclusive=True)获取随机队列名,再用channel.queue_bind()绑定到 exchange;如果手写固定 queue 名但没 bind,消息就进黑洞 - 发布时别漏掉
exchange参数:channel.basic_publish(exchange='event.fanout', routing_key='', body=data),fanout 下routing_key必须为空字符串,填了反而报错
配置死信队列(DLX)时,x-dead-letter-exchange 不生效的典型原因
DLX 不是开个开关就自动转发,它依赖三处显式配置全部对齐:queue 声明参数、消息 TTL、以及死信 exchange 本身存在且类型匹配。
- 声明主队列时必须传完整参数:
channel.queue_declare(queue='order.process', arguments={'x-dead-letter-exchange': 'dlx.events', 'x-dead-letter-routing-key': 'failed.order'});漏掉arguments字典或 key 写成x-dead-letter-exchange-type都无效 - 死信 exchange(如
dlx.events)必须提前声明为topic或direct类型,fanout 不支持 routing key 转发,所以x-dead-letter-routing-key就没意义 - 消息进死信队列需触发条件:要么投递失败(no_ack + channel.close),要么设置了
expiration(单位毫秒)且超时,或队列x-max-length满了被挤出;单靠“消费者 nack”不会进 DLX,除非显式设requeue=False且 broker 版本 ≥ 3.8
pika 处理高并发消费时,为什么 CPU 占用高但吞吐上不去
BlockingConnection 默认是单线程模型,一个 channel 同时只能处理一个 delivery。如果 callback 里做了 requests 请求或 time.sleep,整个 channel 就卡住,后续消息全排队。
- 不要在
on_message_callback里做同步 I/O;用threading.Thread包一层异步处理,或改用pika.SelectConnection(但开发复杂度陡增) - 调用
channel.basic_qos(prefetch_count=1)控制未确认消息数,避免消费者积压太多消息导致内存暴涨;值设太大(如 100)会让 RabbitMQ 持续推送,consumer 处理不过来时消息实际滞留在 client 内存里 - 确认消息要用
channel.basic_ack(delivery_tag=method.delivery_tag),别漏掉;漏了会导致 unack 消息堆积,RabbitMQ 最终拒绝新投递
真正难的不是写出能跑通的 demo,而是让每条消息都有迹可循:发出去有没有被 broker 接收?入队后有没有被 consumer 拉走?失败时是否进了死信队列并留有完整 header?这些得靠 basic.get 查队列头、开 firehose trace、或加 delivery_mode=2 持久化来交叉验证——不然线上出问题,你连“消息到底在哪丢的”都得靠猜。
以上就是《Python用RabbitMQ实现微服务通信解耦》的详细内容,更多关于的资料请关注golang学习网公众号!
 MacOS安装WorkBuddy为何要密码?
- 上一篇
- MacOS安装WorkBuddy为何要密码?

- 下一篇
- 批改网修改个人信息步骤详解
-
- 文章 · python教程 | 1天前 | 日志 · 标准库 · python · 工程实践 · Python logging request_id LogRecord setLogRecordFactory
- Python logging.setLogRecordFactory 怎样统一注入关联字段
- 306浏览 收藏
-
- 文章 · python教程 | 1天前 | python · 异步编程 · Python asyncio TaskGroup asyncio.create_task
- Python asyncio.create_task 怎样保存任务引用避免提前回收
- 296浏览 收藏
-
- 文章 · python教程 | 1天前 | 标准库 · 资源管理 · python · Python 上下文管理 contextlib nullcontext
- Python nullcontext 怎样统一可选上下文管理
- 385浏览 收藏
-
- 文章 · python教程 | 1天前 | python · 接口设计 · Python 静态类型检查 typing.Protocol 结构化接口
- Python Protocol 怎样表达结构化接口
- 113浏览 收藏
-
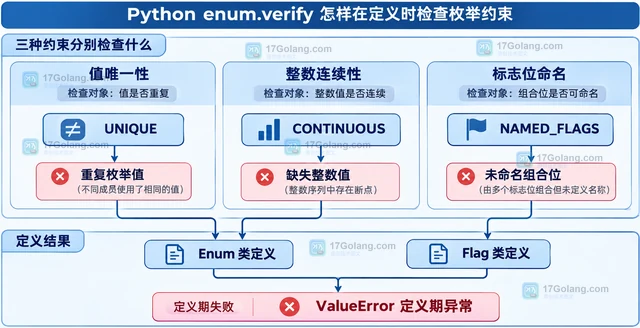
- 文章 · python教程 | 1天前 | 标准库 · 枚举 · Python教程 · Python unique flag enum.verify EnumCheck CONTINUOUS NAMED_FLAGS
- Python enum.verify 怎样在定义时检查枚举约束
- 323浏览 收藏
-
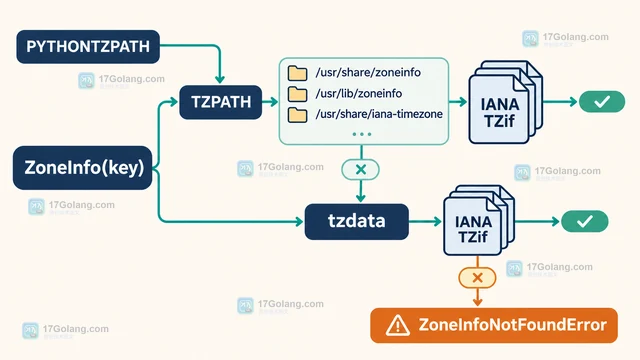
- 文章 · python教程 | 1天前 | Python教程 · 日期时间 · Python zoneinfo TZPATH PYTHONTZPATH 时区数据库
- Python zoneinfo 怎样让进程使用自定义时区数据库
- 135浏览 收藏
-
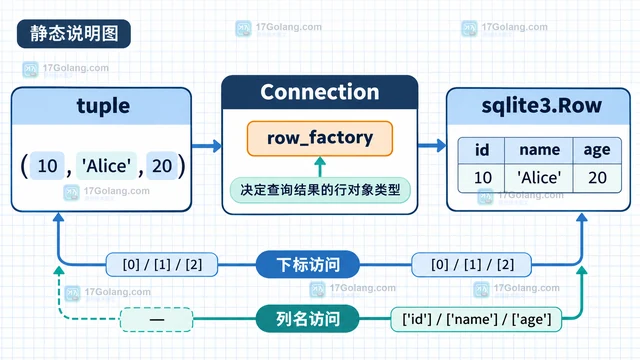
- 文章 · python教程 | 1天前 | SQLite · Python教程 · Python SQLite sqlite3 查询结果 sqlite3.Row row_factory
- Python sqlite3 怎样让查询结果按列名访问
- 265浏览 收藏
-
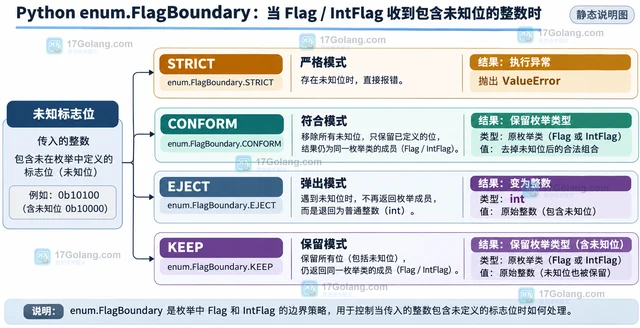
- 文章 · python教程 | 1天前 | Python enum flag 位运算 IntFlag FlagBoundary
- Python enum.FlagBoundary 怎样处理未知标志位
- 476浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python os.splice 怎样在文件描述符之间传输数据
- 156浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python TaskGroup 怎样让子任务失败统一收敛
- 501浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1012次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1017次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1141次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1113次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 958次使用
-
- Python TaskGroup 怎样让子任务失败统一收敛
- 2026-11-12 501浏览
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览


