
Go语言最短路径算法实现详解
2026-04-30 22:33:58
0浏览
收藏
本文深入剖析了在Go语言中高效实现Dijkstra最短路径算法的关键实践与常见陷阱:从必须引入惰性删除(lazy deletion)避免重复入堆导致的严重性能退化,到浮点权重下因精度误差引发的松弛失效及应对策略(如使用epsilon容差和math.Inf(1)初始化);从通过prev数组重建可读路径的工程细节,到邻接表与邻接矩阵的合理选型对稀疏图性能的决定性影响;最终揭示真正拖垮正确性的往往不是算法本身,而是堆中残留旧状态、未校验的浮点比较、遗漏的前驱初始化等隐蔽“幽灵问题”——这些细节,才是让代码从“看似能跑”迈向“稳定可靠”的分水岭。

为什么直接用 container/heap 实现 Dijkstra 容易超时
因为没做 lazy deletion(惰性删除),导致同一节点被重复入堆、反复处理。比如从 A→B 权重 2,A→C 权重 5,C→B 权重 1,那么 B 会被推入堆两次:一次 dist=2,一次 dist=6。但第二次毫无意义——它不会带来更短路径,却白白消耗堆操作和松弛逻辑。
- 每次
heap.Pop()后必须立刻检查:if dist[item.node] - 入堆前不检查是否已更新,只管 push,堆大小会随边数线性膨胀
- 在 500×500 矩阵类图中,未加此判断的实现可能比正确版本慢 3–5 倍
dist初始值建议用math.MaxInt64(整型)或math.Inf(1)(浮点),避免与 0 混淆
float64 权重下 dist[u] + w 为什么有时不触发
浮点精度误差会让本该成立的松弛条件失效。例如理论上 1.1 + 2.2 == 3.3,但实际计算可能是 3.3000000000000003 或 3.2999999999999998,导致比较失败。
- 永远不要用
==判断浮点距离是否“已访问” - 松弛判断应加 epsilon 容忍:
dist[u] + w - 初始化
dist时用math.Inf(1),而非1e300这类手工大数(后者可能溢出或精度丢失) - 若业务允许,优先转为整型权重(如距离 × 100 后四舍五入)
怎么重建从起点到终点的完整路径序列
只算最短距离不够,工程中常需返回具体路径(比如导航要显示“经 A→C→D 到达”)。关键不是存路径本身,而是记录每个节点的前驱(prev)。
- 定义节点结构时加字段:
Prev int(节点 ID)或Prev *Node(指针) - 仅在成功松弛时更新:
if newDist - 回溯路径用循环而非递归,避免栈溢出:
for v != start { path = append(path, v); v = prev[v] },最后再反转 - 若
prev[end] == -1(或 nil),说明不可达,别忘了判空
邻接表 vs 邻接矩阵:选错结构会让 Dijkstra 变慢一倍
稀疏图(如道路网、社交关系)用邻接表是常识,但有人图省事全用二维数组,结果内存爆炸、遍历冗余。
- 邻接表推荐
map[int][]Edge或[]([]Edge),其中Edge含to和weight - 邻接矩阵适合顶点数 O(V²) 存储,哪怕只有 10 条边
- 用
map[int]struct{}做 visited 判断比切片快(尤其顶点 ID 稀疏时),但注意 GC 开销 - 如果图是静态的、多次查询,可预建反向邻接表加速多源场景,但单次 Dijkstra 不需要
真正卡住人的从来不是算法思路,而是堆里残留的旧状态、浮点比较的隐式截断、还有那个忘了初始化的 prev 字段——它们不会报错,只会让结果偶尔对、偶尔不对,查起来像幽灵问题。
到这里,我们也就讲完了《Go语言最短路径算法实现详解》的内容了。个人认为,基础知识的学习和巩固,是为了更好的将其运用到项目中,欢迎关注golang学习网公众号,带你了解更多关于的知识点!
 PerplexityAPI计费延迟问题解析
- 上一篇
- PerplexityAPI计费延迟问题解析

- 下一篇
- 语义导航与ARIA增强写法详解
查看更多
最新文章
-
- Golang · Go教程 | 9小时前 | Go教程 · Go encoding/xml 空元素 指针字段
- Go encoding/xml 空元素与指针字段的处理方式
- 142浏览 收藏
-
- Golang · Go教程 | 9小时前 | Go教程 · Go encoding/xml 字段映射 Unmarshaler
- Go encoding/xml 自定义 Unmarshaler 的字段映射
- 189浏览 收藏
-
- Golang · Go教程 | 10小时前 |
- Go encoding/xml Token 流式读取大型 XML
- 424浏览 收藏
-
- Golang · Go教程 | 10小时前 | go · encoding/json · JSON Go encoding/json omitempty
- Go encoding/json omitempty 对零值字段的输出边界
- 192浏览 收藏
-
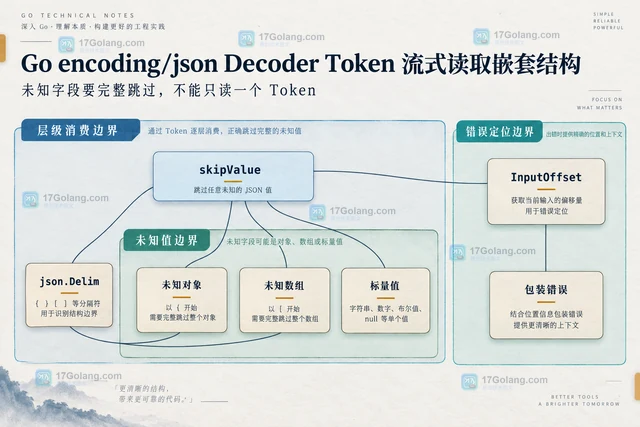
- Golang · Go教程 | 10小时前 |
- Go encoding/json Decoder Token 流式读取嵌套结构
- 364浏览 收藏
-
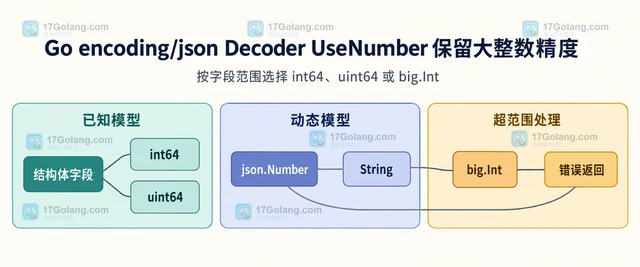
- Golang · Go教程 | 11小时前 |
- Go encoding/json Decoder UseNumber 保留大整数精度
- 328浏览 收藏
-
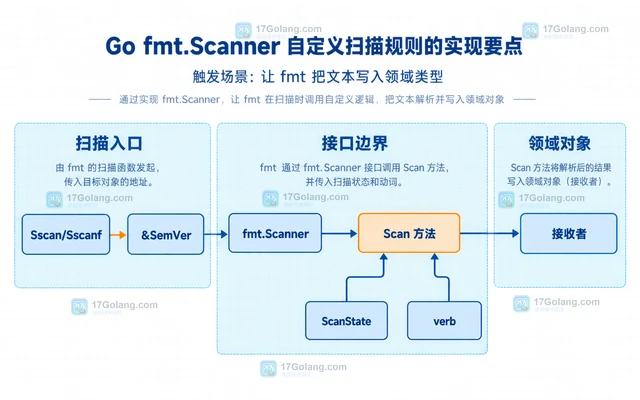
- Golang · Go教程 | 11小时前 |
- Go fmt.Scanner 自定义扫描规则的实现要点
- 182浏览 收藏
-
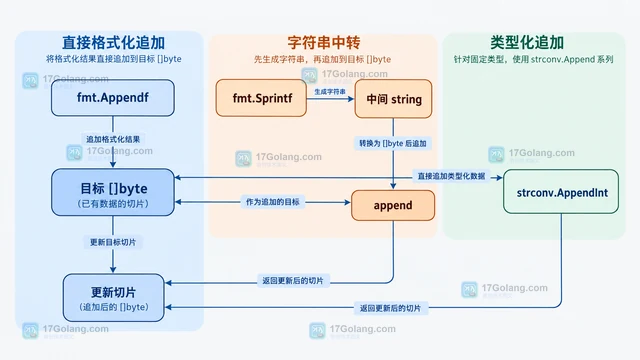
- Golang · Go教程 | 12小时前 |
- Go fmt.Appendf 追加格式化结果的低分配写法
- 478浏览 收藏
-
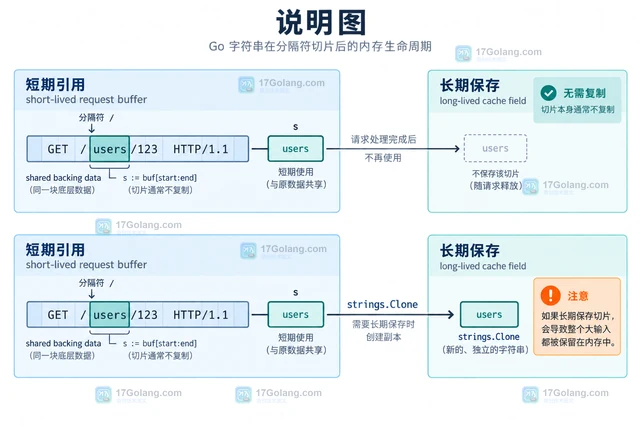
- Golang · Go教程 | 12小时前 |
- Go strings.IndexByte 定位协议分隔符的低分配写法
- 413浏览 收藏
-
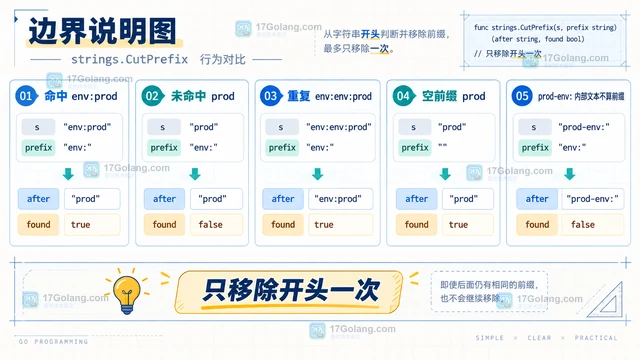
- Golang · Go教程 | 13小时前 | go · Strings · Go 字符串前缀 strings.CutPrefix
- Go strings.CutPrefix 处理可选前缀的分支设计
- 165浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 263次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 311次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 291次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 267次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 80次使用
查看更多
相关文章
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览