
并行回收与标记平衡GC性能
本文深入剖析了现代Java垃圾回收器如何在吞吐量与停顿时间之间实现动态平衡,从CMS因无法处理浮动垃圾和易退化为Serial GC而被淘汰,到G1通过Region划分、Remembered Set和“并发标记+并行复制”架构实现标记与回收解耦,再到ZGC借助染色指针与读屏障将STW压缩至亚毫秒级;同时详解了G1关键参数(如MaxGCPauseMillis、G1HeapRegionSize、MixedGCCountTarget)的调优逻辑与常见误区,揭示了GC演进的本质——不是简单追求更低停顿,而是以可预测性、自适应性和内存管理精度为核心,在复杂业务负载下智能权衡系统响应与资源效率。

为什么 CMS 被淘汰而 G1 成为分水岭
CMS 的 concurrent-mark 阶段虽能并发执行,但无法处理浮动垃圾(floating garbage),且一旦发生 Concurrent Mode Failure 就会退化为 Serial GC 全停顿。G1 把堆划分为 Region,用 Remembered Set 精确跟踪跨区引用,让并发标记(concurrent marking cycle)和并行回收(evacuation)真正解耦——标记阶段只扫描存活对象,回收阶段才决定哪些 Region 要复制、压缩、清理。
关键区别在于:CMS 是“并发标记 + 并发清除”,G1 是“并发标记 + 并行复制”,ZGC/Shenandoah 更进一步把复制也做成并发。
如何配置 G1 实现吞吐与停顿的动态平衡
G1 不靠固定周期触发 GC,而是基于预测模型,在满足 -XX:MaxGCPauseMillis 前提下尽可能少做 GC。但这个目标不是硬性保证,而是统计意义上的概率目标(默认 90% 的暂停 ≤ 设定值)。
-XX:MaxGCPauseMillis=200:设得太低(如 50ms)会导致 GC 频繁、吞吐骤降;设得太高(如 1000ms)则失去低延迟意义-XX:G1HeapRegionSize必须是 2 的幂(1MB~4MB),影响 Remembered Set 大小和扫描粒度;小 Region 提高精度但增加元数据开销- 不要手动设置
-XX:G1NewSizePercent和-XX:G1MaxNewSizePercent,G1 会根据 pause 目标自动伸缩年轻代——除非你观察到 young GC 过于频繁且每次回收量极小 -XX:G1MixedGCCountTarget=8控制混合回收中老年代 Region 的清理节奏;值越小,单次混合 GC 压力越大,但总耗时可能缩短
并发标记启动时机与常见误判
G1 的并发标记周期不是在堆满时才启动,而是在堆使用率达到 InitiatingOccupancyFraction(默认 45%)时触发初始标记(Initial Mark),该阶段需 STW,但极短(通常
容易踩的坑:
- 误以为
-XX:InitiatingOccupancyFraction=20就能“更早清理”,结果导致标记周期太频繁,反而抬高 CPU 占用、挤占应用线程资源 - 忽略
G1ReservePercent(默认 10%)——这是预留空间,防止混合回收时无空闲 Region 可用;若老年代碎片严重又没留够,会触发 Full GC - 监控时只看
G1 Evacuation Pause,却漏掉G1 Humongous Allocation引发的意外停顿:大对象(>½ Region)直接分配在巨型 Region,不参与复制,易造成碎片和隐式 Full GC
ZGC 的“染色指针”如何绕过传统并发难题
ZGC 不用写屏障维护 Remembered Set,而是把标记信息直接编码进 64 位指针的高 bits(metadata bits),通过读屏障(Load Barrier)在对象加载时检查并修正标记状态。这意味着:
- 并发标记和并发移动(
Concurrent Relocation)可真正重叠,STW 阶段只剩初始标记和最终标记中的极小部分(通常 - 无需分代假设,所有 Region 统一管理,避免 G1 中年轻代/老年代策略冲突
- 但 ZGC 要求 Linux kernel ≥ 4.14(支持 userfaultfd)、JDK ≥ 11(生产可用从 JDK 15 开始),且堆大小建议 ≥ 8GB 才显优势
真正难的是内存页映射与 TLB 刷新的协同——ZGC 在 relocate 后必须确保所有 CPU 核心的 TLB 条目失效,这步由 OS 协助完成,也是它对内核版本敏感的根本原因。
今天关于《并行回收与标记平衡GC性能》的内容就介绍到这里了,是不是学起来一目了然!想要了解更多关于的内容请关注golang学习网公众号!
 CSS容器查询实现自适应字体
- 上一篇
- CSS容器查询实现自适应字体

- 下一篇
- Golang百分比计算技巧与错误防范
-
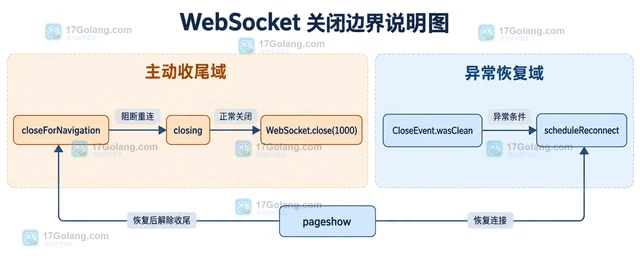
- 文章 · 前端 | 20小时前 | 前端 · websocket ·
- WebSocket 重连退避与页面卸载的收尾
- 381浏览 收藏
-
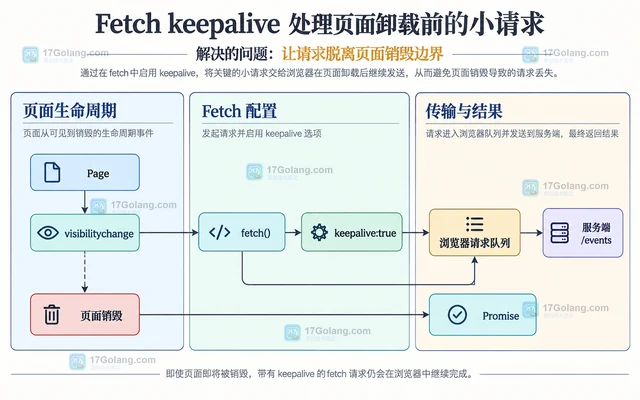
- 文章 · 前端 | 22小时前 |
- Fetch keepalive 处理页面卸载前的小请求
- 291浏览 收藏
-
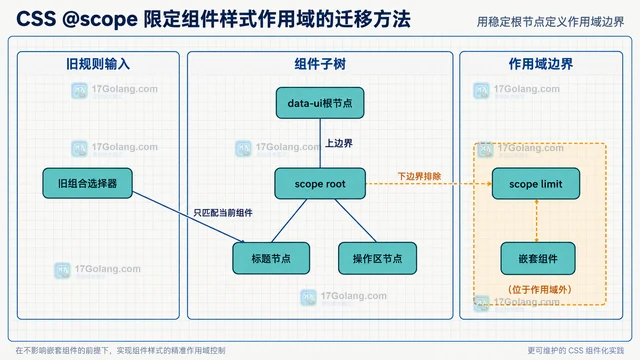
- 文章 · 前端 | 1天前 |
- CSS @scope 限定组件样式作用域的迁移方法
- 294浏览 收藏
-
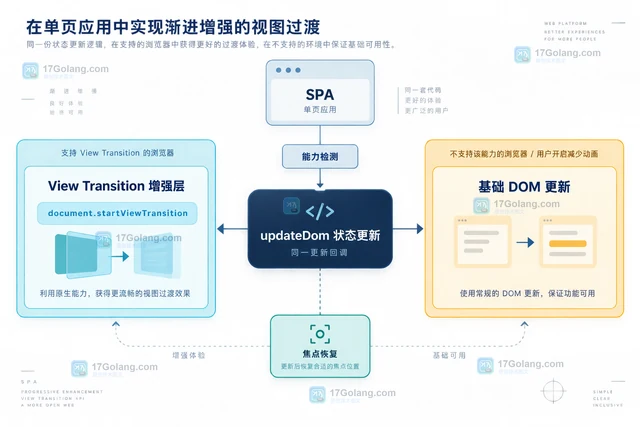
- 文章 · 前端 | 1天前 |
- View Transition API 在 SPA 状态切换中的降级方案
- 142浏览 收藏
-
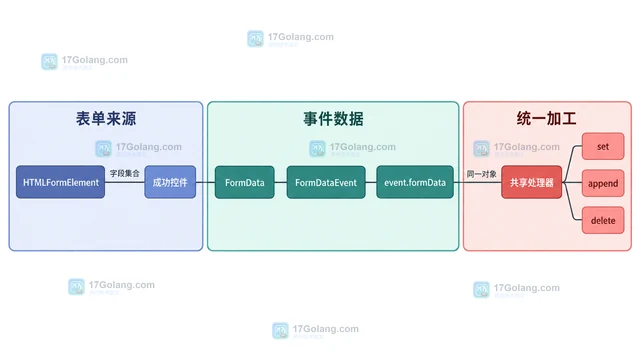
- 文章 · 前端 | 1天前 | javascript · 表单 · FormData FormDataEvent formdata事件 原生表单
- FormDataEvent 统一拦截原生表单数据的实现
- 288浏览 收藏
-
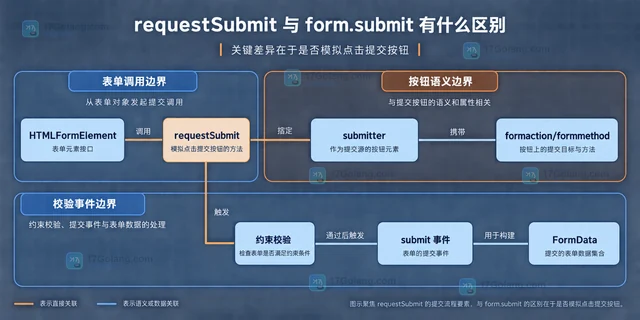
- 文章 · 前端 | 1天前 | html · javascript · 表单 · requestSubmit form.submit HTML表单校验
- requestSubmit 与 form.submit 有什么区别
- 392浏览 收藏
-
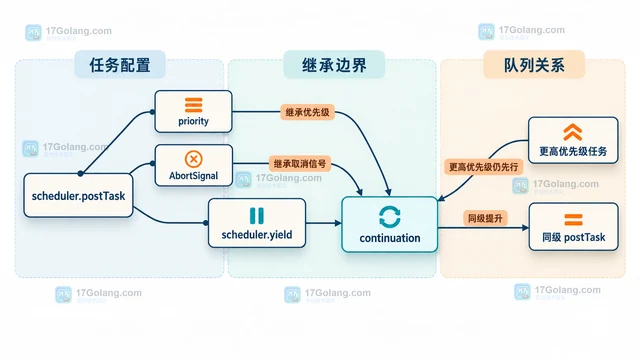
- 文章 · 前端 | 1天前 |
- scheduler.yield 怎么把长任务拆开又保持优先级
- 110浏览 收藏
-
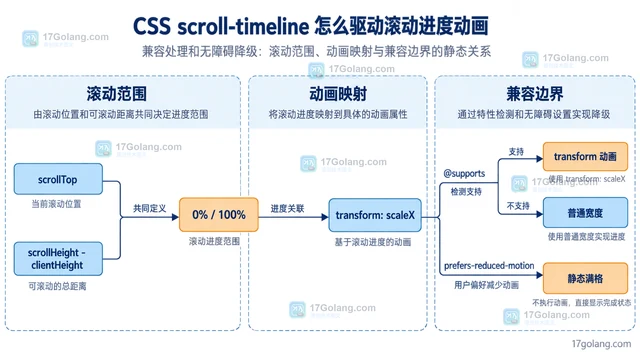
- 文章 · 前端 | 1天前 | CSS 滚动动画 animation-timeline scroll-timeline
- CSS scroll-timeline 怎么驱动滚动进度动画
- 251浏览 收藏
-
- 文章 · 前端 | 2天前 |
- IntersectionObserver scrollMargin 怎么处理嵌套滚动容器
- 380浏览 收藏
-
- 文章 · 前端 | 2天前 |
- dialog 的 closedby 属性怎么控制关闭方式
- 269浏览 收藏
-
- 文章 · 前端 | 2天前 |
- HTML popover 属性怎么管理轻量浮层
- 249浏览 收藏
-
- 文章 · 前端 | 2天前 |
- Navigation API 怎么拦截单页应用导航
- 167浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 264次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 315次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 300次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 273次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 92次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览