
Python批量下载高清大图教程
本文详解了Python批量下载网页高清大图的核心技巧与实战避坑指南:从精准识别藏在data-original、data-src、srcset等非src属性中的原图URL,到正确解析带w/x后缀的响应式图片源、补全相对路径、模拟浏览器请求头绕过反爬,再到安全下载、去重定向、内容类型校验及文件名处理等全流程优化策略——不仅教你如何“找到图”,更聚焦于如何可靠、高效、鲁棒地“找到真正想要的高清图”,直击爬虫实践中最易踩坑又最难调试的图像采集痛点。
识别网页中高清图的常见HTML特征
很多网站把缩略图和原图分开存放,缩略图在 src 属性里,而高清图藏在 data-src、data-original、data-fullsize 或 srcset 里。有些站点甚至把原图URL拼在缩略图路径末尾(比如把 thumb_abc.jpg 改成 full_abc.jpg),或用固定后缀替换(.webp?size=120 → .jpg)。
- 直接读
src下载的往往是低清图,尤其在响应式站点上 srcset值是一串逗号分隔的URL WIDTHw,需提取最大宽度对应的URLdata-*属性需要显式检查,不能依赖默认解析逻辑- 部分图片URL是相对路径,要用
urllib.parse.urljoin()补全
用requests + BeautifulSoup安全下载带反爬的图片
直接用 requests.get() 请求图片URL常被返回403或空内容——因为服务器校验 Referer 和 User-Agent。必须模拟浏览器行为:
- 设置
headers = {"User-Agent": "Mozilla/5.0...", "Referer": page_url} - 对含登录态的页面,先用
requests.Session()登录并复用 cookies - 遇到重定向(如302跳转到CDN域名),确保
allow_redirects=True并检查最终response.url是否仍是图片地址 - 下载前用
response.headers.get("Content-Type")判断是否为image/jpeg等,避免保存HTML错误页
import requests from bs4 import BeautifulSoup from urllib.parse import urljoin, urlparsesession = requests.Session() session.headers.update({"User-Agent": "Mozilla/5.0..."})
def get_image_urls(page_url): r = session.get(page_url) soup = BeautifulSoup(r.text, "html.parser") urls = [] for img in soup.find_all("img"):
优先取 data-original
url = img.get("data-original") or img.get("data-src") or img.get("src") if url: full_url = urljoin(page_url, url.strip()) urls.append(full_url) return urls
处理srcset和动态生成的高清图URL
srcset 字符串不是标准JSON,不能用 json.loads。要手动按逗号切分,再对每段用空格拆出URL和描述(如 "https://a.jpg 2x" 或 "https://b.webp 1200w")。关键点:
- 优先选带
w后缀的项(表示像素宽度),取最大w对应的URL - 若只有
x后缀(如2x),需结合设备像素比推测,但批量场景下通常直接取最后一个更稳妥 - 部分站点在
srcset里混入 WebP 和 JPG,优先选.jpg或.png后缀(兼容性更好)
def parse_srcset(srcset: str, base_url: str) -> str:
    candidates = []
    for part in srcset.split(","):
        part = part.strip()
        if not part:
            continue
        url_part, *desc = part.split()
        if len(desc) == 0:
            candidates.append(urljoin(base_url, url_part))
        else:
            if "w" in desc[0]:
                candidates.append(urljoin(base_url, url_part))
    return candidates[-1] if candidates else ""
下载时避免被封、乱码、文件损坏- 单IP高频请求易触发限流,加
time.sleep(1) 是底线;更稳妥的是用 random.uniform(1, 3) - 文件名含中文或特殊字符会导致保存失败,用
urllib.parse.quote(url, safe='')[-60:] 截取并编码 - 图片响应可能没带
Content-Length,用 response.iter_content(chunk_size=8192) 流式写入更省内存 - 下载后用
PIL.Image.open() 尝试打开,捕获 IOError 可筛掉损坏文件(但别在批量中开启,太慢)
time.sleep(1) 是底线;更稳妥的是用 random.uniform(1, 3)urllib.parse.quote(url, safe='')[-60:] 截取并编码Content-Length,用 response.iter_content(chunk_size=8192) 流式写入更省内存PIL.Image.open() 尝试打开,捕获 IOError 可筛掉损坏文件(但别在批量中开启,太慢)真正难的不是找到图,而是判断哪张才是“用户想要的高清图”——同一页面可能有缩略图、中图、大图、WebP原图、带水印图共存。靠规则匹配永远有漏,必要时得结合尺寸解析(如只取宽 > 1200 的URL)或人工标注样本做简单分类。
好了,本文到此结束,带大家了解了《Python批量下载高清大图教程》,希望本文对你有所帮助!关注golang学习网公众号,给大家分享更多文章知识!
 Linux软链接管理技巧:ln命令实用指南
- 上一篇
- Linux软链接管理技巧:ln命令实用指南
- 下一篇
- QwenPHP调用函数全解析
-
- 文章 · python教程 | 57分钟前 |
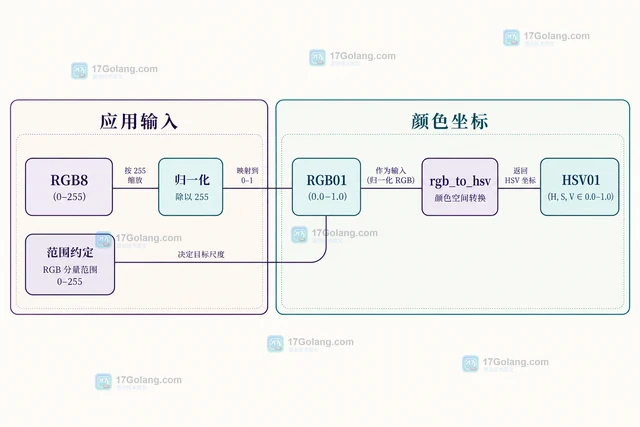
- Python colorsys 为什么不能直接接收零到二百五十五的 RGB 值
- 123浏览 收藏
-
- 文章 · python教程 | 1小时前 | 标准库 · python · Python HLS 颜色转换 RGB colorsys rgb_to_hls hls_to_rgb
- Python colorsys 怎样在 RGB 与 HLS 之间转换
- 482浏览 收藏
-
- 文章 · python教程 | 1小时前 | 标准库 · 持久化 · python · Python Cookiejar expires http.CookieJar FileCookieJar ignore_expires
- Python CookieJar 的过期过滤与 ignore_expires 有什么区别
- 330浏览 收藏
-
- 文章 · python教程 | 2小时前 | 标准库 · python · Cookiejar Python MozillaCookieJar cookies.txt Python保存Cookie
- Python MozillaCookieJar 怎样把 Cookie 保存到本地文件
- 299浏览 收藏
-
- 文章 · python教程 | 2小时前 |
- Python headerregistry 的 defects 怎样保留邮件头解析问题
- 309浏览 收藏
-
- 文章 · python教程 | 3小时前 |
- Python headerregistry 怎样保留地址组名称与组内收件人
- 360浏览 收藏
-
- 文章 · python教程 | 4小时前 |
- Python plistlib 怎样把配置写成二进制 plist
- 491浏览 收藏
-
- 文章 · python教程 | 4小时前 | python · Python MIME quoted-printable quopri Q编码 邮件头
- Python quopri 的 header 参数为什么改变下划线含义
- 491浏览 收藏
-
- 文章 · python教程 | 4小时前 | python · Python MIME quoted-printable quopri 邮件正文
- Python quopri 怎样解码带软换行的邮件正文
- 147浏览 收藏
-
- 文章 · python教程 | 6小时前 |
- Python imaplib 怎样用 UID 获取邮件而不依赖序号
- 413浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 797次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 787次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 876次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 846次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 677次使用
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览


