
Claude长文档处理技巧详解
想让Claude真正读懂几十页的合同、报告或政策文件,而不是浮光掠影地“扫一眼”就交差?本文直击长文档分析失效的核心痛点——不是模型能力不够,而是输入方式和提示策略错了。通过分段锚定上下文、摘要引导迭代验证、JSON模板强制结构化提取、关键词反向精准定位、多角色协同深度推演这五大实操技巧,手把手教你把Claude从“被动阅读器”升级为“主动分析师”,尤其适合处理法律文本、技术白皮书、合规文件等高密度长内容,让关键信息无处隐藏,逻辑漏洞无所遁形。
如果您需要让Claude对长文档进行深度分析,但发现其响应不完整、遗漏关键信息或无法准确把握上下文,则可能是由于输入长度超出模型有效处理范围或提示策略不当。以下是针对Claude长文本分析的多种实用技巧:
一、分段输入与上下文锚定法
Claude对单次输入有严格token限制,直接提交超长文档会导致截断或理解失真;通过人工划分逻辑单元并嵌入前后文锚点,可显著提升模型对全局结构的感知能力。
1、使用PDF阅读器或文本编辑工具将长文档按章节、小节或语义块切分为500–1200词的段落。
2、在每段开头添加统一格式的上下文标识,例如:【前文摘要:上一段核心结论为……|当前段标题:第三章 数据验证】
3、向Claude发送首段时明确指令:“请逐段分析该文档,每段输出需包含要点提炼、逻辑漏洞标记、术语一致性检查三项内容。”
4、后续段落输入时,附上前一段生成的要点提炼结果作为新锚点,维持语义连贯性。
二、摘要引导式迭代分析法
利用Claude强摘要能力构建“摘要—提问—深化”闭环,避免一次性加载全文造成的注意力稀释,使模型聚焦于用户真正关心的维度。
1、先提交文档前2000字符,要求输出三句话摘要+三个待验证假设。
2、将摘要与假设组合成新提示:“基于以下摘要[粘贴],请验证假设1:[具体内容],仅依据文档中明确出现的句子作答,标注原文位置(如P12第3行)。”
3、对每个假设单独发起请求,每次输入仅含相关原文片段及对应假设,禁止混入无关段落。
4、汇总所有验证结果后,用新提示命令:“整合以下四条验证结论[逐一粘贴],推导出文档整体论证强度评级(A–F)及依据。”
三、结构化模板约束法
向Claude注入强格式约束可抑制其自由发挥倾向,强制其在预设框架内提取信息,特别适用于法律合同、技术白皮书等高结构化长文档。
1、定义固定字段模板,例如:{条款编号}|{义务主体}|{执行条件}|{违约后果}|{引用条款}。
2、将文档按自然段落拆分后,对每段发出统一指令:“请严格按以下JSON格式提取本段信息,缺失项填‘未提及’,不得添加解释性文字:{模板}。”
3、接收返回后,用正则表达式校验JSON合法性,对格式错误段落追加提示:“请重写,必须以左花括号开始,右花括号结束,字段名用英文双引号包裹。”
4、将全部合法JSON合并为数组,导入表格工具完成横向比对与冲突检测。
四、关键词反向定位法
当目标是检索长文档中隐含观点或分散论据时,传统通读效率低下;通过预设关键词集驱动Claude定向扫描,可快速定位跨段落语义关联。
1、从任务目标反向提炼3–5个核心关键词,例如分析“供应商责任边界”,关键词为:“不可抗力”“书面通知”“替代履行”“赔偿上限”。
2、对每个关键词单独发起请求:“请扫描全文,列出所有包含‘书面通知’的句子,每句注明所在段落序号及前后20字符上下文。”
3、收到全部关键词结果后,人工合并去重,识别同一概念在不同段落中的表述差异,例如“书面通知”在第7段指邮件,在第15段指挂号信。
4、向Claude提交差异集合并提问:“‘书面通知’在文档中存在两种操作定义,请指出哪一定义被后续条款实际引用,并给出引用条款编号。”
五、角色扮演协同解析法
为应对长文档中多立场、多角色交织的复杂论述(如政策文件中的监管方/企业/公众三方博弈),赋予Claude特定角色身份可增强其视角稳定性与推理纵深。
1、首次输入时设定角色:“你现在是资深合规官,职责是识别企业端义务漏洞,忽略监管程序描述与公众权利宣示。”
2、提交整篇文档的目录结构及各章节首段,要求输出:“按章节列出企业义务条款编号清单,标注是否存在模糊动词(如‘应尽量’‘原则上’)。”
3、针对标记出的模糊条款,切换角色为“企业法务”:“从风险防控角度,指出第4.2条中‘合理期限’应如何量化,列举三个行业惯例数值。”
4、最后切换角色为“仲裁员”:“综合前述合规官与法务意见,判断若发生争议,法院最可能采纳哪种‘合理期限’解释?依据文档中哪两条相互支撑?”
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Claude长文档处理技巧详解》文章吧,也可关注golang学习网公众号了解相关技术文章。
 Go语言无需Docker构建镜像教程
- 上一篇
- Go语言无需Docker构建镜像教程
- 下一篇
- TailwindCSSgap-y使用与布局优化技巧
-
- 科技周边 · 人工智能 | 4小时前 |
- OpenAI API 怎样读取模型返回的使用量字段
- 234浏览 收藏
-
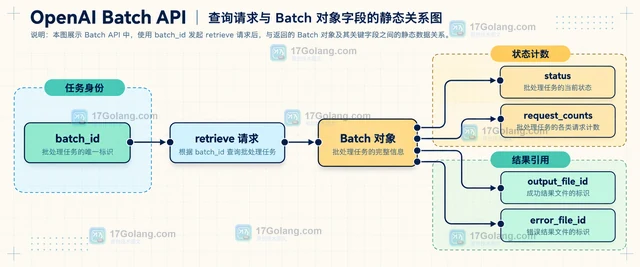
- 科技周边 · 人工智能 | 4小时前 | 人工智能 · OpenAI Batch API batch status 批处理任务 API状态查询
- OpenAI Batch API 怎样查询批处理任务状态
- 292浏览 收藏
-
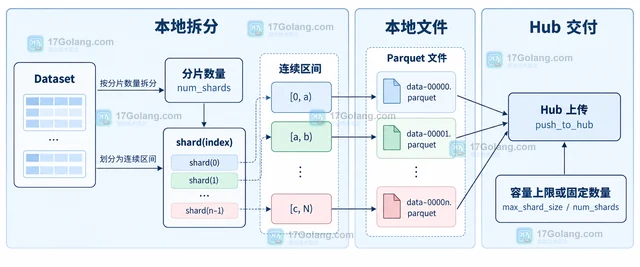
- 科技周边 · 人工智能 | 4小时前 | Parquet Hugging Face Datasets shard to_parquet push_to_hub
- Hugging Face Datasets 导出 Parquet 时怎么控制分片大小
- 378浏览 收藏
-
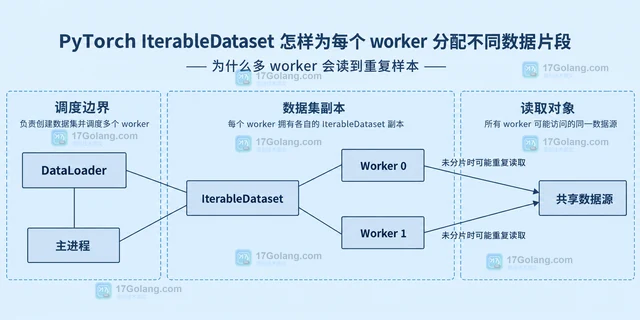
- 科技周边 · 人工智能 | 4小时前 | PyTorch DataLoader IterableDataset get_worker_info
- PyTorch IterableDataset 怎样为每个 worker 分配不同数据片段
- 455浏览 收藏
-
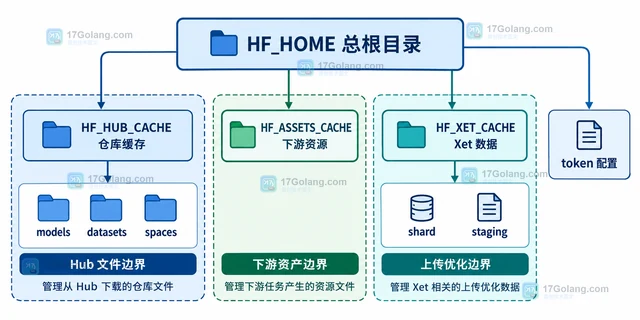
- 科技周边 · 人工智能 | 4小时前 | python · 人工智能 · snapshot_download Hugging Face Hub HF_HUB_CACHE HF_HOME 模型缓存 huggingface_hub
- Hugging Face Hub 怎样用缓存目录管理模型文件
- 247浏览 收藏
-
- 科技周边 · 人工智能 | 4小时前 |
- Hugging Face Transformers 怎样用 ignore_mismatched_sizes 加载分类模型
- 113浏览 收藏
-
- 科技周边 · 人工智能 | 4小时前 |
- OpenAI API 怎样为请求设置幂等键
- 174浏览 收藏
-
- 科技周边 · 人工智能 | 4小时前 |
- OpenAI Responses API 怎样让长任务异步运行
- 327浏览 收藏
-
- 科技周边 · 人工智能 | 4小时前 | temperature top_p OpenAI API reasoning.effort max_output_tokens 采样参数
- OpenAI API 怎样用 temperature 之外的参数控制采样
- 131浏览 收藏
-
- 科技周边 · 人工智能 | 4小时前 |
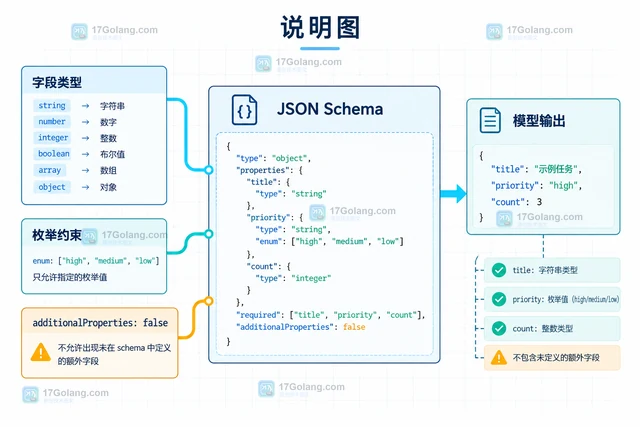
- OpenAI API 怎样限制输出内容使用指定文本格式
- 268浏览 收藏
-
- 科技周边 · 人工智能 | 4小时前 |
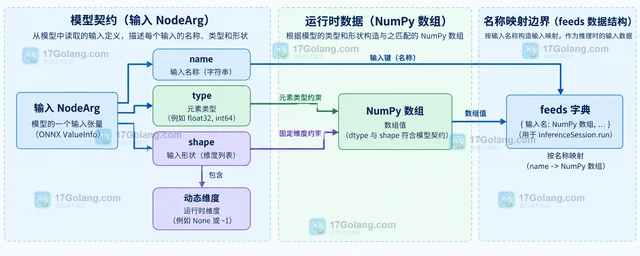
- ONNX Runtime 怎样查看模型输入名称与形状
- 349浏览 收藏
-
- 科技周边 · 人工智能 | 15小时前 |
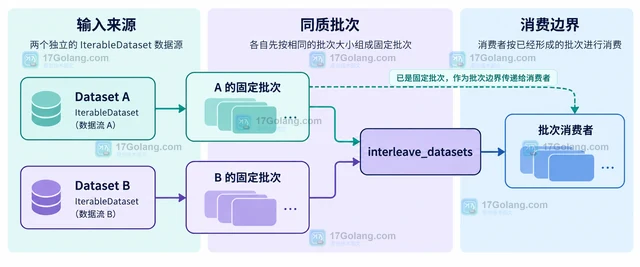
- Hugging Face Datasets IterableDataset batch 丢弃尾批的配置方法
- 297浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 720次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 728次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 804次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 765次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 603次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览


