
Python后端日志与ELK追踪详解
2026-04-10 12:10:31
0浏览
收藏
本文深入剖析了Python后端日志治理的核心痛点——如何真正实现可追踪、可聚合、可分析的结构化日志,而非简单“打日志”。从强制使用JsonFormatter输出ISO时间戳的JSON日志、通过contextvars在FastAPI异步场景下可靠透传trace_id,到中间件自动注入、HTTP/DB/协程全链路上下文携带,再到ELK侧ES字段类型设为keyword、Logstash避免误删关键字段等硬核细节,系统性拆解了分布式环境下日志与追踪一体化落地的关键路径和常见踩坑点,直击生产环境中搜不到trace、聚合失效、时序错乱、异步丢失等真实难题。
Python后端怎么打日志才能被Logstash正确解析
关键不是“打日志”,而是让日志行能被Logstash的json或grok插件稳定提取字段。默认logging输出的纯文本,Logstash很难可靠拆出trace_id、service_name这些字段。
- 必须用
JsonFormatter(如python-json-logger库)输出结构化JSON,每行一个JSON对象;Logstash配jsoncodec即可直接解析 - 避免在日志消息里拼接字符串,比如
logger.info(f"req {trace_id} failed")——这会让trace_id埋在message字段里,无法做聚合查询 - 所有上下文字段(
trace_id、span_id、user_id等)必须作为独立key传入extra参数,例如:logger.info("db query slow", extra={"trace_id": tid, "duration_ms": 120}) - 确保时间戳用ISO格式(
%Y-%m-%dT%H:%M:%S.%fZ),Logstash默认只认这个;否则@timestamp会 fallback 到接收时间,时序错乱
如何给每个请求注入并透传TraceID
不靠中间件自动注入,TraceID就只能靠手动塞,漏一环整条链就断。Django/Flask本身不带分布式追踪能力,得自己搭骨架。
- 在入口中间件(如Flask的
before_request)里检查request.headers.get("X-Trace-ID"),有则复用,无则生成uuid4().hex,存到flask.g.trace_id或django.request.META - 日志Handler里通过
record.__dict__.get("trace_id")取值,而不是从全局变量或threading.local硬读——后者在异步协程(如FastAPI + uvicorn)里会错乱 - 调用下游HTTP服务时,必须显式带上
headers={"X-Trace-ID": trace_id};用requests就包一层Session自动加头,用aiohttp得在ClientSession.request()里统一注入 - 数据库SQL日志也要透传:如果用SQLAlchemy,可通过
engine.connect().execution_options(trace_id=xxx)把trace_id挂到执行上下文,再在自定义DB logger里捞出来
ELK里查TraceID为什么搜不到或结果不全
不是日志没进ES,是字段没映射对,或者Logstash过滤时丢掉了。
- ES索引模板里,
trace_id字段必须设为"type": "keyword",不能是text——否则Kibana里无法做terms聚合、无法关联同一trace的所有span - Logstash配置里如果用了
mutate { remove_field => ["message"] },但没提前把trace_id从message里抽出来,那字段就彻底没了 - 时间范围选太窄:一个trace可能横跨多个分钟,Kibana默认只查最近15分钟,得手动拉宽到至少30分钟再搜
trace_id: "abc123" - 注意大小写:有些服务用
X-Trace-Id(小写i),有些用X-Trace-ID(大写D),Logstash里最好统一转成小写再赋值,避免字段名不一致
FastAPI异步场景下日志丢失TraceID怎么办
async def里用logging.info(),trace_id大概率为空——因为threading.local在协程切换时不保活,而默认Logger没做contextvars适配。
- 必须用
contextvars代替threading.local:定义trace_id_var = contextvars.ContextVar("trace_id", default=None),中间件里trace_id_var.set(tid) - 自定义
LoggerAdapter或重写LogRecord工厂函数,在makeRecord()里主动读trace_id_var.get()塞进extra - 别依赖
uvicorn.access日志:它走的是单独的access logger,和业务logger隔离,且不经过你的中间件,trace_id不会自动带上 - 第三方库(如
httpx、aioredis)的日志想带trace_id,得用contextvars配合其hook机制(如httpx.EventHook)手动注入,没有银弹
最易被忽略的是:Logstash重启后,旧索引的mapping不会自动更新。新加的trace_id字段如果没在模板里声明,ES会按动态mapping瞎猜类型,后面再改就麻烦了。
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Python后端日志与ELK追踪详解》文章吧,也可关注golang学习网公众号了解相关技术文章。
 PS批量加蒙版技巧,新手必学方法
- 上一篇
- PS批量加蒙版技巧,新手必学方法
- 下一篇
- 企业文件批量处理全流程教程
查看更多
最新文章
-
- 文章 · python教程 | 7小时前 |
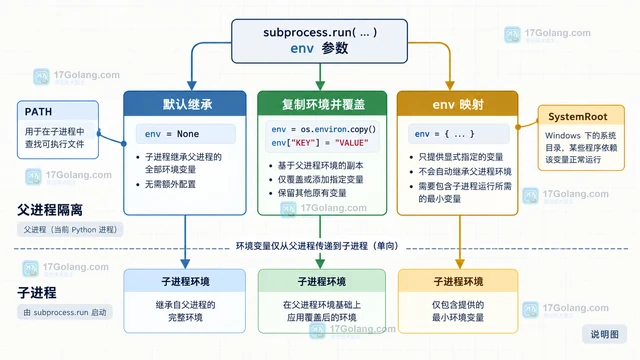
- Python subprocess.run 怎样为子进程传入独立环境变量
- 333浏览 收藏
-
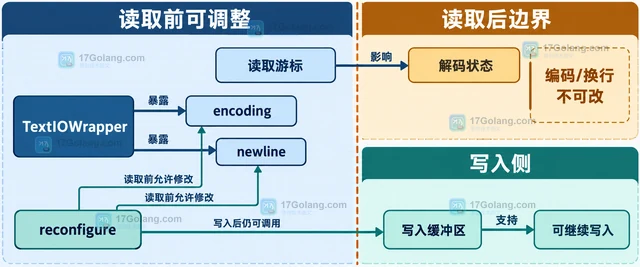
- 文章 · python教程 | 15小时前 | 文件处理 · 标准库 · python · Python 编码 文本流 TextIOWrapper reconfigure
- Python TextIOWrapper.reconfigure 怎样在不重开文件时切换编码
- 276浏览 收藏
-
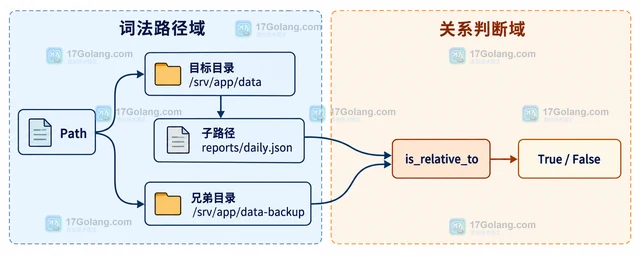
- 文章 · python教程 | 15小时前 | python · pathlib · Python pathlib 目录边界 Path.is_relative_to 路径判断
- Python pathlib.Path.is_relative_to 怎样判断路径是否位于指定目录
- 473浏览 收藏
-
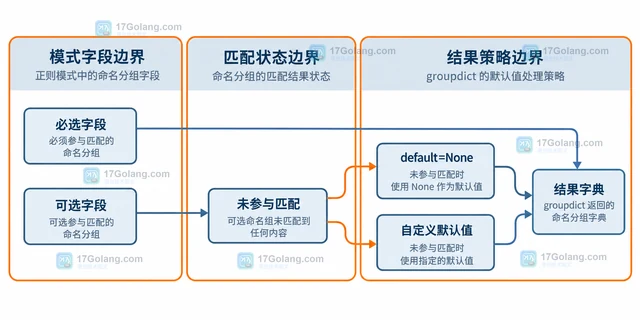
- 文章 · python教程 | 15小时前 | 正则表达式 · python · Python re 命名分组 Match.groupdict
- Python re.Match.groupdict 怎样读取命名分组
- 488浏览 收藏
-
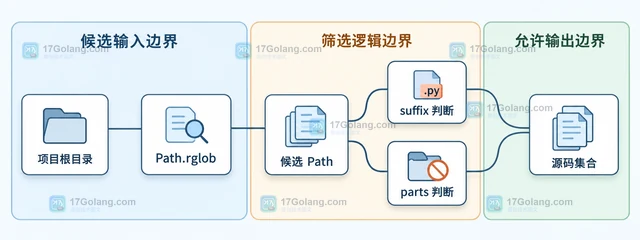
- 文章 · python教程 | 15小时前 | python · pathlib · Python pathlib Path.rglob
- Python pathlib.Path.rglob 怎样排除构建目录
- 461浏览 收藏
-
- 文章 · python教程 | 15小时前 |
- Python csv.DictReader 自定义 fieldnames 读取无表头文件
- 257浏览 收藏
-
- 文章 · python教程 | 15小时前 |
- Python functools.cache 怎样判断是否适合缓存无参函数
- 419浏览 收藏
-
- 文章 · python教程 | 15小时前 | TLS · python · 网络安全 · Python ssl.SSLContext TLS版本 minimum_version maximum_version
- Python ssl.SSLContext 怎样限制允许的 TLS 版本
- 399浏览 收藏
-
- 文章 · python教程 | 15小时前 | python · 文件系统 · Python 文件遍历 DirEntry os.scandir
- Python os.scandir 怎样减少目录遍历中的属性查询
- 353浏览 收藏
-
- 文章 · python教程 | 15小时前 | python · 异步编程 · Python asyncio TaskGroup ExceptionGroup
- Python asyncio.TaskGroup 怎样在任务组结束时集中处理异常
- 256浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 716次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 724次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 800次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 759次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 590次使用
查看更多
相关文章
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览


