
Golang实现SQL审计与优化技巧
本文深入探讨了在Go语言中实现高可靠SQL审计与智能优化建议的关键技术路径,强调必须通过劫持或代理`sql.Driver`而非简单封装函数来全覆盖拦截所有SQL执行路径(包括GORM、原生查询及事务嵌套),结合SQL标准化、AST解析与轻量级SQL Parser精准识别低效模式(如深分页、缺失索引、全表扫描),并针对GORM场景专门集成`gorm.Logger`接口以捕获预编译语句和钩子触发的隐式SQL;更重要的是,所有优化建议均严格绑定真实业务上下文——包括调用栈、服务名、HTTP路径、耗时、扫描行数、表规模及现有索引状态,确保每条建议可定位、可验证、可落地,真正将SQL审计从“日志堆砌”升级为驱动性能治理的闭环工程。

SQL审计必须拦截database/sql的底层调用,不能只包一层函数
Go 的 database/sql 是接口抽象层,真正执行 SQL 的是驱动(如 mysql、postgres)。如果只在业务层封装一个 ExecWithAudit() 函数,会漏掉 ORM(如 GORM)、raw db.Query()、事务内嵌套调用等场景。审计要生效,必须替换或劫持 sql.Driver 或使用 sql.Register() 注册代理驱动。
实操建议:
- 用
sql.Register("audit-mysql", &auditDriver{driver: mysql.MySQLDriver{}})包装原驱动,所有sql.Open("audit-mysql", ...)请求都会经过审计逻辑 - 在
auditDriver.Open()返回的*sql.Conn上,重写PrepareContext()和ExecContext(),提取query字符串和args - 避免在审计逻辑中做耗时操作(如写磁盘、发 HTTP),应异步投递到 channel 或 ring buffer,否则拖慢主流程
识别低效 SQL 不能只靠关键词匹配,得解析 AST 或至少做模式归一化
简单用 strings.Contains(query, "SELECT *") 或正则匹配 "ORDER BY.*LIMIT [0-9]+,[0-9]+" 容易误报或漏报。比如 SELECT * FROM users WHERE id = ? 没问题,但 SELECT * FROM logs WHERE created_at > ? 就危险;又比如 LIMIT 10 OFFSET 10000 是典型深分页,但 LIMIT 10 单独出现未必有问题。
实操建议:
- 对 query 做标准化:去除换行/多余空格、统一大小写、替换字面量为
?(如"WHERE id = 123"→"WHERE id = ?"),再匹配模板规则 - 用轻量 parser 如
github.com/xwb1989/sqlparser提取SELECT字段列表、WHERE条件、ORDER BY、LIMIT等结构,判断是否含非索引字段、无WHERE、ORDER BY字段未建索引等 - 记录执行耗时 + 扫描行数(需驱动支持
RowsAffected()或从 MySQLSHOW PROFILES补充),超阈值(如 >100ms 或扫描 >1000 行)才触发优化建议
GORM 场景下审计需额外处理预编译语句和钩子注入
GORM v2 默认启用 PrepareStmt: true,所有查询都走 Prepare/Query/Close 流程,且内部大量使用 context.WithValue() 透传 session 信息。若只监听 Exec,会错过 First()、Find() 等方法生成的隐式查询;同时 GORM 的 AfterFind、BeforeUpdate 钩子也可能触发额外 SQL,不纳入审计就断链。
实操建议:
- 启用 GORM 的
logger接口(实现gorm.Logger),在Trace()方法里拿到归一化后的sql和rows,比劫持驱动更稳定 - 用
db.Session(&gorm.Session{Context: ctx})在关键路径注入自定义 context key,让钩子函数能回调审计模块记录来源 - 注意 GORM 的
Count()查询常被忽略——它可能触发全表扫描,但不在主业务 SQL 审计流里,需单独加规则检测
优化建议必须带上下文,否则开发无法判断是否真该改
只返回“建议添加索引”或“避免 SELECT *”没用。开发者需要知道:这个 SQL 在哪个 service、哪个 handler、调用频次多少、平均延迟多少、最近 1 小时是否突增、对应表当前行数、主键和现有索引有哪些。
实操建议:
- 审计日志结构至少包含:
sql_normalized、stack(调用栈前 3 层)、service_name、http_path(若在 HTTP handler 中)、duration_ms、rows_scanned、table_names(从 AST 解析出) - 对“缺失索引”类建议,自动查
information_schema.STATISTICS,输出类似:"users.created_at 无索引,该表当前 2.4M 行,近 5 分钟此 SQL 调用 142 次,平均 327ms" - 避免建议冲突:同一张表上已有
(a,b)复合索引,就别再建议单独给a加索引;用SHOW INDEX结果做覆盖判断
真正难的不是抓 SQL,而是把一条慢查映射回具体代码位置、判断影响范围、排除误报。没有调用栈和指标上下文的审计,最后只会变成没人看的日志文件。
今天关于《Golang实现SQL审计与优化技巧》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 腾讯元宝AI官网及内容生成链接
- 上一篇
- 腾讯元宝AI官网及内容生成链接

- 下一篇
- Win11修改下载路径详细教程
-
- Golang · Go教程 | 4小时前 |
- Go go.sum 校验记录的提交策略
- 160浏览 收藏
-
- Golang · Go教程 | 4小时前 |
- Go mod graph 排查依赖引入路径的方法
- 142浏览 收藏
-
- Golang · Go教程 | 5小时前 |
- Go coverprofile 按包查看覆盖盲区
- 262浏览 收藏
-
- Golang · Go教程 | 5小时前 |
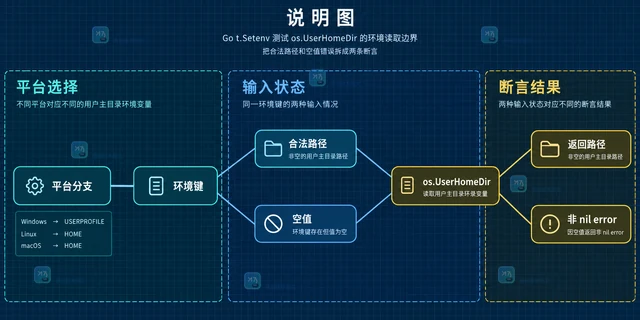
- Go t.Setenv 测试 os.UserHomeDir 的环境读取边界
- 231浏览 收藏
-
- Golang · Go教程 | 5小时前 | Go教程 · Go encoding/json io.Reader buffered json.Decoder JSON流
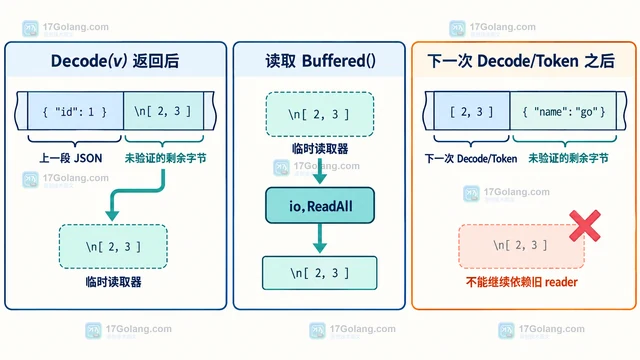
- Go json.Decoder.Buffered 怎样读取尚未消费的输入
- 484浏览 收藏
-
- Golang · Go教程 | 5小时前 | goroutine · 流式处理 · Go教程 · Go io.Pipe 生产者消费者 背压 PipeWriter PipeReader
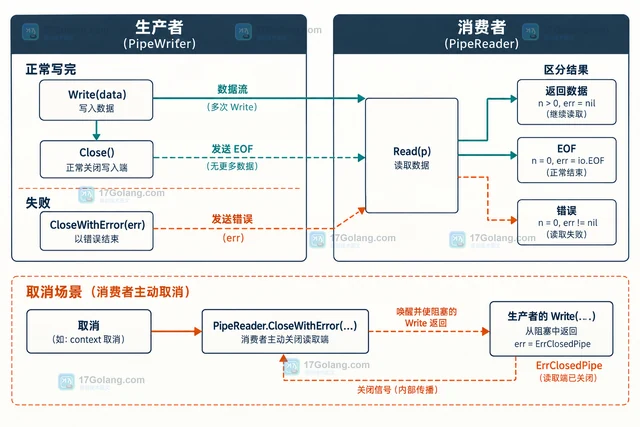
- Go io.Pipe 串流生产者消费者的背压处理
- 228浏览 收藏
-
- Golang · Go教程 | 5小时前 |
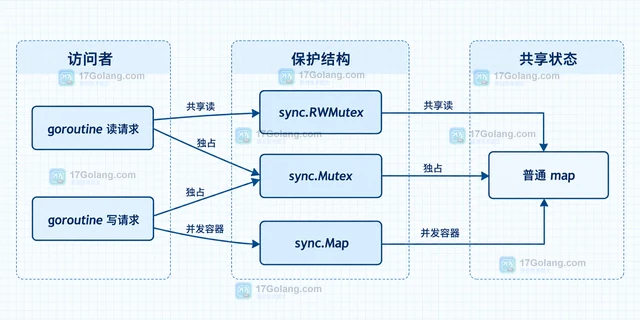
- Go 并发读写 map 的保护结构
- 198浏览 收藏
-
- Golang · Go教程 | 5小时前 |
- Go 接口中携带 nil 指针的判断方法
- 380浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 490次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 547次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 574次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 527次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 340次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览