
Redis数据类型选择与性能对比
Redis数据类型选择远不止“能用就行”,而是关乎性能、内存与可靠性的关键决策:HSET适合字段固定且需高频单字段读写的场景,SET则在整条数据原子替换或结构动态时更优;LIST队列缺乏可靠性机制,应优先选用STREAM实现带ACK和重试的健壮消息系统;ZSET排行榜务必避免浮点score和大范围分页,善用整数score与替代方案如STREAM;而大SET虽提供O(1)查询,但SMEMBERS极易引发内存与网络风暴——选对类型,不是语法问题,而是架构成败的起点。

字符串 SET 和哈希 HSET 存用户资料,哪个更快?
查单个字段(比如用户昵称)时,HSET + HGET 通常比 SET + JSON 解析快;但写入整条用户数据时,SET 一次存 JSON 更省网络往返。
常见错误是把所有字段塞进一个 SET 键里,结果每次改邮箱还得取、解析、改、序列化、再存——实际耗时翻倍,还容易出并发覆盖。
- 字段少且固定(如
name、age)、读写粒度细 → 用HSET user:123 name "Alice" age "28" - 字段动态多变(如用户扩展属性、标签列表)、或需原子性整体替换 → 用
SET user:123 '{"name":"Alice","tags":["vip"]}' HGETALL返回全部字段,但网络开销大;HGET单字段才是哈希的真正优势点
用 LIST 做消息队列?小心阻塞和丢消息
LPUSH + BRPOP 看似能当队列用,但没确认机制、不支持重试、消费者崩溃就丢数据。真要轻量级队列,优先考虑 STREAM。
性能上,LIST 的 LPOP 是 O(1),但 LRANGE 查历史是 O(N);而 STREAM 的 XREAD 是 O(M),M 是返回条数,天然适合游标分页。
- 仅临时缓存最近 N 条日志(如操作审计)→
LPUSH log:recent "op=login"+LTRIM log:recent 0 99 - 需要消费组、ACK、失败重投 → 必须用
XADD stream:order ...+XGROUP CREATE BLPOP超时后返回 nil,容易被当成“无任务”跳过,实际可能只是刚好空窗——得配合监控延迟指标
ZSET 排行榜卡顿?别只看 ZRANGE 复杂度
ZRANGE rank:game 0 99 WITHSCORES 看似 O(log N + M),但当 N 达千万级、M 固定为 100,瓶颈常在内存带宽和网络序列化——特别是 score 是浮点数时,Redis 序列化开销比整数高 2–3 倍。
更隐蔽的问题是:用时间戳当 score 做“最新 TOP100”,一旦有大量写入,zset 的跳跃表会频繁调整层级,CPU 毛刺明显。
- 纯分数排序(如积分榜)→ score 用整数,避免浮点;key 设计为
rank:game:score - 按时间倒序取最新(如热搜)→ 改用
STREAM+XREVRANGE,天然按插入顺序索引,不依赖 score 计算 - 需要分页(第 10001–10100 名)→
ZRANGE跳过前 10000 项仍是 O(N),此时应预生成“段缓存”,比如每万名为一个 key
集合 SET 去重和交集,内存比想象中吃得多
一个含 100 万个字符串的 SET,实际内存占用可能是原始字符串总长的 3–5 倍——因为 Redis 用 intset(小整数)或 hashtable(通用),后者每个元素额外带指针、hash 桶、rehash 预留空间。
如果只是判断“用户 A 是否在黑名单”,SET 没问题;但要是存“每个商品的百万级 SKU ID”,就得警惕:SISMEMBER 是 O(1),可 SMEMBERS 全量拉取会打爆客户端内存。
- 成员稳定、总量可控(SADD black:user 1001 1002
- 成员超 50 万 或 含长字符串(如 UUID)→ 改用布隆过滤器(
BF.ADD,需 RedisBloom 模块)省 80%+ 内存 - 求多个集合交集(
SINTER)时,Redis 会自动选最小集合做基准遍历——所以别把大集合放第一个参数,否则白耗 CPU
最常被忽略的是:SET 不保证插入顺序,也不支持范围查询。以为能靠 SSCAN 分批处理就安全,其实 scan 游标不保证一致性,两次 scan 间增删可能导致漏或重复。
好了,本文到此结束,带大家了解了《Redis数据类型选择与性能对比》,希望本文对你有所帮助!关注golang学习网公众号,给大家分享更多数据库知识!
 防止Token通胀的增发机制与风控策略
- 上一篇
- 防止Token通胀的增发机制与风控策略

- 下一篇
- 五子棋免费网页入口 经典棋类官网在线玩
-
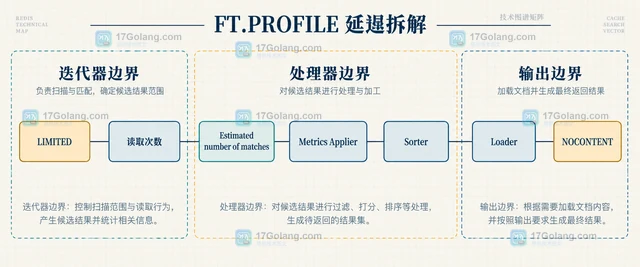
- 数据库 · Redis | 1天前 |
- Redis FT.PROFILE 拆分向量查询的延迟来源
- 212浏览 收藏
-
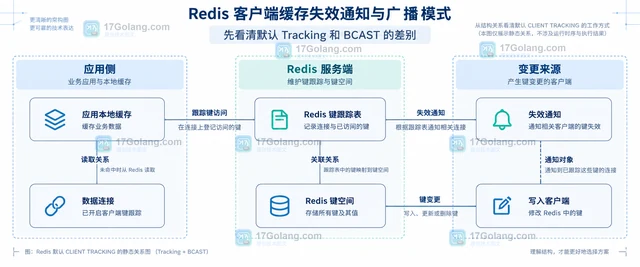
- 数据库 · Redis | 1天前 | Redis · CLIENT TRACKING BCAST Redis客户端缓存 缓存失效通知
- Redis 客户端缓存失效通知与广播模式
- 323浏览 收藏
-
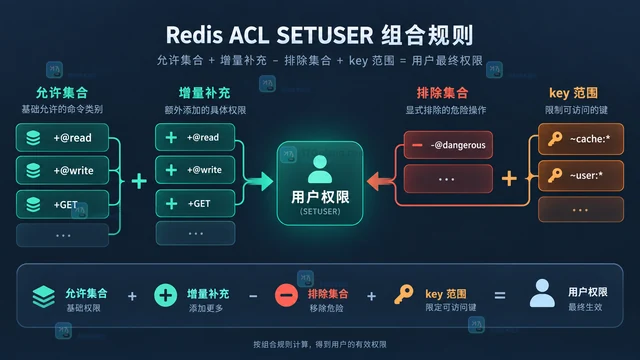
- 数据库 · Redis | 1天前 |
- Redis ACL CAT 组合权限分类的配置方法
- 361浏览 收藏
-
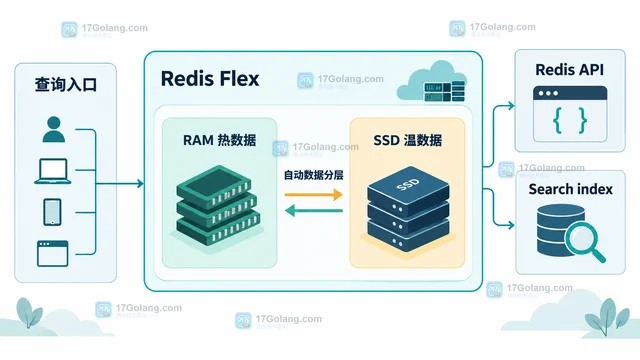
- 数据库 · Redis | 1天前 |
- Redis Flex SSD 索引承载大数据集的查询边界
- 456浏览 收藏
-
- 数据库 · Redis | 1天前 |
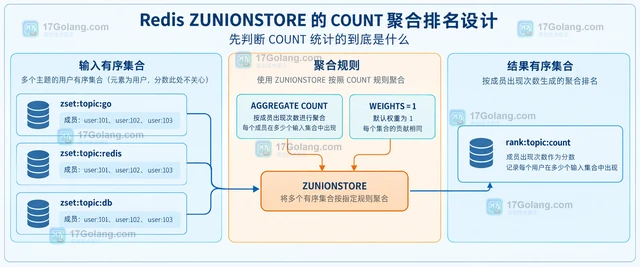
- Redis ZUNIONSTORE 的 COUNT 聚合排名设计
- 164浏览 收藏
-
- 数据库 · Redis | 1天前 |
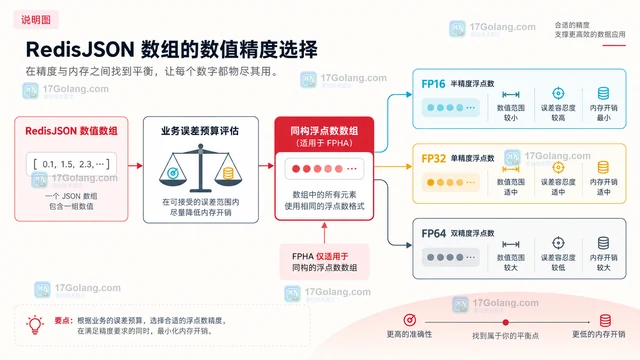
- RedisJSON 数组精度选择与内存占用取舍
- 272浏览 收藏
-
- 数据库 · Redis | 1天前 | Redis · groupby Max reduce AVG min Redis TimeSeries TS.MRANGE AGGREGATION
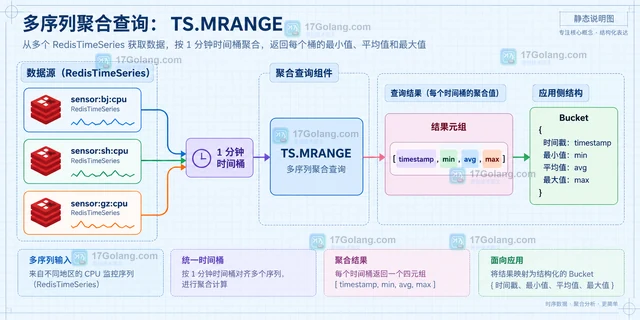
- Redis TimeSeries 一次查询多个聚合器的结果组织
- 476浏览 收藏
-
- 数据库 · Redis | 1天前 | Redis ·
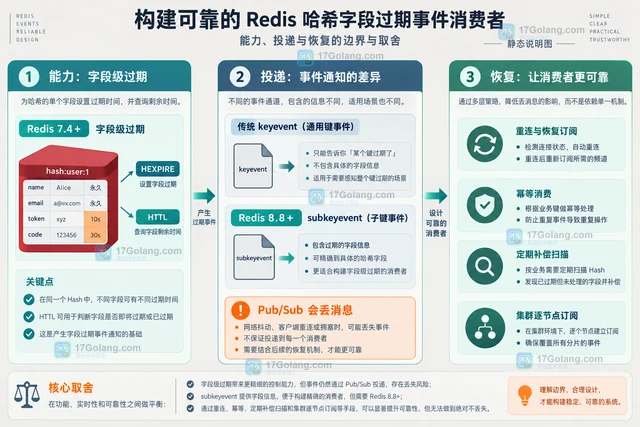
- Redis 哈希字段过期通知的订阅设计
- 306浏览 收藏
-
- 数据库 · Redis | 1天前 |
- Redis 窗口计数限流器的边界与过期策略
- 309浏览 收藏
-
- 数据库 · Redis | 1天前 |
- Redis Array 结构保存稀疏字符串序列的方式
- 490浏览 收藏
-
- 数据库 · Redis | 1天前 | Redis ·
- Redis Streams NACK 释放待处理消息的消费策略
- 397浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 425次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 505次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 516次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 460次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 289次使用
-
- Redis Stream XTRIM 如何避免消费组积压无限增长
- 2026-09-12 501浏览
-
- Redis AOF rewrite 期间如何判断磁盘与内存压力
- 2026-09-12 501浏览
-
- Redis RDB 和 AOF 怎么按可接受数据丢失量选择
- 2026-09-08 501浏览
-
- Redis XAUTOCLAIM 之后为什么仍有 pending:JUSTID、PEL 与消息删除边界
- 2026-08-29 501浏览
-
- Redis SET 的 GET 与 KEEPTTL 怎么一起验收:旧值返回、续期与回滚边界
- 2026-08-20 501浏览


