
AWS Lambda + Python 获取 EMR 标签方法
2026-04-07 16:24:24
0浏览
收藏
本文揭秘了在 AWS Lambda 环境中使用 Python 和 boto3 高效获取 Amazon EMR 集群标签的实用方案——由于 EMR 官方并未提供专用的 `get_tags` 接口,文章直击痛点,明确指出 `describe_cluster` 是唯一稳定可靠的替代方法,并附上开箱即用的完整 Lambda 示例代码;同时深入剖析权限配置、区域一致性、标签结构、异常处理与性能优化等关键实践细节,助你快速构建安全、健壮、可落地的标签自动化管理能力。
本文介绍如何通过 boto3 的 describe_cluster 方法在 AWS Lambda 中高效获取 Amazon EMR 集群的全部标签,替代不存在的 get_tags 接口,并提供可直接部署的示例代码与关键注意事项。
本文介绍如何通过 boto3 的 `describe_cluster` 方法在 AWS Lambda 中高效获取 Amazon EMR 集群的全部标签,替代不存在的 `get_tags` 接口,并提供可直接部署的示例代码与关键注意事项。
Amazon EMR 并未提供类似 S3 的 get_bucket_tagging 这样专用于标签查询的独立 API,但其集群元数据中完整包含了标签信息。核心方法是调用 describe_cluster —— 该接口不仅返回集群状态、配置和硬件信息,还将所有用户定义的标签以结构化形式嵌套在 response['Cluster']['Tags'] 中,是当前唯一官方支持且稳定的标签获取方式。
以下是一个可在 AWS Lambda 中直接运行的完整 Python 示例(基于 boto3):
import boto3
import json

def lambda_handler(event, context):
    # 从事件或环境变量中获取集群 ID(推荐通过 event 传入,提升灵活性与安全性)
    cluster_id = event.get('ClusterId')
    if not cluster_id:
        return {
            'statusCode': 400,
            'body': json.dumps({'error': 'Missing required parameter: ClusterId'})
        }

    try:
        emr_client = boto3.client('emr', region_name='us-east-1')  # 请根据实际区域调整
        response = emr_client.describe_cluster(ClusterId=cluster_id)

        # 提取标签列表(格式为 [{'Key': 'Name', 'Value': 'prod-emr'}, ...])
        tags = response['Cluster'].get('Tags', [])

        return {
            'statusCode': 200,
            'body': json.dumps({
                'ClusterId': cluster_id,
                'Tags': tags,
                'TagCount': len(tags)
            })
        }
    except emr_client.exceptions.ClusterNotFound:
        return {
            'statusCode': 404,
            'body': json.dumps({'error': f'EMR cluster {cluster_id} not found'})
        }
    except Exception as e:
        return {
            'statusCode': 500,
            'body': json.dumps({'error': str(e)})
        }
✅ 关键注意事项:
- 权限最小化原则:Lambda 执行角色需至少具备 elasticmapreduce:DescribeCluster 权限,避免授予 elasticmapreduce:* 等宽泛策略;
- 区域一致性:boto3.client('emr') 必须显式指定 region_name,且需与目标 EMR 集群所在区域一致,跨区域调用将失败;
- 标签结构说明:EMR 标签以键值对数组形式返回(非字典),每个元素为 {'Key': 'string', 'Value': 'string'},便于后续过滤或转换;
- 错误处理必要性:describe_cluster 在集群不存在、权限不足或 ID 格式错误时会抛出不同异常,生产环境务必捕获 ClusterNotFound、AccessDeniedException 等具体异常类型;
- 性能考量:该 API 响应通常在毫秒级,适合实时查询;若需批量获取多个集群标签,建议使用 list_clusters + 并发 describe_cluster(配合 concurrent.futures),但需注意 Lambda 并发配额限制。
综上,describe_cluster 是获取 EMR 集群标签的事实标准方案。它设计简洁、语义明确、响应可靠,结合合理的错误处理与权限配置,即可构建健壮的标签管理自动化流程。
好了,本文到此结束,带大家了解了《AWS Lambda + Python 获取 EMR 标签方法》,希望本文对你有所帮助!关注golang学习网公众号,给大家分享更多文章知识!
 QQ邮箱登录入口官网及手机版指南
- 上一篇
- QQ邮箱登录入口官网及手机版指南
- 下一篇
- Vue组件通信Emit处理滚动加载数据
查看更多
最新文章
-
- 文章 · python教程 | 5小时前 |
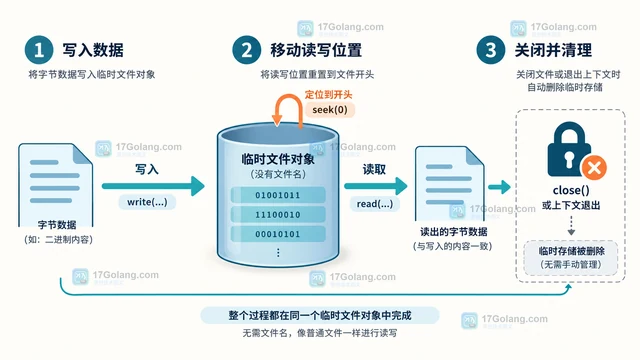
- Python tempfile.TemporaryFile 怎样处理无需文件名的临时数据
- 429浏览 收藏
-
- 文章 · python教程 | 5小时前 | 标准库 · python · Python statistics.multimode 并列众数 首次出现顺序 空输入
- Python statistics.multimode 保留并列众数首次出现顺序的处理方法
- 130浏览 收藏
-
- 文章 · python教程 | 5小时前 | Python 相对路径 start ntpath os.path.relpath
- Python os.path.relpath 怎样计算相对路径且不检查文件是否存在
- 291浏览 收藏
-
- 文章 · python教程 | 5小时前 | 异常处理 · python · Python 配置文件 configparser INI
- Python configparser 怎样区分缺失节和缺失选项
- 432浏览 收藏
-
- 文章 · python教程 | 5小时前 |
- Python decimal.localcontext 怎样限定单次计算精度
- 188浏览 收藏
-
- 文章 · python教程 | 5小时前 | 文件处理 · 标准库 · python · Python 路径判断 os.path.commonpath 目录树 commonprefix
- Python os.path.commonpath 怎样判断两个路径是否属于同一目录树
- 156浏览 收藏
-
- 文章 · python教程 | 5小时前 | python · logging · Python logging.handlers.MemoryHandler 日志缓冲 批量刷新 flushLevel
- Python logging.handlers.MemoryHandler 怎样按条件批量刷新日志
- 181浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 722次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 731次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 806次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 768次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 606次使用
查看更多
相关文章
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览


