
Python日志系统实战:分布式聚合分析案例
本文深入剖析了Python微服务场景下分布式日志系统的全链路实战方案:从Filebeat轻量采集、Redis/Kafka缓冲容错,到Logstash结构化解析与OpenTelemetry兼容的日志注入(自动携带trace_id、service_name等关键字段),再到Elasticsearch按服务分索引的高效存储与Kibana实时错误率看板、链路追踪和慢请求分析,最后落地智能告警——基于统计波动检测异常、结合suppress机制防轰炸,并嵌入上下文信息提升可操作性;整套体系兼顾可靠性、可观测性与运维效率,为高并发、多服务环境提供了开箱即用又可深度定制的日志治理范本。

分布式日志收集:用Logstash + Redis + Filebeat构建可靠管道
在微服务或容器化部署中,日志分散在成百上千个节点上,直接读取本地文件已不可行。核心思路是:**边缘采集 → 中间缓冲 → 集中消费**。
Filebeat轻量、低资源占用,适合部署在每台应用服务器上,负责监听日志文件变化并发送;Redis作为消息队列,提供削峰填谷和临时容错能力;Logstash运行在中心节点,从Redis拉取数据,做字段解析(如提取trace_id、level、service_name)、格式标准化(统一转为JSON),再写入Elasticsearch。
- Filebeat配置关键项:`output.redis` 指定Redis地址,`processors.add_fields` 注入主机名、服务名等上下文字段
- Logstash input插件用redis { data_type => "list" key => "filebeat" },filter中用json { source => "message" }解析原始日志体
- 避免Redis单点故障:可启用Redis哨兵模式,或改用Kafka(吞吐更高,支持多消费者与重放)
Python日志结构化:从logging到OpenTelemetry兼容输出
默认的logging模块输出是纯文本,不利于下游解析。必须让每条日志自带结构字段,尤其是trace_id、span_id、service.name——这是实现链路追踪分析的前提。
推荐方式是使用structlog或自定义logging.Formatter,将LogRecord中的extra字段自动转为JSON字段。若已接入OpenTelemetry,更建议直接用opentelemetry-instrumentation-logging,它会自动注入当前trace上下文。
- 在Flask/FastAPI中间件中,通过request.headers.get("traceparent")提取并绑定到logger的extra中
- 避免在日志里拼接敏感信息(如token、密码),用占位符+过滤器(Filter子类)脱敏后再输出
- 设置logger.setLevel(logging.INFO),但DEBUG级日志只在特定服务开启,防止日志爆炸
日志聚合分析:用Elasticsearch + Kibana做实时诊断
日志进ES后,不是堆在那里看,而是要能快速定位问题。关键在于索引设计与查询逻辑。
按service_name + date建索引(如logs-payment-2024.06.15),配合ILM策略自动滚动与删除;mapping中对trace_id设为keyword类型,对message保留text分词能力,同时开启fielddata供聚合用。
- Kibana中创建“错误率看板”:用count() / overall count()计算level: ERROR占比,按service_name分组,设置告警阈值
- 排查慢请求:筛选duration_ms > 1000,按endpoint和http.status_code聚合,找出高频失败路径
- 关联分析:用Kibana的Discover → Trace View输入trace_id,串联展示该链路所有服务的日志与Span耗时
异常检测与智能告警:用Logstash过滤+Alerting API联动
规则告警容易误报。更有效的方式是结合统计规律识别异常波动,比如某服务ERROR日志量突增300%,或5xx响应比例10分钟内翻倍。
可在Logstash filter中用aggregate插件做窗口计数(如每5分钟统计各service的error数),再通过http_output调用自研告警服务;或用Elasticsearch Alerting API配置metric aggregation + threshold条件,触发Webhook通知企业微信/钉钉。
- 避免“告警轰炸”:对同一trace_id的连续错误只告一次,加suppress机制(如1小时内不重复推送)
- 告警消息带上下文:包含最近3条相关日志、对应trace_id跳转链接、服务负责人标签
- 把高频告警规则沉淀为Jupyter Notebook脚本,定期回溯验证准确率,持续优化阈值
好了,本文到此结束,带大家了解了《Python日志系统实战:分布式聚合分析案例》,希望本文对你有所帮助!关注golang学习网公众号,给大家分享更多文章知识!
 FastKDE单变量密度预测完整教程
- 上一篇
- FastKDE单变量密度预测完整教程

- 下一篇
- Golang切片扩容陷阱与指针影响
-
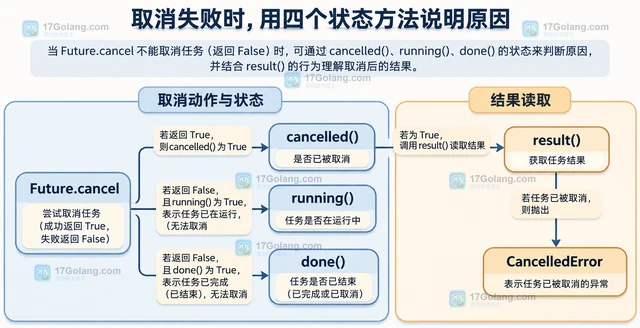
- 文章 · python教程 | 2天前 | 线程池 · Python 线程池 concurrent.futures 任务取消 Future.cancel
- Python concurrent.futures.Future.cancel 怎样判断任务能否取消
- 143浏览 收藏
-
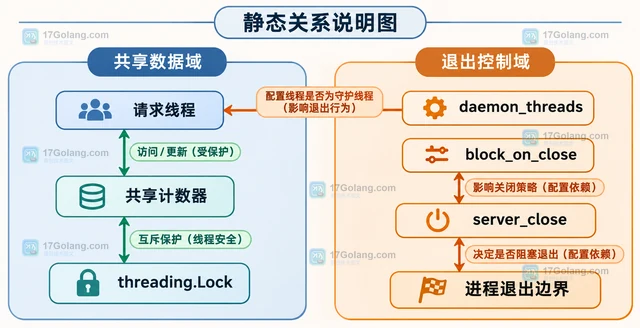
- 文章 · python教程 | 2天前 | 标准库 · HTTP服务 · 多线程 · Python教程 · Python 并发请求 http.server ThreadingHTTPServer ThreadingMixIn BaseHTTPRequestHandler
- Python http.server ThreadingHTTPServer 怎样处理并发请求
- 481浏览 收藏
-
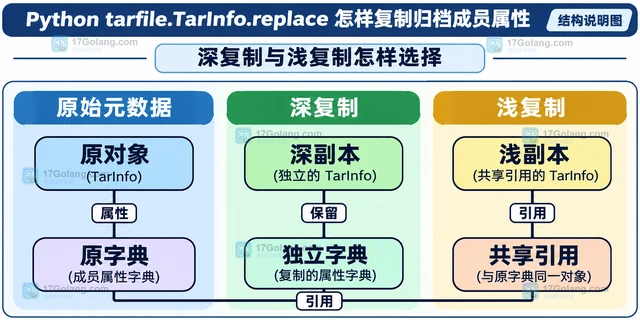
- 文章 · python教程 | 2天前 |
- Python tarfile.TarInfo.replace 怎样复制归档成员属性
- 308浏览 收藏
-
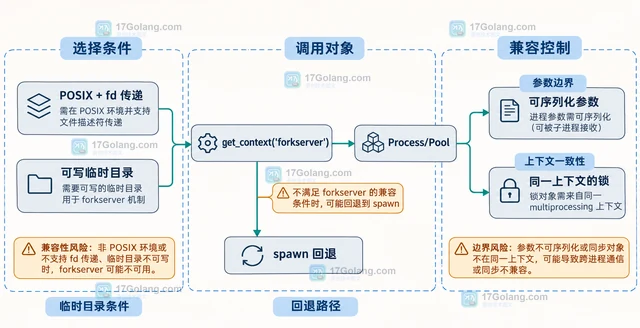
- 文章 · python教程 | 2天前 | 并发编程 · Python教程 · Python 多进程 multiprocessing forkserver 启动上下文
- Python multiprocessing forkserver 怎样处理进程启动上下文
- 232浏览 收藏
-
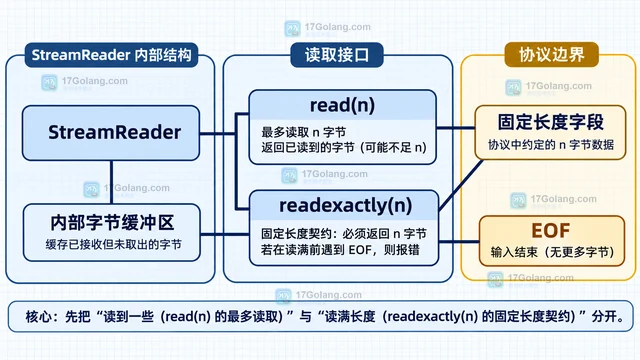
- 文章 · python教程 | 2天前 | 标准库 · 异步编程 · Python教程 · Python asyncio StreamReader readexactly IncompleteReadError 异步流
- Python asyncio.StreamReader.readexactly 怎样处理不足长度的输入
- 427浏览 收藏
-
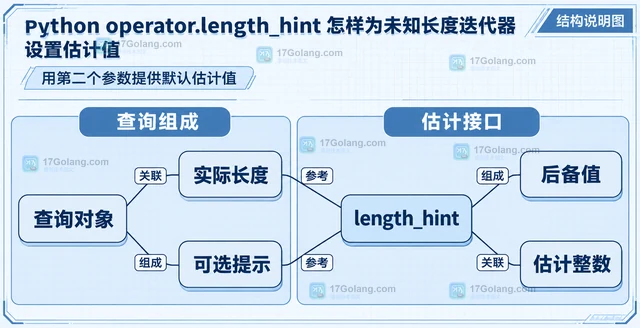
- 文章 · python教程 | 2天前 |
- Python operator.length_hint 怎样为未知长度迭代器设置估计值
- 336浏览 收藏
-
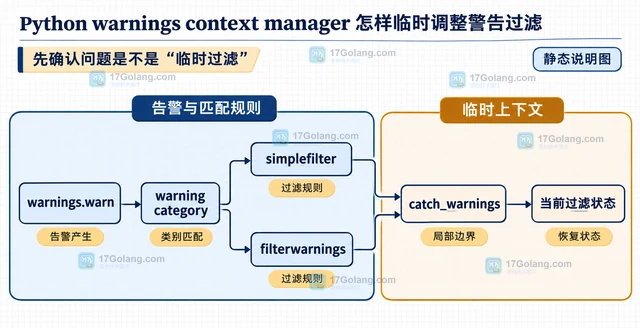
- 文章 · python教程 | 2天前 | 标准库 · Python教程 · Python warnings catch_warnings simplefilter filterwarnings 警告过滤
- Python warnings context manager 怎样临时调整警告过滤
- 255浏览 收藏
-
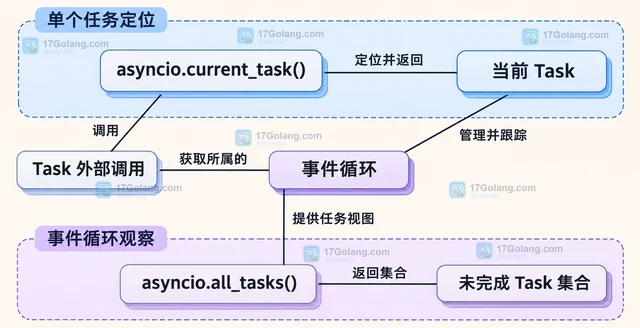
- 文章 · python教程 | 2天前 | 调试 · python · 异步编程 · Python asyncio introspection current_task all_tasks
- Python asyncio introspection 怎样定位当前任务
- 120浏览 收藏
-
- 文章 · python教程 | 2天前 | 标准库 · Python教程 · Python 类型注解 Python 3.14 annotationlib get_annotations ForwardRef 延迟注解
- Python 3.14 annotationlib.get_annotations 怎样读取延迟注解
- 423浏览 收藏
-
- 文章 · python教程 | 2天前 |
- Python 3.14 跨解释器 Queue.put 的阻塞与 QueueFull 处理方案
- 157浏览 收藏
-
- 文章 · python教程 | 3天前 | xml · python · Python xml xml.etree.ElementTree canonicalize C14N
- Python xml.etree.ElementTree.canonicalize 怎样生成稳定的 XML 文本
- 151浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1181次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1166次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1350次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1290次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1150次使用
-
- Python TaskGroup 怎样让子任务失败统一收敛
- 2026-11-12 501浏览
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览